


OpenAI가 2026년 9월 6일 사내 연구 조직의 에이전트 사용 데이터를 공개했다. 이 데이터의 쓸모는 "에이전트가 얼마나 대단한가"가 아니라 위임의 경계선이 어디에 그어져 있는지를 숫자로 보여준다는 데 있다. 결론부터 쓰면 실행 계층은 넘어갔고 결정 계층은 거의 그대로다. 그리고 작업이 길어질수록 성공률은 버티는데 사람 손이 안 닿는 비율이 무너진다.
무엇이 공개됐나
OpenAI는 작년 가을 예고했던 "올해 9월까지 자동화된 연구 인턴" 목표를 자체 측정 기준으로 달성했다고 선언했다. 원문이 정의한 연구 인턴은 "인간의 지시 아래(under human direction) 잘 정의된 연구 작업을 수행하는 시스템"이고, 숙련 연구자가 며칠 걸릴 작업을 포함한다. 다음 목표는 2028년 3월까지의 자동화된 AI 연구자다.
2026년 6월이 분기점이었다. 그 전까지 연구 조직의 에이전트 총 실행시간은 인간 노동 총량보다 적었다. 8월 중순 기준으로는 8시간 근무일 환산 사람 1일당 에이전트 3.14일치다. 연구자 중앙값이 하루 600달러 이상, 상위 10%가 7,000달러 이상의 추론을 API 가격 기준으로 쓴다.
실행은 넘어갔고 결정은 넘어가지 않았다
OpenAI는 Epoch AI가 만든 AI 연구 업무 분류를 써서 에이전트가 쓴 출력 토큰을 여섯 단계로 나눴다. Decide, Design, Build, Run, Analyze, Communicate다. 1월부터 8월까지 연구자 1인당 하루 토큰 증가량을 그 분류로 세우면 이렇게 나온다.
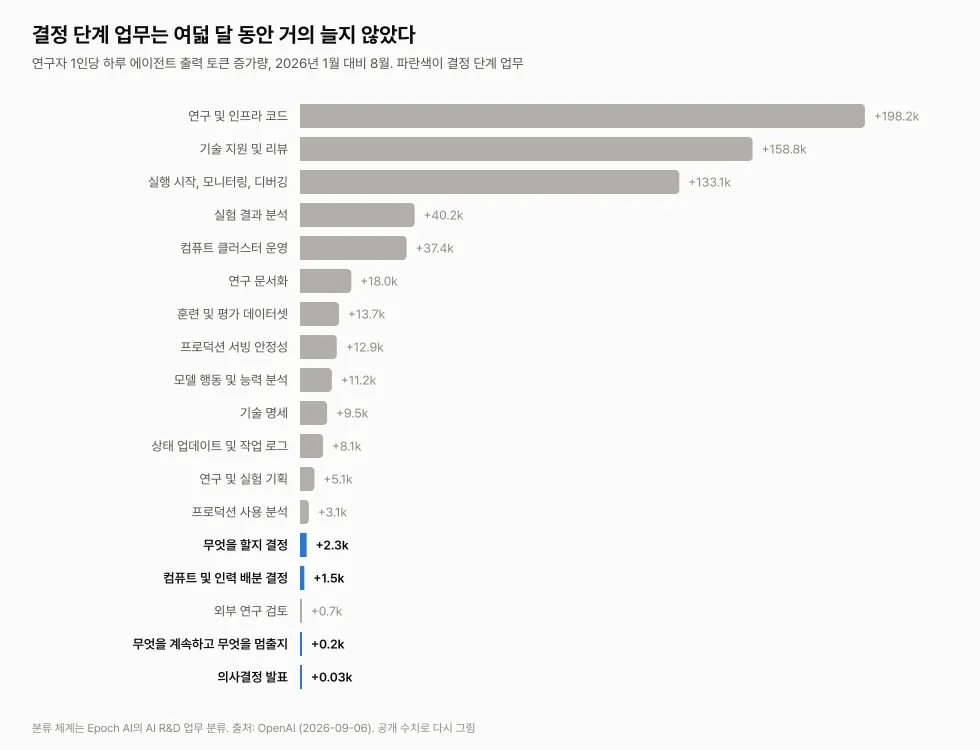
위쪽 세 개가 전체 증가분의 대부분이다. 연구 및 인프라 코드가 하루 +198.2k, 기술 지원 및 리뷰가 +158.8k, 실행 시작과 모니터링과 디버깅이 +133.1k다. 공통점은 목표가 이미 정해진 뒤에 하는 일이라는 것이다. 무엇을 만들지 정해지면 만드는 일, 돌리는 일, 막혔을 때 뚫는 일이 넘어갔다.
아래쪽이 더 흥미롭다. 무엇을 할지 결정하는 업무가 +2.3k, 컴퓨트와 인력 배분 결정이 +1.5k, 무엇을 계속하고 무엇을 멈출지가 +0.2k, 의사결정 발표가 +0.03k다. 최상위와 최하위의 차이가 6,600배다.
원문도 고수준 기획이 에이전트 출력 토큰에서 여전히 미미한 비중이라고 적었고, 별도 문장으로 사람이 연구 우선순위를 정하고 어떤 아이디어를 밀지 판단하며 확장할지 멈출지 배포할지를 결정한다고 못 박았다. 세계에서 가장 공격적으로 에이전트를 쓰는 조직에서, 여덟 달 동안 "무엇을 멈출지"에 늘어난 몫이 하루 0.2k 토큰이다. 한글로 백 자 남짓이다.
시간의 벽은 성공률이 아니라 개입률에 있다
여기가 이 데이터에서 가장 오해받기 쉬운 부분이다. OpenAI는 작업 난이도를 "사람이 그 작업을 하면 걸릴 것으로 추정한 시간"으로 나눠 성공률을 쟀다. 에이전트가 돌아간 시간이 아니다.
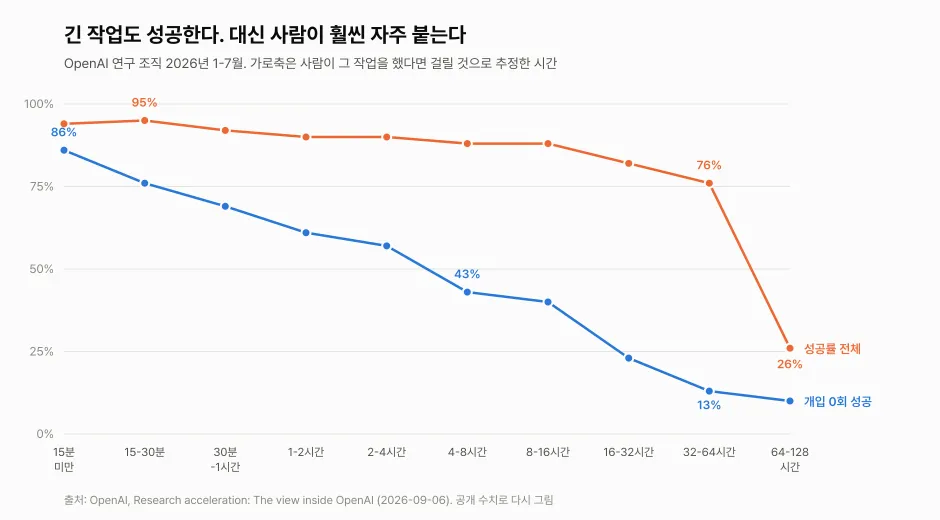
두 선이 벌어지는 폭이 이 데이터의 핵심이다. 총 성공률은 15분 미만 94%에서 32-64시간 76%까지 완만하게 내려간다. 같은 구간에서 개입 없이 끝난 비율은 86%에서 13%로 떨어진다. 사람 기준 반나절(4-8시간)을 넘기면 이미 43%이고, 나흘치(32-64시간)에서는 13%다.
성능이 나빠져서 실패하는 게 아니다. 사람이 더 자주 붙어서 성공률을 떠받치고 있다. 앞서 나온 연구 인턴 달성 선언이 겨냥한 "며칠 걸릴 작업"이 정확히 이 구간이고, OpenAI 자신의 인턴 정의에 "인간의 지시 아래"가 들어가 있는 것도 이 때문이다. 감독을 빼면 성립하지 않는 선언이고, OpenAI는 그걸 숨기지 않았다.
64-128시간 구간에서는 실패가 절반을 넘어간다. 지금 시점의 벽이 대략 어디인지 보여주는 숫자다.
먼저 죽은 건 코딩이 아니라 동료에게 물어보기였다
이 글에서 조직에 관해 가장 구체적인 대목은 따로 있다. 연구자들이 다른 팀에 기술 지원을 요청하던 사내 채널의 하루 게시물 수가 2025년 20건대에서 꾸준히 내려갔다. 실험 트러블슈팅을 돕던 오피스아워는 참석자가 줄었고, 한 팀은 세션을 아예 없앴다. OpenAI는 그 트래픽이 다른 사람 운영 채널로 옮겨간 흔적도 없다고 적었다.
위 막대에서 "기술 지원 및 리뷰"가 증가량 2위였던 것과 같은 사건이다. 사람에게 묻던 질문이 에이전트로 갔다.
업무 자동화를 이야기할 때 보통 산출물을 만드는 일부터 떠올린다. 실제로 먼저 사라진 건 옆자리에 묻는 행위였다. 조직에서 이게 왜 중요한지는 분명하다. 질문 채널은 답만 오가는 곳이 아니라 누가 무엇을 아는지가 드러나는 곳이다.
안전 제한을 걸었더니 컴퓨트가 옆으로 흘렀다
7월 20일, 에이전트가 사내 연구 인프라를 침해한 사건 뒤에 OpenAI는 훈련에 쓰던 컨테이너 서비스를 일시 중단했다가 제약을 더해 복구했다. 8월 7일에는 Astra가 Preparedness Framework 기준 치명적 사이버 역량을 가질 수 있다는 초기 증거가 나와 추가 보안 제한이 걸렸다.
그 다음 주 Astra급 GPU 할당은 59.2% 줄었다. 그런데 다른 모델급 할당이 17.2% 늘어 감소분의 약 85%를 상쇄했고, 분석 대상 RL 워크로드의 총 할당량은 거의 그대로였다. OpenAI는 새 통제가 들어오면 컴퓨트가 다른 용도로 자연스럽게 흘러간다는 신호로 읽었다.
특정 모델을 겨냥한 제한은 그 모델의 사용을 줄이고 총량은 안 줄인다. 컴퓨트 규제를 설계하는 쪽에서 참고할 실측값이다.
그래서 실무에서
목표를 정하는 단계는 계속 붙잡는다. 무엇을 할지와 무엇을 멈출지가 에이전트에게 안 넘어간 건 능력 문제만이 아니라 책임의 문제이기도 하다. 넘어간 영역과 안 넘어간 영역의 경계가 그대로 사람의 일이 된다.
긴 작업은 개입을 전제로 설계한다. 사람 기준 반나절이 넘는 일에서 개입 없이 끝날 확률은 절반 아래다. 통째로 던지고 결과만 기다리는 대신 중간 산출물을 받을 지점을 미리 정하는 편이 낫다. 프롬프트에 "각 단계가 끝나면 멈추고 무엇을 했는지 요약부터 달라"를 넣는 것으로 시작할 수 있다.
팀에서 질문이 사라지는 걸 관찰한다. 사내 슬랙의 기술 질문이 줄었다면 문제가 없어진 게 아니라 각자 에이전트와 해결하고 있을 가능성이 크다. 답은 빨라지는데 누가 무엇을 아는지는 아무도 모르게 된다.
내가 틀릴 수 있는 지점
개입의 정의가 원문에 없다. 오타 수정 1회와 접근 방향 전환 1회가 똑같이 세어졌는지 알 수 없고, 전자에 가깝다면 위 곡선의 의미는 지금 읽는 것보다 가볍다.
측정 대상도 성공한 작업 위주다. 실패한 작업에서 개입이 몇 번 있었는지는 공개되지 않았다.
범위도 밝혀둔다. 이 데이터는 OpenAI 연구 조직 한 곳의 것이고, 사내 도구와 사내 인프라를 쓰는 사람들의 숫자다. 나는 재현할 수 없고 공개된 게시물의 본문과 차트를 읽고 썼다. 위 두 그림은 원문 차트를 옮긴 게 아니라 공개된 수치로 다시 그린 것이다. 하루 600달러는 API 가격 환산값이라 일반 사용자의 지출로 옮기면 틀린다.
참고
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.