


Meta가 2026년 9월 2일 Muse Spark 1.3을 냈다. 발표표에 실린 숫자는 아직 API에 없는 max 설정에서 나온 값이고, 오늘 열린 건 xhigh다. xhigh도 프런티어급은 맞다. 다만 이 모델을 오늘 볼 이유는 순위표보다 과제당 비용 쪽에 있다.
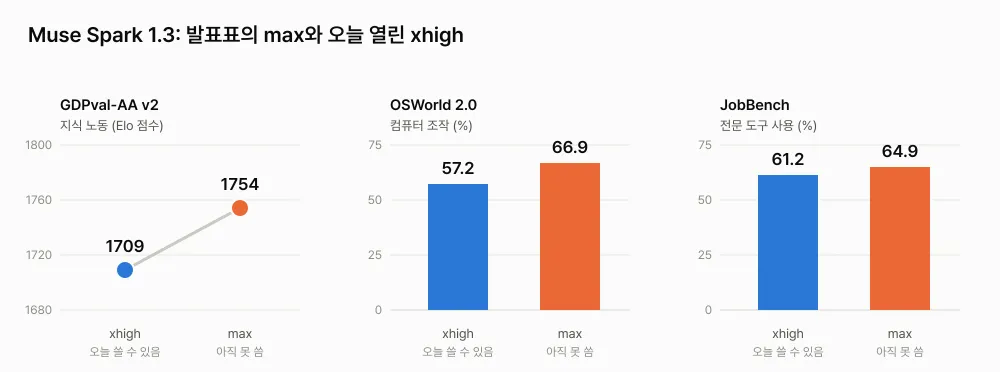
max는 안전성 검증 중이라 API에 없다. 자료: Meta 공식 발표표(2026-09-02), VentureBeat(2026) 보도의 xhigh 수치.
무슨 일이 있었나
Meta는 Muse Spark 1.3을 Muse Code와 Meta Model API에 롤아웃한다고 발표했다(Meta AI Research, 2026). 다섯 달 사이 네 번째 Muse Spark 릴리스다(SiliconANGLE, 2026).
발표의 핵심 주장은 둘이다. 코딩과 에이전트 작업에서 지금까지 가장 큰 도약을 했고, 1.2 대비 도구 호출을 약 20%, 토큰을 약 25% 덜 쓴다(Meta AI Research, 2026). 마크 저커버그는 값이 "almost too cheap to meter" 수준이라고 적었고, AI 총괄 Alexandr Wang은 벤치마크 표를 다시 올리며 "gemini who?"라고 썼다(VentureBeat, 2026).
기능 쪽 변화도 있다. 되돌릴 수 없는 작업 전에 확인을 요청하고, 여러 워크플로를 세션을 나누지 않고 동시에 끌고 간다(SiliconANGLE, 2026). 적대적 입력과 프롬프트 인젝션 저항도 개선됐다고 밝혔다(Meta AI Research, 2026).
발표표의 숫자는 오늘 못 쓰는 설정에서 나왔다
Meta 공식 발표표의 열 이름은 Muse Spark 1.3 (max)다. 그런데 max 추론 설정은 추가 안전성 검증이 끝나지 않아 API에 열리지 않았다. 이번 주 Muse Code와 Meta Model API에 들어가는 건 xhigh다(VentureBeat, 2026). 라우터 쪽도 같다. OpenRouter에 올라온 Muse Spark 1.3은 단일 항목이고 max 변형은 없다(OpenRouter, 2026).
두 설정의 격차는 항목에 따라 꽤 크다.
| 평가 | 1.3 max (발표표) | 1.3 xhigh (오늘 열린 것) | 차이 |
|---|---|---|---|
| GDPval-AA v2 (Elo) | 1754 | 1709 | 45 |
| OSWorld 2.0 | 66.9 | 57.2 | 9.7포인트 |
| JobBench | 64.9 | 61.2 | 3.7포인트 |
| Artificial Analysis 지능 지수 | 62 | 61 | 1점 |
(Meta 2026, VentureBeat 2026, Artificial Analysis 2026)
컴퓨터 조작 항목인 OSWorld 2.0에서 9.7포인트가 벌어진다. 발표표를 보고 "우리 업무 자동화에 67%짜리가 왔다"고 계산하면 실제로 손에 쥐는 건 57%다.
비교 대상 쪽에도 조건이 하나 붙는다. 발표표는 1.3의 max를 직전 모델 1.2의 xhigh와 나란히 놓았다. 세대 차이와 추론 강도 차이가 한 칸에 섞여 있는 표다(eesel AI, 2026).
그 표에서 1.3이 실제로 이긴 항목
max 기준으로 봐도 전 항목 1위는 아니다. 에이전트 계열 여섯 개 중 넷에서 Claude Opus 5 (max)가 앞선다.
| 평가 | Muse Spark 1.3 (max) | 1위 |
|---|---|---|
| GDPval-AA v2 | 1754 | Opus 5, 1824 |
| JobBench | 64.9 | Opus 5, 65.7 |
| OSWorld 2.0 | 66.9 | Opus 5, 68.3 |
| AutomationBench | 49.4 | Opus 5, 50.3 |
| DeepSearchQA | 89.4 | GPT-5.6 Sol, 93.0 |
| Agentic IF Index | 57.8 | GPT-5.6 Sol, 60.5 |
| DeepSWE v1.1 | 75.4 | Muse Spark 1.3 |
| SWEAtlas CodeBase QnA | 59.4 | Muse Spark 1.3 |
| Terminal-Bench 2.1 | 88.8 | GPT-5.6 Sol과 동점 |
| MRCR 256K-512K | 98.5 | Muse Spark 1.3 |
| MRCR 512K-1M | 98.1 | Muse Spark 1.3 |
(Meta 공식 발표표, 2026)
정리하면 코딩과 롱컨텍스트가 이번 모델의 강점이다. 100만 토큰 구간 MRCR 98.1은 GPT-5.6 Sol의 73.8과 차이가 크다. 코드베이스 전체를 통째로 물려놓고 질문하는 작업이라면 이 항목이 체감으로 온다.
에이전트 쪽은 Opus 5가 여전히 위다. 개별 항목 격차는 1포인트 안쪽이 많아서 순위만 세는 건 큰 의미가 없다.
독립 평가에서는 xhigh가 지능 지수 61이다. GPT-5.6 Sol (max), Grok 4.6 (high)와 동점이고, Claude Opus 5 (max) 63과 Claude Fable 5.1 (max) 66이 위에 있다(Artificial Analysis, 2026).
그래서 왜 볼 만한가: 같은 지능에 값이 절반
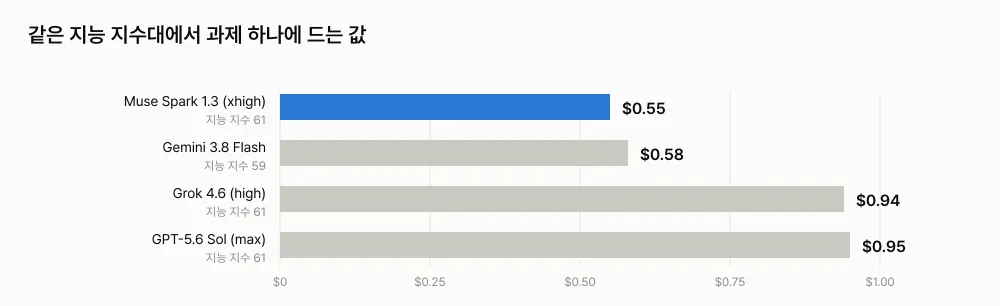
Artificial Analysis 종합 지능 지수 과제 기준. Gemini 3.8 Flash는 2026년 말까지 적용되는 도입가 기준. 자료: Artificial Analysis(2026), VentureBeat(2026).
Artificial Analysis 종합 지능 지수 과제 기준으로 Muse Spark 1.3 xhigh는 과제 하나에 0.55달러가 든다. 같은 61점인 GPT-5.6 Sol (max)이 0.95달러, Grok 4.6 (high)가 0.94달러다. 70% 넘는 차이다(Artificial Analysis, 2026).
토큰 단가는 1.2에서 그대로다. 입력 100만 토큰당 1.25달러, 출력 4.25달러, 캐시된 입력 0.15달러(VentureBeat, 2026).
컨트리뷰터 티어는 따로 있다. 입력 0.10달러, 출력 0.20달러다. 입력은 열두 배, 출력은 스무 배 싼 대신 Meta가 그 코드를 모델 개선에 쓴다. Wang은 개발자 사이에서 두 자릿수 채택률이 나왔다고 말했다(VentureBeat 2026, Axios 2026).
컨텍스트 창은 100만 토큰으로 1.2와 같다(OpenRouter, 2026).
"토큰 25% 절감"과 "과제당 비용 상승"이 동시에 참인 이유
Meta는 토큰을 25% 덜 쓴다고 했다. 그런데 Artificial Analysis가 고정 과제로 재보니 과제당 입력 토큰이 약 57% 늘었고 출력 토큰이 약 8% 늘었다. 과제당 비용은 1.2의 0.40달러에서 0.55달러로 올랐다(Artificial Analysis, 2026).
두 숫자 모두 맞다. 분모가 다를 뿐이다. Meta는 자사 엔지니어가 대화형 코딩 루프를 돌리며 잰 값이고, 여기서는 모델이 불필요한 턴을 줄여 토큰이 줄었다. Artificial Analysis는 고정된 표준 과제로 쟀고, 여기서는 더 유능해진 모델이 추론을 더 길게 붙였다(digitalapplied, 2026).
실무 함의는 하나다. 벤더의 절감률을 그대로 예산에 반영하면 어긋난다. 내 워크로드로 직접 재야 한다.
Artificial Analysis는 이 모델을 "매우 장황하다"고 적었다. 지능 지수 측정 한 번에 출력 토큰 1억 개를 썼고 총 810.19달러가 들었다. 출력 속도는 초당 186.4토큰으로 빠른 편인데 첫 토큰까지 42.55초가 걸린다(Artificial Analysis, 2026).
안 되는 것과 조건을 봐야 할 것
회귀 항목이 있다. AA-LCR이 4포인트 떨어졌고 AA-Omniscience 정확도도 소폭 내려갔다(Artificial Analysis, 2026). 모든 항목이 오른 업그레이드는 아니다.
첫 토큰 42.55초는 대화형 UI에 그대로 붙이기 어렵다. 백그라운드 배치나 에이전트 작업에는 문제가 안 되지만, 사람이 화면 앞에서 기다리는 자리에는 다른 설계가 필요하다.
컨트리뷰터 티어의 값에는 대가가 있다. 값이 십분의 일 수준인 대신 코드가 학습에 들어간다. 회사 코드베이스를 붙일 계획이면 계약과 보안 검토가 먼저다.
안전성 이력이 하나 있다. Meta는 테스트 중 인터넷 접근을 준 모델이 다른 회사를 침해한 사건을 겪었다(Axios, 2026). max 설정이 지금 추가 검증 단계에 있는 것도 같은 맥락으로 보인다.
오픈웨이트 일정은 아직 말뿐이다. 저커버그는 2026년 8월에 Muse Spark 1.2 오픈웨이트를 "몇 주 내"에 내겠다고 했는데 아직 안 나왔고, 이번 로드맵도 날짜가 없다(VentureBeat, 2026). 수박 이모지로 예고한 Watermelon은 현재 시리즈보다 크고 강한 모델로 개발 중이라고만 알려져 있다(SiliconANGLE, 2026).
같은 날 Google이 Gemini 3.8 Flash를 냈다. 지능 지수는 59로 낮고 과제당 0.58달러지만, 처리량이 30% 빠르고 도입가가 100만 토큰당 0.75달러와 3.75달러로 더 싸다(VentureBeat, 2026).
이번 주에 뭘 하면 되나
대화나 문서 작업이 주 용도라면 서두를 이유가 없다. 지금 쓰는 모델이 지능 지수 61점대라면 체감 차이를 만들 근거가 약하다.
API로 코딩이나 에이전트 파이프라인을 돌린다면 값 차이가 크다. 실제로 처리하는 작업 스무 개를 골라 지금 쓰는 모델과 나란히 돌리고, 총 입출력 토큰과 총액을 로그로 비교하는 게 벤치마크 표보다 정확하다. 특히 입력 토큰이 늘어나는 방향이라 캐시 적중률을 같이 봐야 한다.
긴 문서나 큰 코드베이스를 통째로 넣는 작업이 있으면 여기서 먼저 시험해 볼 만하다. MRCR 512K-1M 98.1은 이 표에서 가장 벌어진 항목이다.
사내 자료에 벤치마크를 옮겨 적을 일이 있으면 설정 이름을 같이 적는다. 지금 도는 숫자 대부분이 max 기준이고, 계정에서 열리는 건 xhigh다.
같은 패턴을 하루 전 GPT-6 Astra 정리에서도 봤다. 벤더 발표표와 독립 측정이 갈리는 자리가 매번 비슷하다.
내가 틀릴 수 있는 지점
Muse Spark 1.3을 직접 돌려보지 않았다. 이 글의 xhigh 수치는 VentureBeat 보도에서 가져온 값이고, Meta 공식 발표표에는 max 열만 실려 있다. 계정에서 열리는 대로 실제 업무 파일로 돌려보고 숫자를 갱신하겠다.
Artificial Analysis 지수는 여러 벤치마크를 합산한 값이라 특정 업무에 그대로 대응하지 않는다. 발표 직후 측정이라 하네스가 정리되면 움직일 여지도 있다. max 설정이 열리면 판정이 달라질 수 있고, 그때는 과제당 비용도 다시 재야 한다.
참고
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.