


OpenAI가 2026년 9월 3일 GPT-6 Astra를 공개했다. OpenAI 발표표에서는 모든 항목 1위인데, 독립 평가 기관인 Artificial Analysis의 종합 지능 지수에서는 직전 모델 GPT-5.6 Sol과 61점으로 동점이다. 값은 2.5배 올랐다. 실질적으로 좋아진 건 토큰 효율과 환각률 두 가지다.
지금 내 계정에서 쓸 수 있나
오늘은 대부분 못 쓴다. OpenAI 공식 발표(2026-09-03)는 출시 시점에 일부 조직에만 열고, ChatGPT Plus/Pro/Business/Enterprise와 API, AWS 고객에게는 "향후 며칠 내"에 확대한다고 적었다. 구체적인 날짜나 시각은 발표에 없다.
Enterprise 플랜은 한 단계가 더 있다. 기본값이 꺼짐이고 관리자가 켜야 쓸 수 있다(OpenAI, 2026). 회사 계정으로 기다리는 중이라면 사내 관리자 쪽에 먼저 물어볼 일이다.
Codex 쪽은 긴 컨텍스트 노트 기능이 config.toml로 켜는 실험 기능으로 먼저 들어갔고 몇 주 뒤 기본값이 된다(OpenAI, 2026). 컴퓨터 조작 성능을 제대로 보려면 ChatGPT 데스크톱 앱을 쓰라는 안내도 있다.
독립 평가에서는 순위가 달라진다
벤더 발표표와 제3자 측정을 나란히 놓으면 그림이 바뀐다.
| 지표 | GPT-6 Astra | 비교 대상 | 측정 조건 |
|---|---|---|---|
| Intelligence Index | 61 | GPT-5.6 Sol 61 / Claude Fable 5.1 66 | max 설정 |
| Coding Agent Index | 67 | Claude Fable 5.1 70 / Opus 5, Muse Spark 1.3 67 부근 | Astra는 Codex, Claude는 Claude Code 하네스 |
| AA-Omniscience 환각률 | 51% | GPT-5.6 Sol 92% | max 설정, 낮을수록 좋음 |
| 토큰 사용량 | Sol의 1/3 | Opus 5 xhigh의 1/5 | Coding Agent Index 기준 |
| 과제당 비용 | Sol 대비 +75% | - | Intelligence Index, max 설정 |
| ARC-AGI-3 | 62.7% | 측정 비용 $26,098 | 표준 하네스 |
| ARC-AGI-3 | 99.9% | 측정 비용 $18,817 | 프로바이더 어댑터 하네스 |
(Artificial Analysis 2026, ARC Prize 2026)
Artificial Analysis의 Intelligence Index에서 Astra는 61점이다. GPT-5.6 Sol도 61점이고, Claude Fable 5.1이 66점으로 위에 있다(Artificial Analysis, 2026). 여러 벤치마크를 합산한 지수라 개별 과제 성능과 다를 수 있다는 단서는 붙지만, 종합 지능이 세대를 건너뛰며 올랐다는 서사와는 맞지 않는 숫자다.
에이전트 코딩 쪽도 1위가 아니다. Coding Agent Index에서 Astra는 Codex 하네스로 67점, Claude Fable 5.1이 Claude Code 하네스로 70점이다.
토큰 효율은 진짜다. 같은 Coding Agent Index에서 Astra는 Sol max 대비 3분의 1, Claude Opus 5 xhigh 대비 5분의 1의 토큰으로 같은 점수를 냈다. 약 70% 효율 개선이다(Artificial Analysis, 2026). 그런데 단가가 2.5배라 상쇄되지 않는다. Intelligence Index 기준 과제당 비용은 Sol 대비 75% 더 든다.
환각률 개선도 진짜다. AA-Omniscience에서 max 설정 기준 51%로, Sol의 92%에서 크게 내려왔다(Artificial Analysis, 2026). OpenAI 자체 환각 벤치마크의 2.0% 대 9.4%와는 절대 수치가 전혀 다르지만 방향은 같다. 사실 확인이 중요한 업무라면 이 항목이 이번 세대의 핵심 변화다.
ARC-AGI-3에는 숫자가 세 개 돈다
벤치마크를 만든 ARC Prize가 직접 두 숫자를 공개했다. 표준 하네스에서 62.7%, 프로바이더 어댑터 하네스에서 99.9%다(ARC Prize, 2026).
차이는 상태 관리 방식이다. 표준 하네스에서 모델은 사람이 메모하듯 눈에 보이는 메모를 직접 적어 게임 상태를 추적한다. 프로바이더 어댑터는 OpenAI 내장 컨텍스트 관리를 써서 불투명한 추론 상태를 보이지 않게 보존하고 긴 세션에서는 압축한다. 같은 모델이 같은 문제를 푸는데 배선이 다르다.
측정 비용도 공개됐다. 표준 하네스 2만 6,098달러, 프로바이더 어댑터 1만 8,817달러다. 두 하네스가 모두 푼 167개 게임 기준으로 어댑터 쪽이 약 3.66배 빨랐고 토큰을 49% 덜 썼다(ARC Prize, 2026).
여기에 세 번째 숫자가 붙는다. OpenAI 발표표는 같은 벤치마크를 각주를 단 98.6%로 적었다(OpenAI, 2026). 하나의 벤치마크에 62.7%, 98.6%, 99.9%가 동시에 도는 상태다. 인용할 거라면 어느 측정인지를 같이 적는 편이 정확하다.
가격: 직전 모델의 2.5배
입력 100만 토큰당 10달러, 출력 100만 토큰당 50달러다. 캐시된 입력은 1달러, 캐시 쓰기는 12.5달러(OpenAI API 문서, 2026).
| 모델 | 입력 | 출력 | 캐시 읽기 |
|---|---|---|---|
| GPT-6 Astra | $10.00 | $50.00 | $1.00 |
| GPT-5.6 Sol | $4.00 | $20.00 | - |
| GPT-5.6 Terra | $2.00 | $12.00 | - |
| Claude Fable 5.1 | $10.00 | $50.00 | $0.25 |
| Claude Opus 5 | $5.00 | $25.00 | $0.50 |
| Claude Sonnet 5 | $2.00 | $10.00 | $0.20 |
| Gemini 3.8 Flash | $0.75 | $3.75 | - |
(100만 토큰당 달러. Gemini 3.8 Flash는 2026년 12월 31일까지 도입가이고 2027년 1월 1일부터 $1.50 / $7.50이 된다.)
Sol에서 Astra로 넘어가면 입력과 출력이 정확히 2.5배씩 오른다. Claude Fable 5.1과는 기본 단가가 같지만 캐시 읽기에서 갈린다. Astra 1달러, Fable 5.1 0.25달러로 네 배 차이다(Anthropic 가격표, 2026). 같은 프롬프트를 반복해 때리는 에이전트 워크로드에서는 이 항목이 총액을 지배한다.
조건도 하나 붙는다. 프롬프트가 27만 2천 토큰을 넘으면 입력과 캐시가 2배, 출력이 1.5배로 뛴다. 100만 토큰 컨텍스트의 진짜 단가는 표에 적힌 10달러가 아니다. Batch와 Flex는 절반, Fast 모드는 2배 요금에 최대 2.5배 속도다(OpenAI, 2026).
스펙에서 실무에 영향을 주는 것
OpenAI API 문서(2026) 기준 컨텍스트 창은 105만 토큰, 최대 출력은 12만 8천 토큰, 지식 컷오프는 2026년 4월 30일이다.
긴 컨텍스트가 숫자만 큰 게 아니라는 근거는 나왔다. MRCR v2 검색 과제에서 25만 6천에서 51만 2천 토큰 구간 100%, 51만 2천에서 100만 토큰 구간 96.3%를 기록했다. 같은 구간에서 Sol은 91.5%와 73.8%였다(OpenAI, 2026).
입력은 텍스트와 이미지, 출력은 텍스트뿐이다. 오디오와 비디오는 지원하지 않고 파인튜닝도 안 된다. 추론 강도는 low, medium, high, xhigh, max 다섯 단계다.
벤더 발표표에서 좋아 보이는 것
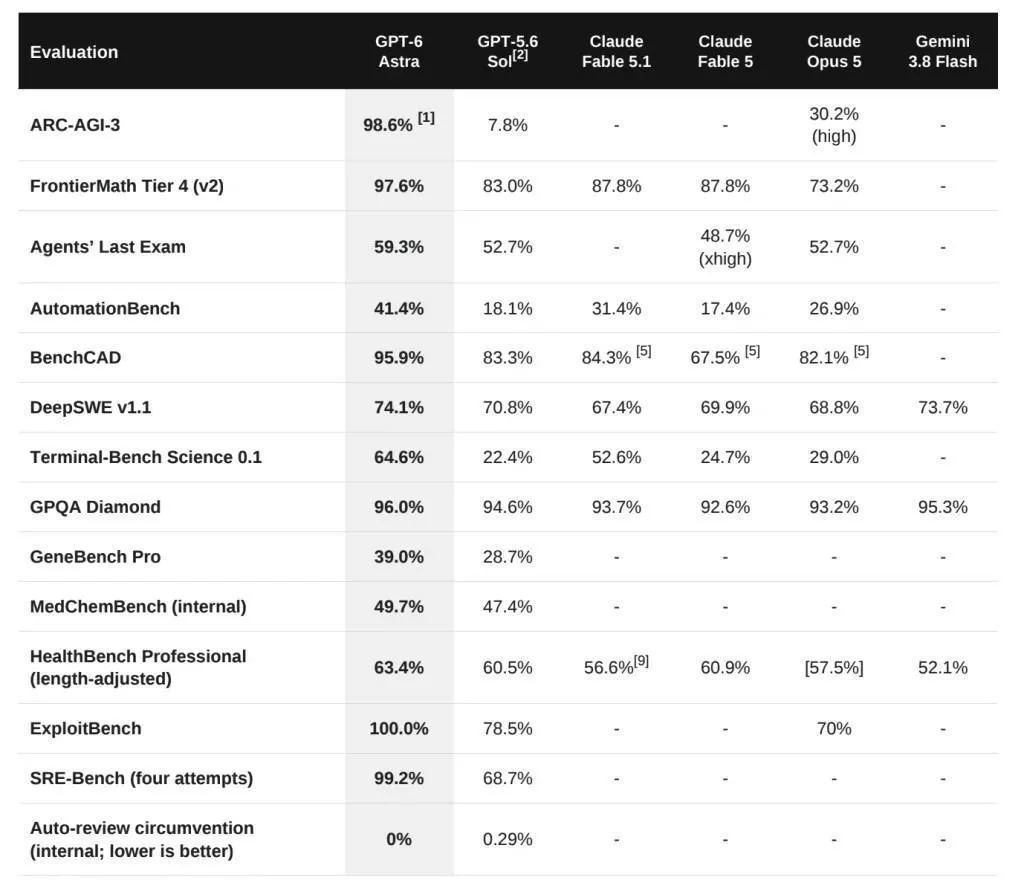
OpenAI가 발표 페이지에 올린 비교표는 이렇다.
| 평가 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| ARC-AGI-3 | 98.6% | 7.8% | - | 30.2% (high) | - |
| FrontierMath Tier 4 (v2) | 97.6% | 83.0% | 87.8% | 73.2% | - |
| Agents' Last Exam | 59.3% | 52.7% | - | 52.7% | - |
| AutomationBench | 41.4% | 18.1% | 31.4% | 26.9% | - |
| BenchCAD | 95.9% | 83.3% | 84.3% | 82.1% | - |
| DeepSWE v1.1 | 74.1% | 70.8% | 67.4% | 68.8% | 73.7% |
| Terminal-Bench Science 0.1 | 64.6% | 22.4% | 52.6% | 29.0% | - |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 93.2% | 95.3% |
| GeneBench Pro | 39.0% | 28.7% | - | - | - |
| MedChemBench (내부) | 49.7% | 47.4% | - | - | - |
| HealthBench Professional | 63.4% | 60.5% | 56.6% | 57.5% | 52.1% |
| ExploitBench | 100.0% | 78.5% | - | 70% | - |
| SRE-Bench (4회 시도) | 99.2% | 68.7% | - | - | - |
| 자동 검토 우회 (내부, 낮을수록 좋음) | 0% | 0.29% | - | - | - |
(OpenAI, 2026. 원표에 있던 Claude Fable 5 열은 가독성을 위해 뺐다. Agents' Last Exam의 Fable 5는 48.7%(xhigh)였다.)
숫자만 보면 전 항목 1위다. 그런데 격차의 크기가 항목마다 전혀 다르다. GPQA Diamond는 96.0% 대 Gemini 3.8 Flash 95.3%로 0.7포인트, DeepSWE는 74.1% 대 73.7%로 0.4포인트다. 반면 Terminal-Bench Science는 64.6% 대 22.4%로 42포인트가 벌어진다. 1위라는 말 하나로 뭉뚱그릴 수 있는 표가 아니다.
컴퓨터 조작 속도는 이번 발표의 중심이다. OSWorld 2.0에서 72.6%로 Sol의 65.7%를 넘었고, 작업당 시간이 75분에서 40분으로 줄었다. Mind2Web에서는 Sol 대비 1.9배 빠르게 끝냈다(OpenAI, 2026).
화면 요소를 찍는 정확도가 특히 올랐다. ScreenSpot-Pro에서 92.7%로 Sol 76.9%, Claude Fable 5.1의 87.3%보다 높다(OpenAI, 2026). 컴퓨터 조작 에이전트가 엉뚱한 버튼을 누르던 실패가 줄었다는 뜻이다.
소수 간격 문제의 상한을 246에서 186으로 낮추는 데 기여했다는 사례도 함께 실렸다.
두 벤더 표를 겹쳐 보면 순위가 갈린다
위 표만 보면 Astra가 전 항목 1위다. 그런데 그 표에 무엇을 싣고 무엇을 뺄지는 OpenAI가 정한다. 같은 시기 Google DeepMind가 낸 Gemini 3.8 Flash 비교표(2026)에는 OpenAI 발표 페이지에 없는 항목이 있다. GDPVal-AA v2 지식 노동 평가에서 Claude Opus 5가 1824 Elo로 Sol의 1710을 크게 앞서고, Harvey의 법률 에이전트 벤치마크에서는 Gemini 3.8 Flash가 10.0%로 Opus 5의 6.7%와 Sol의 2.5%를 앞선다. 두 항목 모두 OpenAI 페이지에는 Astra 점수가 없다.
더 큰 문제는 두 표가 같은 경쟁 모델에 다른 점수를 매긴다는 것이다. DeepSWE v1.1이 그 예다.
| 모델 | OpenAI 발표표 | Google 발표표 |
|---|---|---|
| GPT-6 Astra | 74.1% | (없음) |
| GPT-5.6 Sol | 70.8% | 72.7% |
| Claude Opus 5 | 68.8% | 74.0% |
| Gemini 3.8 Flash | 73.7% | 73.7% |
Gemini 3.8 Flash만 두 표에서 일치한다. Claude Opus 5는 5.2포인트 차이가 난다. Astra와 Opus 5의 격차가 5.3포인트냐 0.1포인트냐가 표를 만든 회사에 따라 갈린다는 뜻이다. 자기 모델 점수는 자기가 재고, 남의 모델 점수는 각자 다르게 잰다.
같은 패턴을 Grok 4.6 리뷰에서도 다룬 적이 있다. 런치 포스트의 표는 이기는 항목만 남긴다.
표를 가로질러 비교할 때는 조건을 봐야 한다. OSWorld 2.0이 그 예다. OpenAI 표에서 Sol은 65.7%인데 Google 표에서는 62.6%다. Google 문서는 이 항목에 배치 툴 호출을 켜고 3회 실행 중 최고값을 부분 점수로 적었다고 밝혔고, 비 Gemini 모델 점수는 전부 각 제공사가 자체 보고한 값이라고 명시했다(Google DeepMind, 2026). 같은 표에서 Claude Opus 5가 75.4%로 Astra의 72.6%보다 높게 나오지만 조건이 다르므로 그대로 겹쳐 읽으면 안 된다.
안 되는 것과 조건을 봐야 할 것
실무 자동화 절대 점수는 아직 낮다. AutomationBench에서 41.4%다. Sol 18.1%, Fable 5.1의 31.4%보다 높긴 해도 열 개 중 여섯 개는 여전히 실패한다. 내부 디자인 과제 50.0%, 내부 데이터 사이언스 과제 40.9%, GeneBench Pro 39.0%, MedChemBench 49.7%도 같은 그림이다(OpenAI, 2026). 사람 검수 없이 맡길 수 있는 구간은 아직 아니다.
사이버보안 100%는 벤치마크를 구분해서 읽어야 한다. ExploitBench 100%(Sol 78.5%, Claude Opus 5 70%)와 ExploitGym 42.4%(Sol 30.3%, Fable 5.1 30.4%)는 다른 시험이다(OpenAI, 2026). 발표 당일 Fortune 기사가 ExploitGym을 100%로 적었는데 공식 표와 대조하면 ExploitBench 수치를 옮긴 것으로 보인다. 더 중요한 건 2026년 6월부터 8월 사이 신규 문제로 다시 잰 ExploitBench에서 39.0%라는 점이다. Sol의 5.5%보다는 크게 높아도 100%와는 거리가 멀다.
지난달 출시가 늦춰진다던 Astra의 배경이 사이버보안 역량이었던 걸 감안하면, 이번 발표에서 이 항목의 조건이 가장 촘촘한 것도 자연스럽다.
FrontierMath Tier 4 v2의 97.6%에는 이해 상충 이력이 붙는다. The New Stack 2026년 보도는 이 벤치마크 운영에 OpenAI 자금이 들어갔고 독점 접근이 있었다고 적었다.
고급 사이버보안 작업은 거부한다. OpenAI는 개념 증명 익스플로잇 작성 같은 요청을 Astra가 거부한다고 명시했다(OpenAI, 2026). 방어 워크플로에서 제약을 풀어주는 Daybreak 프로그램은 아직 확대 전이다.
안전 검사가 정상 작업을 끊을 수 있다. OpenAI가 직접 "추가 안전 검사가 정당한 작업을 늦추거나 멈출 수 있다"고 적었다. API 작업은 플래그가 걸리면 중단되고, ChatGPT와 Codex 작업은 사용자에게 검토를 요청한다(OpenAI, 2026). 무인 자동화 파이프라인에 넣을 계획이라면 이 중단 처리를 먼저 설계해야 한다.
모니터링이 어려워졌다는 건 OpenAI도 인정했다. Astra의 서술적 추론이 Sol보다 감시하기 어렵고, 단계를 덜 거치며 푸는 탓에 눈에 보이는 흔적이 줄었다는 설명이다(OpenAI, 2026). Jakub Pachocki는 이 모델들을 감시하는 능력을 강화해야 한다고 말했다(Axios, 2026). 정렬 지표가 좋아진 것과 감시 가능성이 나빠진 것이 같은 발표에 함께 들어 있다.
그래서 이번 주에 뭘 하면 되나
일반 대화나 문서 작업이 주 용도라면 서두를 이유가 없다. 종합 지능 지수가 Sol과 동점이고 값은 2.5배다. 접근이 열려도 기본 모델을 바꿀 근거는 약하다.
사실 확인이 중요한 업무라면 얘기가 다르다. 환각률이 AA-Omniscience 기준 92%에서 51%로 내려온 게 이번 세대에서 가장 큰 실질 변화다. 리서치나 요약 파이프라인을 돌린다면 같은 프롬프트로 Sol과 나란히 돌려 오답률을 직접 세보는 게 낫다.
API를 붙일 계획이면 두 가지를 먼저 계산한다. 프롬프트를 27만 2천 토큰 아래로 유지할 수 있는지, 그리고 캐시 읽기 비중이 얼마나 되는지다. 토큰을 3분의 1로 줄여도 단가가 2.5배면 총액이 어디로 가는지는 실제 로그로만 알 수 있다.
컴퓨터 조작을 실무에 넣을 거라면 AutomationBench 41.4%를 기준선으로 잡고 검수 단계를 설계한다. 반복 사무 작업 열 개를 골라 사람이 결과를 확인하는 구조로 돌려보는 편이 발표 자료보다 정확하다.
내가 틀릴 수 있는 지점
이 글의 숫자는 OpenAI 공식 발표 페이지와 API 문서, Artificial Analysis와 ARC Prize의 독립 측정, Google DeepMind와 Anthropic의 공식 문서에서 가져왔다. Astra를 직접 돌려보지 않았다. 접근 권한이 열리는 대로 실제 업무 파일로 돌려보고 숫자를 갱신하겠다.
Artificial Analysis 지수는 여러 벤치마크를 합산한 값이라 특정 업무에 그대로 대응하지 않는다. 종합 지수가 동점이어도 내 워크로드에서는 크게 나을 수 있고 그 반대도 가능하다. 발표 직후 측정이라 하네스가 정리되면 숫자가 움직일 여지도 있다.
참고
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.