


구글이 2026년 9월 2일 제미나이 3.8 플래시를 공개했다. DeepSWE v1.1 에서 73.7% 로 Claude Opus 5(74.0%)에 0.3%p 차까지 붙었고 가격은 6분의 1이다. 다만 범용 에이전트 능력을 재는 항목에서는 격차가 그대로 남았다.
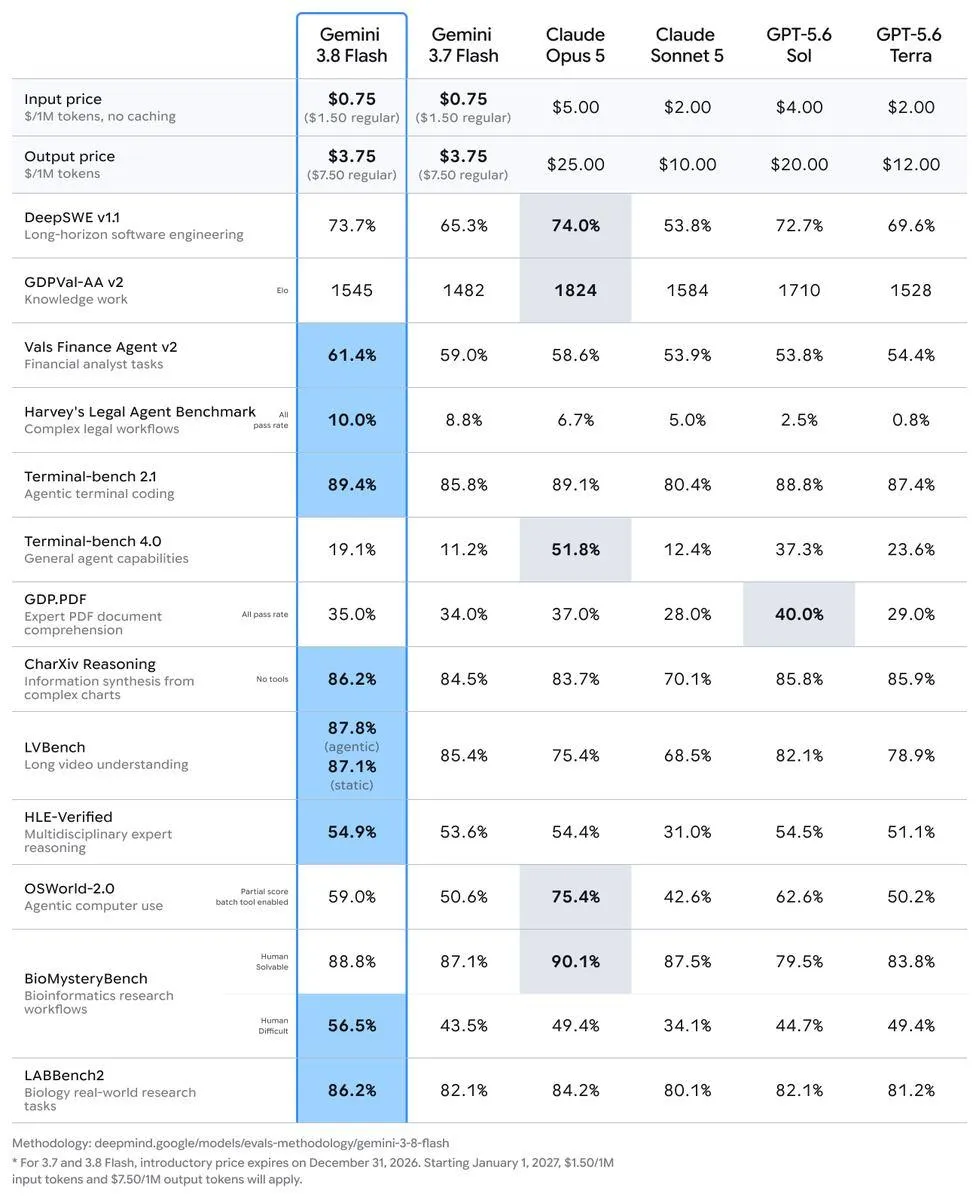
아래 수치는 전부 구글이 발표한 자체 벤치마크 표다. 벤더 자체 측정이라는 점을 감안하고 읽어야 한다 (Google DeepMind, 2026).
무엇이 나왔나
모델 두 개다. 범용 모델인 제미나이 3.8 플래시, 그리고 보안 작업 전용인 제미나이 3.8 플래시 사이버. 구글은 두 모델 모두 "장시간 실행되는 에이전트 루프"로 모델 자신을 반복 평가하고 다듬는 방식으로 훈련했다고 밝혔다 (Google 블로그, 2026).
구글이 강조한 변화는 성능 수치보다 태도 쪽이다. 같은 문제에 추론 단계를 더 밟고 툴을 반복 호출한다는 것. 구글 표현을 빌리면 "더 부지런해졌다" (Google 블로그, 2026). 벤치마크 한 줄로 요약되지 않는 종류의 개선이라 실사용에서 갈릴 여지가 크다.
가격이 이 발표의 본체다
입력 100만 토큰당 0.75달러, 출력 100만 토큰당 3.75달러. 3.7 플래시와 같은 금액이다. 경쟁 모델과 나란히 놓으면 왜 이게 뉴스인지 보인다.
| 모델 | 입력 $/1M | 출력 $/1M | DeepSWE v1.1 |
|---|---|---|---|
| Gemini 3.8 Flash | 0.75 | 3.75 | 73.7% |
| Gemini 3.7 Flash | 0.75 | 3.75 | 65.3% |
| Claude Opus 5 | 5.00 | 25.00 | 74.0% |
| Claude Sonnet 5 | 2.00 | 10.00 | 53.8% |
| GPT-5.6 Sol | 4.00 | 20.00 | 72.7% |
| GPT-5.6 Terra | 2.00 | 12.00 | 69.6% |
출처는 구글 딥마인드 벤치마크 표 (2026), 캐싱 미적용 기준.
Opus 5 는 입출력 모두 3.8 플래시의 6.7배 가격이다. 그 값을 치르고 얻는 DeepSWE 우위가 0.3%p. GPT-5.6 Sol 은 5.3배 가격에 점수가 오히려 1.0%p 낮다.
전 세대와의 비교도 짚어둘 만하다. 같은 가격에 DeepSWE 가 65.3%에서 73.7%로 8.4%p 올랐다. 3주 사이에 벌어진 일이다.
12월 31일이 진짜 마감이다
이 가격은 도입가다. 2027년 1월 1일부터 입력 1.50달러, 출력 7.50달러로 두 배가 된다 (Google DeepMind, 2026).
정가 기준으로 다시 계산해도 Opus 5 대비 3.3배 저렴하니 논지가 뒤집히지는 않는다. 다만 지금 원가표를 만든다면 도입가와 정가 두 벌을 만들어 두는 편이 낫다. 3.7 플래시에도 같은 만료일이 걸려 있어서 버전을 안 올려도 청구서는 오른다.
어디서 이기고 어디서 지나
구글 표는 14개 항목을 담았다. 이기는 쪽과 지는 쪽의 성격이 뚜렷하게 갈린다.
이기는 쪽: 정의된 도메인 안의 에이전트 작업
| 벤치마크 | 3.8 Flash | 3.7 Flash | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-bench 2.1 (터미널 코딩) | 89.4% | 85.8% | 89.1% | 88.8% |
| Vals Finance Agent v2 (금융 분석) | 61.4% | 59.0% | 58.6% | 53.8% |
| Harvey 법률 에이전트 | 10.0% | 8.8% | 6.7% | 2.5% |
| CharXiv Reasoning (차트 해석) | 86.2% | 84.5% | 83.7% | 85.8% |
| LVBench (장편 영상 이해) | 87.8% | 85.4% | 75.4% | 82.1% |
| LABBench2 (생물학 연구) | 86.2% | 82.1% | 84.2% | 82.1% |
| BioMysteryBench (고난도) | 56.5% | 43.5% | 49.4% | 44.7% |
| HLE-Verified (전문가 추론) | 54.9% | 53.6% | 54.4% | 54.5% |
출처는 구글 딥마인드 모델 페이지 (2026).
Harvey 법률 에이전트 항목을 그냥 넘기면 안 된다. 1위가 10.0%다. 이 벤치마크에서는 모든 모델이 아직 거의 못 푼다는 뜻이고 순위표로 읽을 단계가 아니다.
HLE-Verified 도 비슷하다. 54.9%와 54.5%와 54.4%가 나란히 있다. 0.5%p 차이를 성능 우위로 파는 건 무리다. 세 모델이 같은 수준이고 실제 차이는 가격에서 난다.
반면 LVBench 87.8% 대 Opus 5 75.4%, BioMysteryBench 고난도 56.5% 대 49.4%는 격차가 크다. 영상과 과학 도메인은 확실히 앞선다.
지는 쪽: 열린 환경의 범용 에이전트
| 벤치마크 | 3.8 Flash | 3.7 Flash | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-bench 4.0 (범용 에이전트) | 19.1% | 11.2% | 51.8% | 37.3% |
| OSWorld-2.0 (컴퓨터 조작) | 59.0% | 50.6% | 75.4% | 62.6% |
| GDPVal-AA v2 (지식 노동, Elo) | 1545 | 1482 | 1824 | 1710 |
| GDP.PDF (전문 문서 이해) | 35.0% | 34.0% | 37.0% | 40.0% |
Terminal-bench 4.0 은 격차가 2.7배다. 51.8% 대 19.1%. 같은 이름의 2.1 버전에서는 3.8 플래시가 1위였는데 4.0 에서는 밑에서 두 번째다. 두 버전이 재는 게 다르다는 뜻이다. 2.1 은 터미널 코딩, 4.0 은 범용 에이전트 능력으로 표기돼 있다.
GDPVal-AA v2 의 279 Elo 차이도 작지 않다. 지식 노동 전반을 재는 항목이다.
정리하면 이렇다. 문제의 형태가 정해져 있고 도구가 명확할 때 3.8 플래시는 6배 비싼 모델과 대등하거나 앞선다. 문제가 열려 있고 무엇을 할지부터 정해야 할 때는 뒤진다.
3.7 플래시 대비로는 두 영역 모두 올랐다. Terminal-bench 4.0 이 11.2%에서 19.1%, OSWorld 가 50.6%에서 59.0%. 방향은 맞는데 절대 수준이 아직이다.
DeepSWE v1.1: 65.3%에서 73.7%로
장기 소프트웨어 엔지니어링을 재는 DeepSWE v1.1 에서 3.8 플래시는 73.7%다. 3.7 플래시가 65.3%였으니 8.4%p 올랐다. Claude Opus 5 가 74.0%로 근소하게 위에 있고 GPT-5.6 Sol 은 72.7%로 아래다 (Google DeepMind, 2026).
출시 당일 일부 매체가 3.8 플래시의 점수를 71.0%로 보도했다. 구글 표 기준으로는 73.7%이고 65.3%는 3.7 플래시 값이다. 구글 공식 블로그 본문에 숫자가 없고 차트만 실린 탓으로 보인다. 벤치마크 숫자는 벤더 표를 직접 확인하는 편이 안전하다.
훨씬 비싼 상위 모델과 소수점 차이로 붙었다는 것, 이 발표에서 실제로 팔린 지점은 여기다.
컨텍스트와 입력 형식은
입력 100만 토큰, 출력 6.4만 토큰. 입력은 텍스트, 이미지, 비디오, 오디오, PDF 를 받고 출력은 텍스트만 나온다 (구글 딥마인드 모델 페이지, 2026).
출력 6.4만 토큰 상한은 긴 문서를 한 번에 생성하는 작업에서 먼저 걸린다. 장문 파이프라인을 돌린다면 입력 100만이 아닌 이쪽부터 확인할 것.
3.8 플래시 사이버는 무엇이고 왜 아무나 못 쓰나
취약점 탐지와 패치에 특화된 변종이다. 일반 API 로는 열리지 않는다. 구글이 새로 만든 페어윈드(Fairwind) 프로그램을 통해 정부 기관, 주요 인프라 운영자, 소프트웨어 유지보수자에게만 제한 공개한다 (Google 블로그, 2026).
구글이 공개한 수치는 이렇다. C/C++ 취약점 탐지에서 86.2%, 20개 이상 언어에 걸친 취약점 발견 성공률 70% 초과. 크롬 보안팀 테스트에서는 상용 최고 모델 대비 정확한 패치를 2.6배 더 많이 만들었고, 보안 업체 Wiz 테스트에서는 재현율이 7.5%p에서 9.7%p 더 높으면서 비용은 2.3배에서 5.2배 낮았다. 크롬의 심각 취약점 하나를 2시간 안에 찾아낸 사례도 공개했다. 통상 수개월이 걸리는 작업이라는 설명이 붙었다 (Google 블로그, 2026).
한 항목은 반대로 읽힌다. CWE-Bench 패치 벤치마크에서 47.2% pass@1 로, 선두 프런티어 모델의 47.8%보다 낮다 (Google 블로그, 2026). 이 모델의 강점은 고치는 쪽보다 찾는 쪽에 있다.
접근 제한 자체는 합리적인 선택이었다고 본다. 취약점을 자동으로 찾아내는 능력을 공개 API 로 열면 방어자와 공격자에게 동시에 열린다. 다만 "신뢰할 수 있는 파트너"의 기준을 구글이 단독으로 정한다는 점은 남는다. 오픈소스 유지보수자가 여기 들어가는지 여부가 실제 영향을 가른다.
어디서 쓸 수 있나
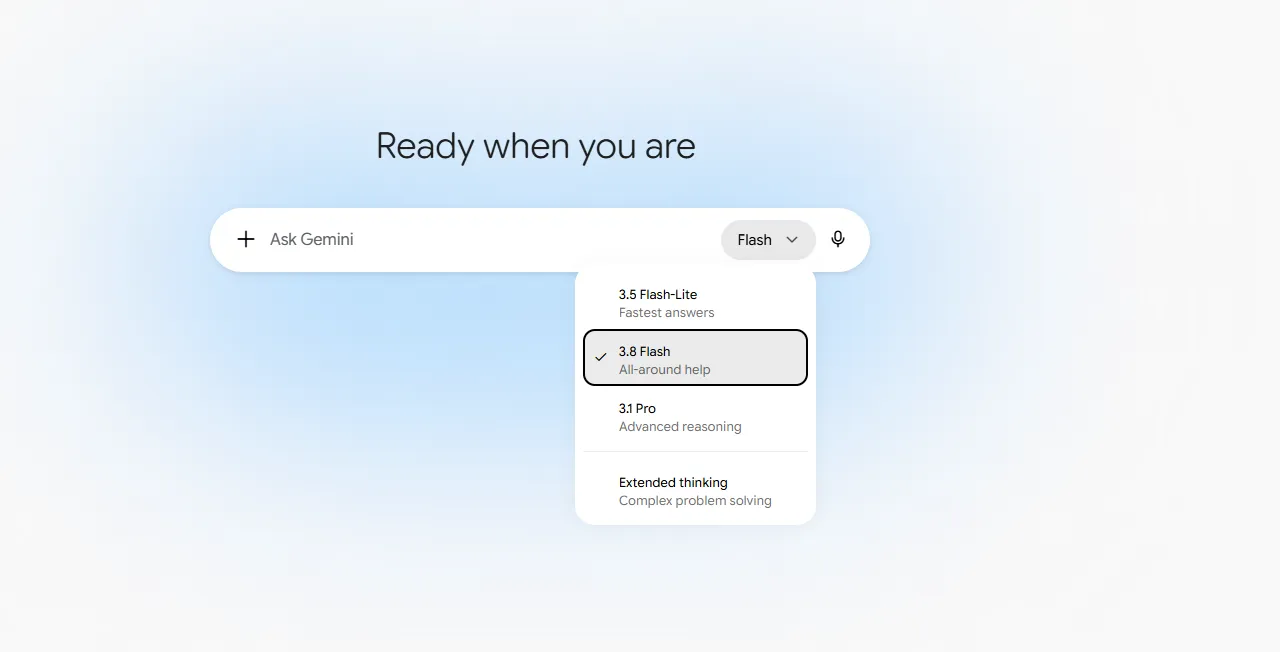
제미나이 앱(AI Pro 및 Ultra 구독자), 구글 검색 AI 모드, 구글 시트에 이미 반영됐다. 개발자 쪽은 AI 스튜디오, 제미나이 API, 안드로이드 스튜디오, 안티그래비티, 스티치, 제미나이 엔터프라이즈에서 호출할 수 있다 (Google 블로그, 2026).
무료는 아직 3.6 Flash 이다.
이 발표에서 확인되지 않은 것
위 벤치마크는 전부 구글 자체 측정이다. 독립 검증 결과는 아직 없다 [논쟁적]
지식 컷오프. 9to5Google (2026)은 도메인에 따라 2026년 3월과 2025년 1월로 갈린다고 적었으나 구글 공식 문서에서 확인하지 못했다 [확인 안 됨]
한국어 성능. 별도 수치가 공개되지 않았다 [확인 안 됨]
3.7 플래시 대비 지연 시간과 초당 토큰 처리량 [확인 안 됨]
그래서 지금 갈아탈 것인가
용도에 따라 갈린다.
코드 생성, 터미널 작업, 금융이나 법률처럼 도메인이 정해진 에이전트를 돌리고 있다면 바꿀 이유가 충분하다. Opus 5 급 결과를 6분의 1 가격에 얻는 구간이 실제로 존재한다.
컴퓨터를 직접 조작하거나 목표만 주고 알아서 하게 두는 열린 에이전트라면 유지하는 게 맞다. Terminal-bench 4.0 19.1% 대 51.8%는 가격으로 메울 수 있는 차이가 아니다.
일반 대화, 요약, 분류 같은 작업이라면 서두를 필요 없다. HLE-Verified 0.5%p 차이는 모델을 교체하고 회귀 테스트를 다시 돌릴 만한 크기가 아니다.
어느 쪽이든 2027년 1월 1일 이후 두 배 가격을 계산에 넣고 판단하는 게 순서다.
출처
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.