


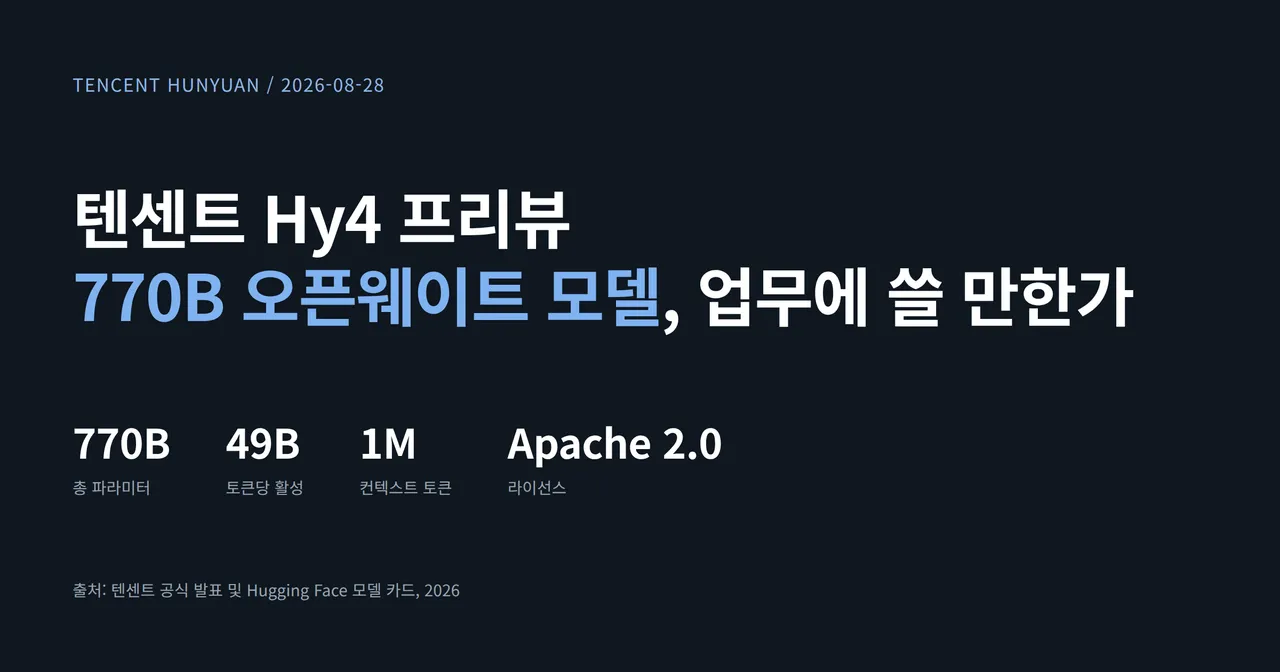
텐센트가 2026년 8월 28일 Hy4 프리뷰를 아파치 2.0 라이선스로 공개했다. 총 770B에 활성 49B인 MoE 모델이고 컨텍스트는 100만 토큰이다. 지금 손에 쥘 수 있는 경로는 API 하나뿐이며, 코드와 긴 문서를 많이 다루는 사람에게만 시험해 볼 값어치가 있다.
Hy4가 뭔가
Hy4는 텐센트 훈위안(Hunyuan, 混元) 계열의 차세대 대규모 언어 모델이다. Hy는 훈위안, 4는 세대를 뜻하고, 읽을 때는 훈위안 4로 부르면 통한다. 훈위안이라는 이름은 그동안 영상 생성 모델 HunyuanVideo 쪽으로 더 알려져 있었다. 이번 Hy4는 코딩, 문서 업무, 데이터 분석, 게임 개발, 과학 연구 같은 생산성 작업을 겨냥한 텍스트 모델이다 (텐센트 공식 발표, 2026).
스펙에서 실제로 중요한 것
숫자는 세 개만 보면 된다.
활성 파라미터 49B. 총 770B라는 크기는 홍보 문구에 가깝다. 추론 속도와 단가를 결정하는 값은 토큰마다 실제로 켜지는 49B다. 컨텍스트 1,048,576 토큰. 사내 문서 수백 장이나 저장소 전체를 한 번에 넣는 작업이 이 모델의 존재 이유다. 그리고 아파치 2.0. 상업적 사용과 파인튜닝에 제약이 거의 없다는 뜻이고, 최근 미국 프런티어 모델들이 가중치를 닫아온 흐름과 반대 방향이다.
구조는 78개 레이어 중 첫 레이어만 밀집 FFN이고 나머지 77개가 라우팅 전문가 256개와 공유 전문가 1개로 구성된 MoE다. 어텐션은 DeepSeek 스파스 어텐션 계열을 변형해 레이어 간 인덱스를 재사용한다. 추측 디코딩용 MTP 레이어가 따로 붙어 있다 (Hugging Face 모델 카드, 2026).
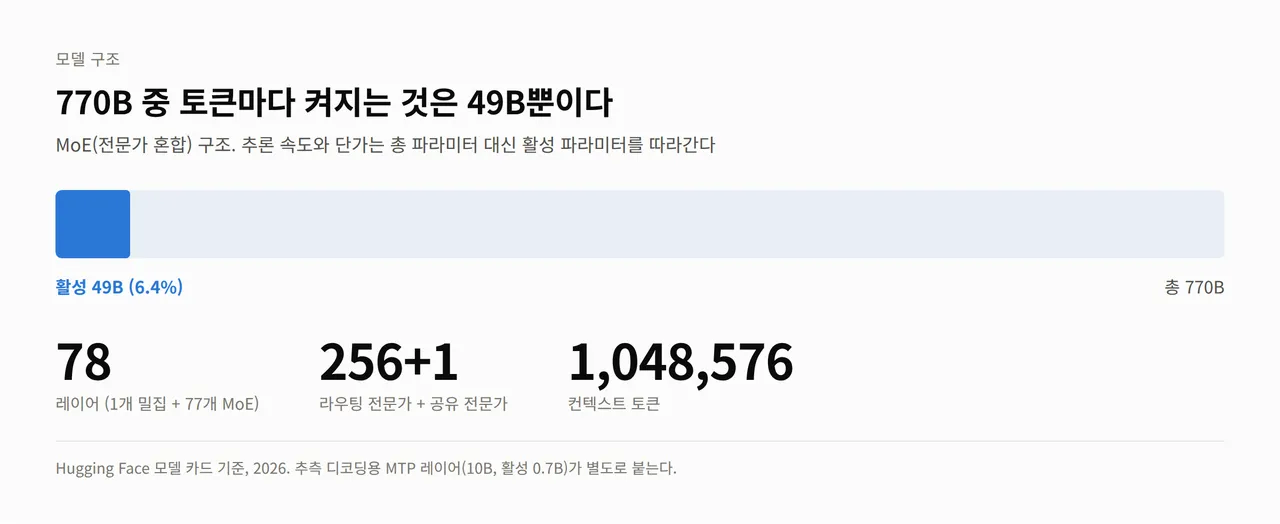
여기서 49B를 메모리 요구량으로 읽으면 곤란하다. 라우터가 토큰마다, 레이어마다 켜질 전문가를 새로 고른다. 어느 전문가가 호출될지 미리 알 수 없으니 256개 전체가 메모리에 상주해 있어야 한다. 49B가 정하는 값은 토큰당 연산량, 그러니까 속도와 단가다. 필요한 메모리는 770B 전체를 기준으로 잡아야 한다.
성능 주장은 어디까지 믿나
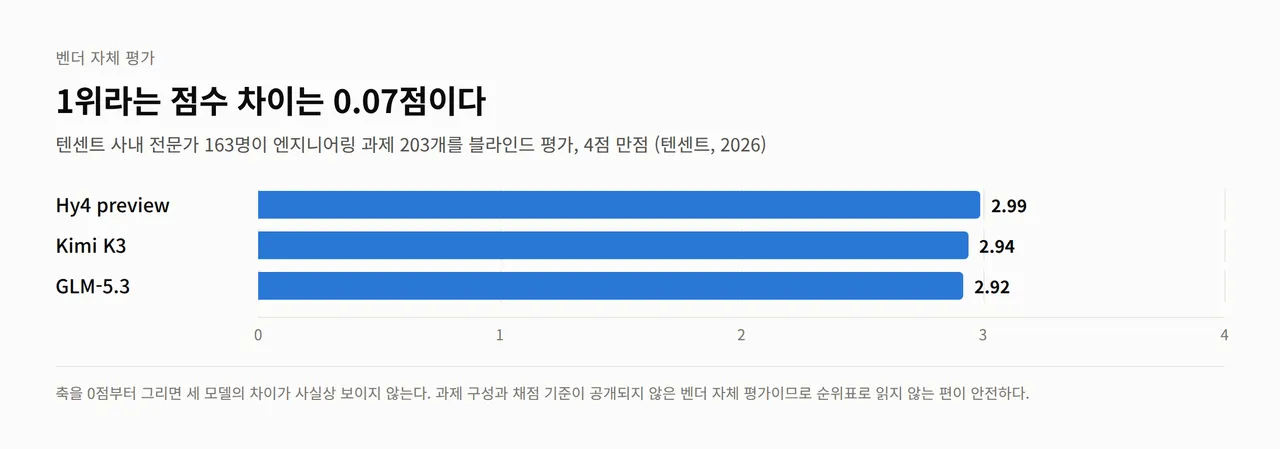
텐센트는 사내 전문가 163명이 엔지니어링 과제 203개를 블라인드 평가한 결과 Hy4가 4점 만점에 2.99점을 받아 Kimi K3(2.94)와 GLM-5.3(2.92)을 앞섰다고 밝혔다 (텐센트, 2026). 벤더 자체 평가이고 과제 구성은 공개되지 않았다. 근거 등급으로는 논쟁적이다.
공개된 벤치마크는 GPQA Diamond 92.3, SWE-Bench Pro 65.7, Deep-SWE 64.3이다 (모델 카드, 2026). 이 역시 자체 보고 수치다. 제3자 재현이 나오기 전까지는 순위표로 읽지 말고 대략의 체급 정보로만 쓰는 게 안전하다.
더 눈에 띄는 쪽은 성능보다 개발 과정에 대한 서술이다. 텐센트는 Hy4가 자기 학습 방법과 평가 체계를 직접 제안하고 실험을 돌렸으며, 연산자 융합과 통신 최적화로 종단 처리량을 31.8% 올렸다고 설명한다. 회사는 이를 초기 단계의 재귀적 자기개선 루프라고 부른다. 외부에서 검증할 방법이 없는 주장이다.
오늘 바로 써보는 법
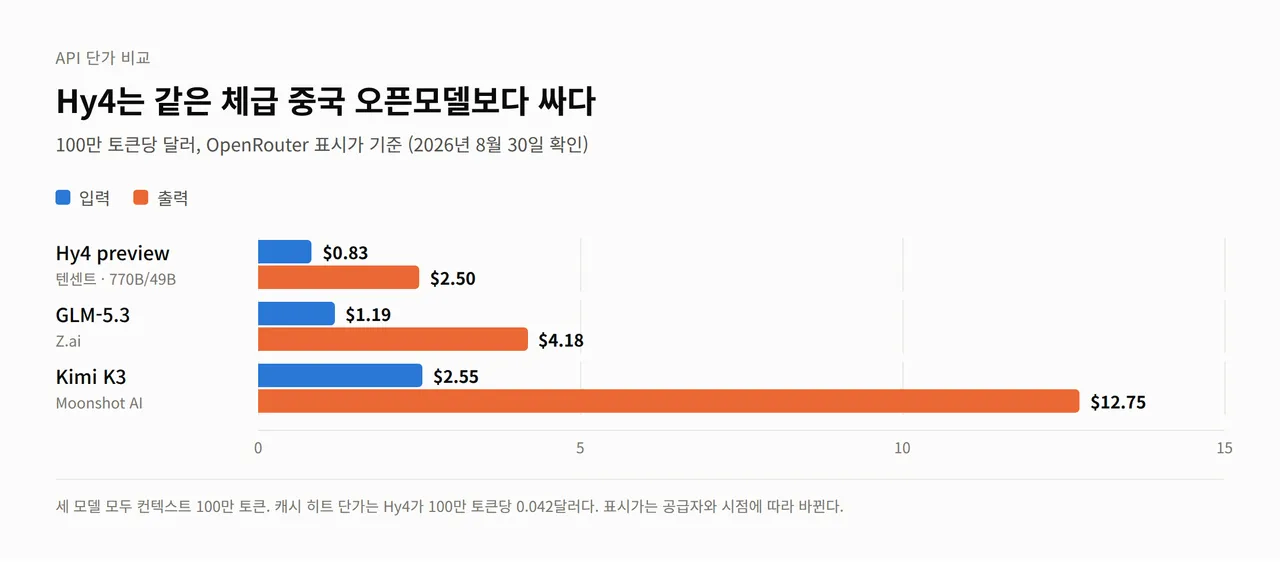
가장 빠른 경로는 OpenRouter다. 모델 슬러그는 tencent/hy4-preview, 가격은 100만 토큰당 입력 0.834달러 출력 2.501달러, 캐시 히트는 0.042달러다 (OpenRouter, 2026). OpenAI 호환 엔드포인트라 기존 스크립트에서 모델 이름만 바꾸면 붙는다. 텐센트 클라우드 TokenHub 경로도 있고 출시 후 2주간은 무료다.
로컬 실행은 접는 편이 낫다. vLLM 공식 레시피가 권장하는 구성이 B200 16장 또는 B300 8장이다. B200은 장당 HBM3e 192GB, B300은 288GB이니 어느 쪽이든 2TB에서 3TB 사이의 GPU 메모리를 깔라는 뜻이다. FP8 양자화본(tencent/Hy4-preview-FP8)이 따로 올라와 있지만 이것도 가중치만 770GB 안팎이고, 100만 토큰 컨텍스트의 KV 캐시가 그 위에 또 붙는다. 전문가 오프로딩으로 가중치를 시스템 RAM이나 NVMe에 두고 돌리는 방법이 있긴 하다. 초당 몇 토큰 수준이라 업무에 쓰기는 어렵다. 오픈 가중치라는 말이 내 노트북에서 돈다는 뜻은 아니다.
언제 쓰고 언제 안 쓰나
쓸 만한 경우는 좁다. 100만 토큰 컨텍스트가 실제로 필요한 작업, 그러니까 대형 저장소 분석이나 장문 계약서 묶음 검토가 첫 번째다. 클로드나 GPT 계열 대비 출력 단가가 낮아 대량 배치 처리에도 후보가 된다. 아파치 2.0이라 파인튜닝한 결과물을 그대로 제품에 넣을 수 있다는 점도 크다.
피해야 할 경우도 분명하다. 한국어 성능에 대한 공개 평가가 아직 없다. 회사 자료를 API로 넘긴다면 요청이 텐센트 클라우드를 지난다는 사실을 먼저 확인해야 한다. 프리뷰 딱지가 붙어 있는 만큼 모델이 예고 없이 바뀔 수 있고, 프로덕션에 바로 얹기에는 이르다.
내가 틀릴 수 있는 지점
제3자 벤치마크에서 SWE-Bench 계열 점수가 자체 보고와 크게 어긋나면 위 판단은 바뀐다. 한국어 장문 요약에서 기존 모델과 비슷한 수준이 확인되는 경우에도 마찬가지다. 두 결과 중 하나가 나오면 이 글을 정정 노트와 함께 고칠 예정이다.
발행 2026-08-30. 최종 수정 2026-08-30. 이 글은 공식 발표 자료와 모델 카드를 직접 확인해 작성했고, 초안 정리에 AI를 사용했다.
출처: 텐센트 공식 발표 / Hugging Face 모델 카드 / OpenRouter / vLLM 레시피 / TechNode
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.