


이미지 출처: AMD 공식 블로그
무슨 일이 있었나
알리바바가 Qwen3.8 세대를 공개하면서, 플래그십인 Qwen3.8-Max(2.4T 파라미터 MoE)와 함께 Qwen3.8-27B를 오픈웨이트로 풀었다. 라이선스는 Apache 2.0. 상업적 이용, 수정, 재배포가 모두 열려 있는 가장 관대한 축에 속하는 라이선스다.
그리고 같은 타이밍에 AMD가 블로그를 올렸다. 제목은 "Run Qwen 3.8 27B on AMD Ryzen AI Max Agentic PCs and Radeon GPUs". 모델이 세상에 나온 그날부터 AMD 하드웨어에서 로컬로 돌릴 수 있게 만들어놨다는 이야기다. Qwen 공식 계정이 "개발자들을 위한 선물"이라며 AMD 팀에 감사를 표한 게 이 맥락이다.
여기서 흥미로운 지점은 모델 자체보다 타이밍이다. 예전엔 새 오픈 모델이 나오면 커뮤니티가 며칠에서 몇 주에 걸쳐 양자화하고, 백엔드 붙이고, 버그 잡는 과정을 거쳐야 겨우 내 PC에서 돌아갔다. 지금은 그 사이클이 사실상 0일이 됐다.
모델을 좀 뜯어보면
스펙 시트가 꽤 재미있다.
27B 덴스, 그런데 하이브리드 어텐션. 64개 레이어인데 전부 풀 어텐션이 아니다. 3개의 Gated DeltaNet(선형 어텐션) 블록마다 1개의 Gated Attention 블록이 들어가는 패턴이 16번 반복된다. 즉 48개 레이어는 상태 크기가 일정한 선형 어텐션이고, 16개만 진짜 풀 어텐션이다. 긴 컨텍스트에서 KV 캐시가 폭발하는 걸 구조적으로 눌러놓은 설계다.
컨텍스트는 네이티브 262,144 토큰. YaRN 같은 RoPE 스케일링을 쓰면 100만 토큰까지 늘어난다. 다만 공식 문서도 경고하는데, 오픈소스 프레임워크들이 구현한 YaRN은 정적(static) 방식이라 짧은 입력에서는 오히려 성능이 떨어질 수 있다. 긴 컨텍스트가 실제로 필요할 때만 켜라는 이야기다.
비전 인코더가 붙어 있다. 이게 좀 예상 밖이었던 부분이다. 텍스트 전용이 아니라 이미지와 영상을 그대로 이해하는 네이티브 VLM이다. STEM 다이어그램, 문서, 그리고 시간 단위 길이의 영상까지 대상으로 삼는다. 27B 크기에 멀티모달이 들어간 건 로컬에서 스크린샷 기반 에이전트를 돌려보려는 사람에게 꽤 큰 차이다.
추론 깊이를 조절할 수 있다. thinking 모드가 기본으로 켜져 있고, reasoning_effort를 xhigh / medium / low로 조절할 수 있다. 여기에 preserve_thinking이라는 옵션이 기본 활성화되어 있어서, 과거 메시지의 사고 과정 블록을 대화 전체에 걸쳐 유지한다. 에이전트 시나리오에서 판단 일관성을 유지하고 중복 추론을 줄이려는 설계이고, 부수적으로 KV 캐시 활용도도 올라간다.
한 가지 실무적으로 새겨둘 만한 조언이 문서에 있다. 멀티턴 에이전트 작업에서 추론 강도를 낮춘다고 전체 작업 시간이 줄어들지는 않는다는 것. 턴당 응답은 빨라지지만 분석이 부실해져서 실패와 재시도가 늘고, 결과적으로 총 지연시간과 토큰 소비가 더 커질 수 있다.
벤치마크
Qwen이 공개한 자체 측정치 기준이다. 27B 모델의 숫자라고 생각하면 눈에 띄는 항목들이 있다.
| 항목 | Qwen3.8-27B | 이전 세대(3.6-27B) |
|---|---|---|
| SWE-bench Pro | 61.7 | 53.5 |
| Terminal Bench 2.1 | 73.0 | 63.4 |
| LiveCodeBench v6 | 90.3 | 83.9 |
| GPQA Diamond | 89.2 | 87.8 |
| OSWorld-Verified (컴퓨터 조작) | 84.3 | 63.9 |
| AndroidWorld (모바일 조작) | 81.9 | 70.3 |
특히 멀티모달 에이전트 쪽 점프가 크다. OSWorld-Verified가 63.9에서 84.3으로 뛴 건 단순한 세대 개선치를 넘어선다. 화면을 보고 클릭하는 에이전트를 로컬에서 굴려보려던 사람들에겐 실질적인 변화다.
다만 전제를 분명히 해두자. 이건 전부 모델 제작사가 자체 측정해서 발표한 숫자다. 일부는 사내 벤치마크(QwenSWEBench, CoWorkBench, RecreationBench)라 외부 검증이 불가능하고, 공개 벤치마크도 하니스와 샘플링 설정에 따라 결과가 크게 흔들린다. 표를 그대로 믿기보다는 "이 정도 주장을 하고 있다"로 받아들이고, 본인 작업으로 직접 검증하는 게 맞다.
AMD Day 0 지원의 실제 내용
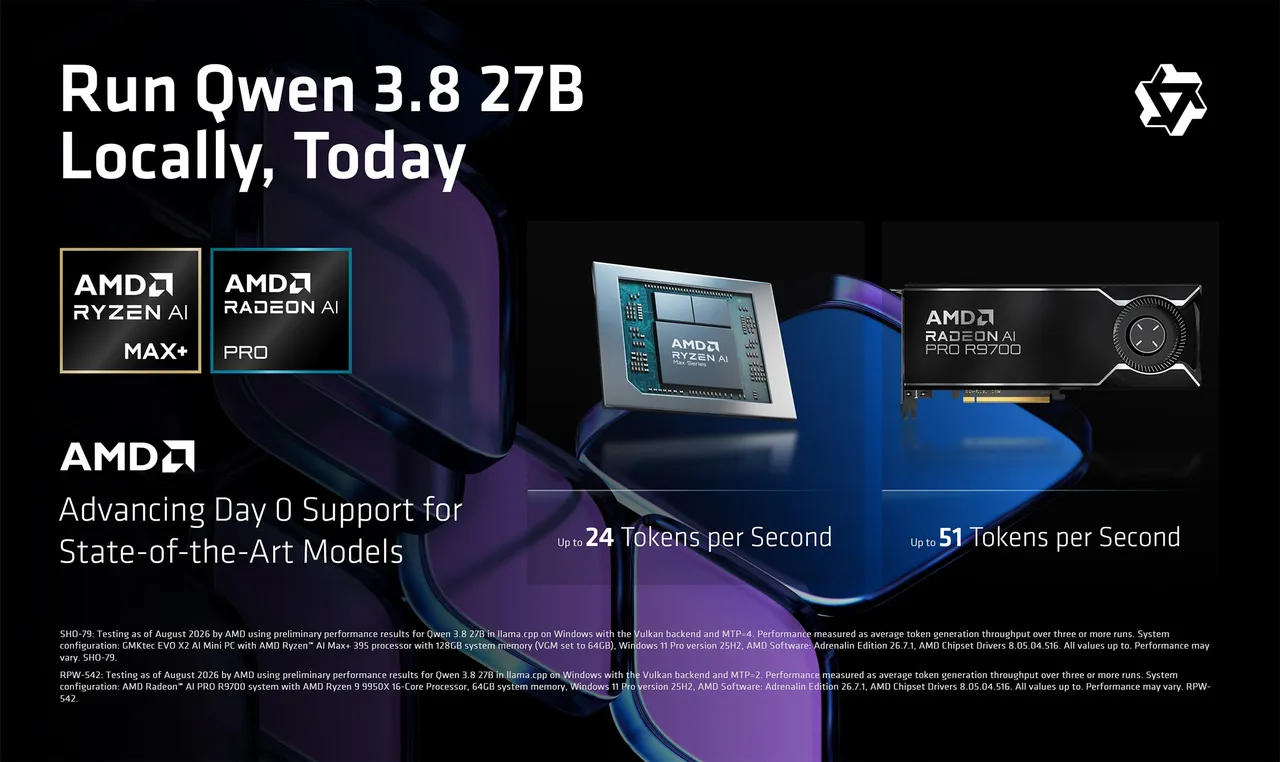
예비 성능 수치. 이미지 출처: AMD 공식 블로그
AMD가 발표한 예비 성능 수치는 이렇다.
Ryzen AI Max+ 395: 최대 24.5 tok/s
Radeon AI PRO R9700 32GB 한 장: 최대 51.8 tok/s
측정 조건을 확인하는 게 중요하다. Windows에서 llama.cpp의 Vulkan 백엔드를 사용했고, MTP(멀티 토큰 예측) 값을 Ryzen 쪽은 4, Radeon 쪽은 2로 설정했다. 3회 이상 실행의 평균 토큰 생성 처리량이다. 즉 이 숫자는 MTP 스펙큘레이티브 디코딩을 켠 상태의 값이고, AMD도 별도 주석으로 "MTP를 반드시 활성화하고 드래프트 토큰 수를 올바르게 맞춰야 최적 성능이 나온다"고 명시했다. 그냥 모델만 로드하면 이 숫자가 안 나온다.
AMD가 제시하는 경로는 두 갈래다.
LM Studio — 코드 한 줄 안 쓰고 다운로드부터 추론까지 GUI로 끝내는 경로. AMD 기준 권장 사양은 24GB 이상의 가변 그래픽 메모리(VGM) 또는 VRAM이다.
Lemonade — 이쪽이 더 흥미롭다. AMD가 만든 로컬 우선 개발자 플랫폼으로, CPU/GPU/NPU 중 어디에 태울지를 알아서 고르는 멀티 엔진 구조다. 애플리케이션에 경량 로컬 추론 레이어로 함께 패키징할 수 있어서, 앱 개발자가 하드웨어별 추론 스택을 직접 만들고 유지보수할 필요가 없어진다. 앱을 배포하고, 로컬 추론 서비스를 띄우고, 모델에 연결하면 나머지는 Lemonade가 처리하는 그림이다.
이게 AMD 입장에서 진짜 노리는 지점으로 보인다. "우리 칩에서 모델이 돌아갑니다"가 아니라 "우리 칩 위에서 로컬 AI 앱을 만들어 배포하세요"다.
실제로 돌리려면 얼마가 필요한가
메모리 계산을 해보자. 27B급 덴스 모델 기준, 가중치만 따졌을 때 대략 이렇다.
BF16: 약 56GB
FP8: 약 28GB
4비트 양자화: 약 14~16GB
여기에 KV 캐시가 별도로 올라간다. 그리고 이 모델은 KV 캐시 계산이 특히 중요하다. 262K 네이티브 컨텍스트라는 건 곧 긴 컨텍스트를 쓰고 싶어진다는 뜻이고, 컨텍스트 길이와 동시 요청 수에 비례해서 메모리가 늘어난다.
숫자가 출처마다 조금씩 다른 건 양자화 수준 차이 때문이다. Unsloth는 양자화 빌드 기준 대략 17GB RAM/VRAM 환경에서 돌아간다고 밝혔고, AMD는 24GB 이상을 권장한다. 전자는 4비트를 빠듯하게 태운 기준, 후자는 여유 있게 쓰는 기준으로 이해하면 된다. 컨텍스트를 길게 잡을수록 후자 쪽 숫자에 가까워진다.
Apple Silicon도 선택지다. 4비트 GGUF는 통합 메모리 24GB 이상이면 llama.cpp, LM Studio, Ollama 어느 쪽으로든 들어간다.
NVIDIA 쪽에서는 Unsloth가 NVFP4 양자화를 냈다. BF16 체크포인트 대비 약 1.5배 빠르고 파일 크기는 비슷하다고 하는데, Blackwell 세대(RTX 50 시리즈, B200 등)가 필요하다. 구형 GPU라면 GGUF 쪽이 답이다.
다운로드할 때 한 가지 주의. 퍼블리셔 이름이 Qwen인지 반드시 확인하자. 출시 전부터 이 모델 이름을 선점한 플레이스홀더와 포크 저장소들이 돌아다녔고 일부는 아직 남아 있다.
이게 왜 중요한가
숫자 하나하나보다 흐름이 중요하다.
첫째, 프론티어급 성능과 로컬 실행 가능성 사이의 간격이 계속 좁아지고 있다. 같은 세대의 플래그십은 2.4조 파라미터 MoE고, 자체 호스팅하려면 클러스터 규모가 필요하다. 반면 27B는 노트북 한 대, 그래픽카드 한 장에 들어간다. 그런데 코딩과 에이전트 벤치마크에서 상용 프론티어 모델과 같은 표에 올라가 있다.
둘째, 하드웨어 벤더가 오픈 모델 생태계에 붙는 속도가 달라졌다. AMD는 같은 달에 Meta Muse Glimmer 30B, Qwen3.8 Instinct 지원까지 연달아 Day 0 블로그를 냈다. 오픈 모델 대응이 이벤트가 아니라 정례 프로세스가 된 것이다. 사용자 입장에선 "새 모델 나올 때마다 내 하드웨어 생태계가 따라잡을 때까지 기다릴 필요가 없다"는 뜻이고, 이건 AMD가 블로그에서 직접 쓴 표현이기도 하다.
셋째, 데이터를 밖으로 내보내지 않는 선택지가 실용 영역에 들어왔다. 가중치를 내가 들고, 하드웨어를 내가 고르고, 파인튜닝도 내가 한다. API 호출당 비용도 없고 레이트 리밋도 없다. Apache 2.0이라 상업적 제약도 없다. 물론 전기와 하드웨어 감가상각은 내 몫이지만.
냉정하게 볼 지점
과열된 이야기를 좀 덜어내자면 이렇다.
24.5 tok/s는 대화용으로는 충분하지만 에이전트용으로는 답답하다. 긴 사고 과정을 뽑아내는 reasoning 모델의 특성상, 최종 답변 전에 수천 토큰을 생성한다. 문서 권장 설정만 봐도 추론 콘텐츠에 최대 262K 토큰을 할당하라고 되어 있다. 초당 24.5 토큰이면 산술적으로 어떤 그림인지 짐작이 갈 것이다. 로컬 에이전트를 진지하게 돌리려면 GPU 쪽 51.8 tok/s가 현실적인 하한선에 가깝다.
Day 0 지원은 시작점이지 완성점이 아니다. AMD 스스로 "소프트웨어와 모델 최적화가 아직 진행 중이며 Day 0 지원이 성숙해지면서 성능이 계속 개선될 것"이라고 썼다. 지금 벤치마크는 예비 수치다.
벤치마크는 벤더 발표다. 앞서 언급했지만 다시 강조할 만하다. 특히 사내 벤치마크로 낸 압도적인 숫자들은 외부 재현이 불가능하다.
그럼에도, 3년 전에 "27B 멀티모달 추론 모델이 미니 PC에서 돌아간다"고 했으면 아무도 안 믿었을 것이다. 지금은 그게 화요일에 나온 블로그 포스트다.
참고 링크
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.