


AI 모델 선택에서 반복되는 갈등이 있다. 최고 성능을 따라가면 비용이 급등하고, 합리적인 가격을 택하면 핵심 기능에서 타협하게 된다. SpaceXAI의 Grok 4.6은 이 긴장 관계를 정면으로 재설계한 모델이다. 최상위권 추론 능력과 긴 작업을 스스로 이어가는 에이전트 성능을 확보하면서도, 경쟁 모델 대비 출력 토큰 비용을 4~5배 낮췄다.
성능과 가격의 균형을 다시 정의하다
Artificial Analysis Intelligence Index는 9개 벤치마크로 모델의 종합 지능을 평가하는 지표다. 이 지수에서 Grok 4.6은 61점을 기록하며 OpenAI의 GPT-5.6 Sol과 동점에 올랐다 1. Anthropic의 Claude Opus 5(63점)와 Claude Fable 5(62점)에는 소폭 뒤처지지만, 한 달 전 Grok 4.5 대비 5점, Grok 4.3 대비로는 23점 상승한 수치다 2.
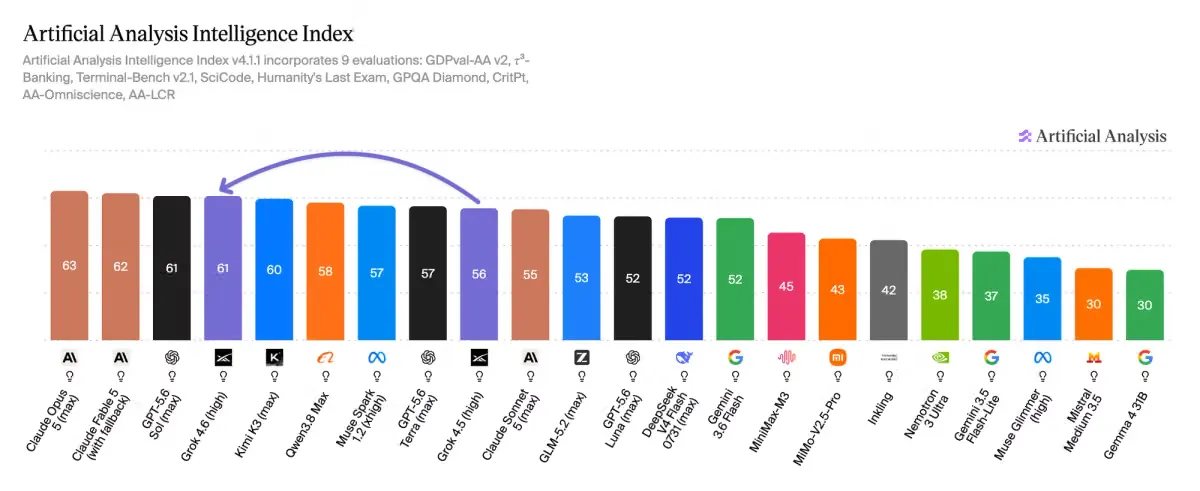
더 실질적인 차이는 가격에서 드러난다. Grok 4.6은 입력 토큰 100만 개당 2달러, 출력 토큰 100만 개당 6달러로 책정됐다 3. GPT-5.6 Sol의 출력 토큰 가격이 30달러, Claude Opus 5가 25달러인 점을 고려하면, 실질 작업 비용에서 60% 이상 저렴하다 2. AI 모델의 세대 교체 때마다 성능 상승과 함께 가격도 오르던 관행을 정면으로 뒤집은 사례다.
에이전트 작업에서 드러나는 진짜 차별점
Grok 4.6의 강점은 단일 추론보다 여러 단계의 실제 업무를 수행하는 에이전트 작업에서 두드러진다. 실제 업무 환경을 반영한 GDPval-AA v2 평가에서는 Elo 1753점을 획득해 Claude Opus 5 바로 다음 위치를 차지했고, Claude Fable 5 및 Qwen3.8 Max와는 오차 범위 내 동등 수준을 기록했다 2.
장기 작업 벤치마크인 AA-Briefcase에서는 Elo 1577점으로 Fable 5급 성능을 보이면서도, 작업 완료까지 평균 53턴과 입력 토큰 0.5B만을 소모했다. Claude Opus 5가 동일 작업에 평균 103턴, 토큰 2.0B를 사용한 것과 극명한 대비를 이룬다 2. 턴 수와 토큰 소비가 절반 이하라는 의미는, 긴 에이전트 작업으로 갈수록 토큰 단가 이상으로 비용 격차가 누적된다는 점이다.
이러한 효율성은 훈련 방식에 뿌리를 둔다. Grok 4.6은 Grok 4.5보다 긴 보충 훈련을 거쳤으며, 추론 노력과 소프트웨어 공학, STEM, 지식 작업 전반에 걸쳐 Grok 4.5로 훈련 궤적을 재생성하고 문제가 있는 데이터는 모델 기반 검사로 필터링했다. 이후 커널 최적화, 웹 개발, 컴퓨터 지원 설계(CAD) 등 도메인별 환경에서 에이전틱 강화학습을 진행했다 4. 이 과정에서 모델이 다음 단계로 넘어가기 전에 스스로 작업을 검증하는 행동도 관찰되기 시작했다 4.
실무 적용을 위한 포인트
Grok 4.6은 API뿐 아니라 Cursor, Grok Build, OpenRouter, Vercel, Cloudflare를 통해 즉시 사용할 수 있다 3. 컨텍스트 윈도우는 500,000 토큰, 지식 마감 시점은 2026년 2월 1일이며 텍스트와 이미지 입력을 지원한다 5. API 사용 시 prompt_cache_key 또는 x-grok-conv-id 헤더를 설정하면 캐시 적중률이 올라 입력 비용을 추가로 절감할 수 있다 5.
이 모델은 복잡한 코드베이스 분석, 장기간 이어지는 지식 작업, 여러 도구를 오가는 고객 서비스 자동화처럼 한 번의 응답이 아니라 여러 턴을 거친 완수가 중요한 업무에 특히 적합하다. GPT-5.6 Sol과 동급의 추론 능력을 절반 이하 비용으로 활용해야 하는 상황이라면, 일차 검토 대상으로 삼을 만한 모델이 바로 Grok 4.6이다.
참고
2Grok 4.6 returns SpaceXAI to the intelligence frontier and leads on cost efficiency
3Introducing Grok 4.6 | SpaceXAI
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.