


AI로 캐릭터를 만들기 시작했을 때, 가장 먼저 부딪히는 문제는 단순했습니다. “다음 컷에서도 같은 사람으로 보이게 할 수 있을까?” 한 장은 근사하게 나오는데, 배경과 포즈를 바꾸는 순간 얼굴이 달라지고 의상이 흐트러집니다.
캐릭터 시트는 이 문제를 해결하려고 점점 복잡해졌습니다. 처음에는 기준 이미지 한 장을 붙잡는 방식이었고, 그다음에는 모델이 추측하지 않도록 얼굴·의상·소품을 최대한 자세히 적어 넣는 방식이 됐습니다. 그런데 최근의 제작 가이드는 오히려 반대 방향을 보여 줍니다. 모델이 필요한 정보를 더 잘 읽게 될수록, 한 장에 모든 것을 넣기보다 그 장면에 필요한 신호만 남기는 편이 더 안정적이라는 것입니다.
Midjourney V7, Nano Banana 1, Higgsfield의 사례를 차례로 보면 이 변화가 선명하게 보입니다.
1. Midjourney V7: ‘어떻게든 같은 사람을 붙잡아 두는’ 단계
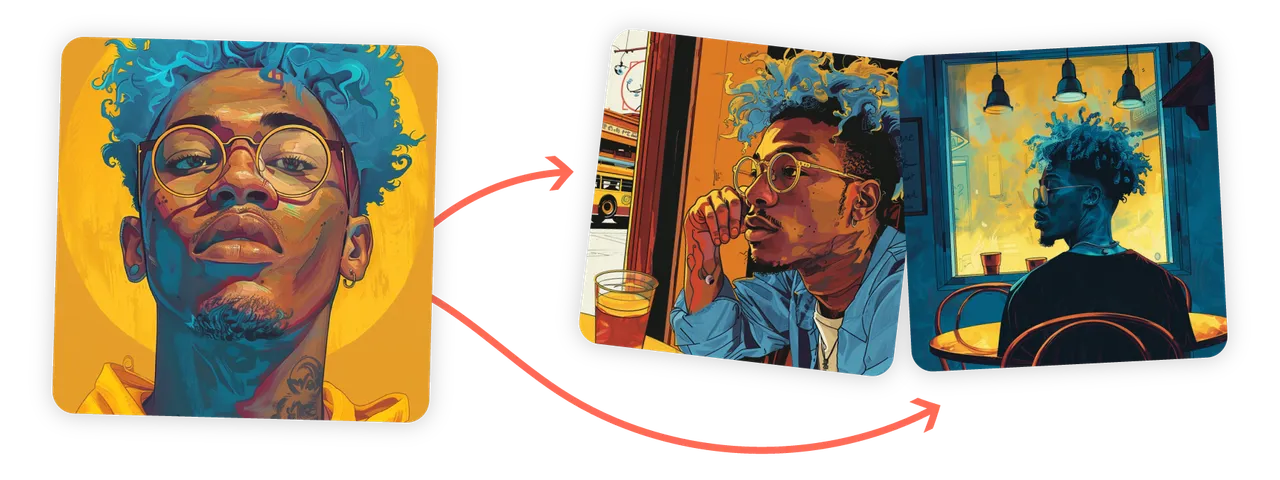
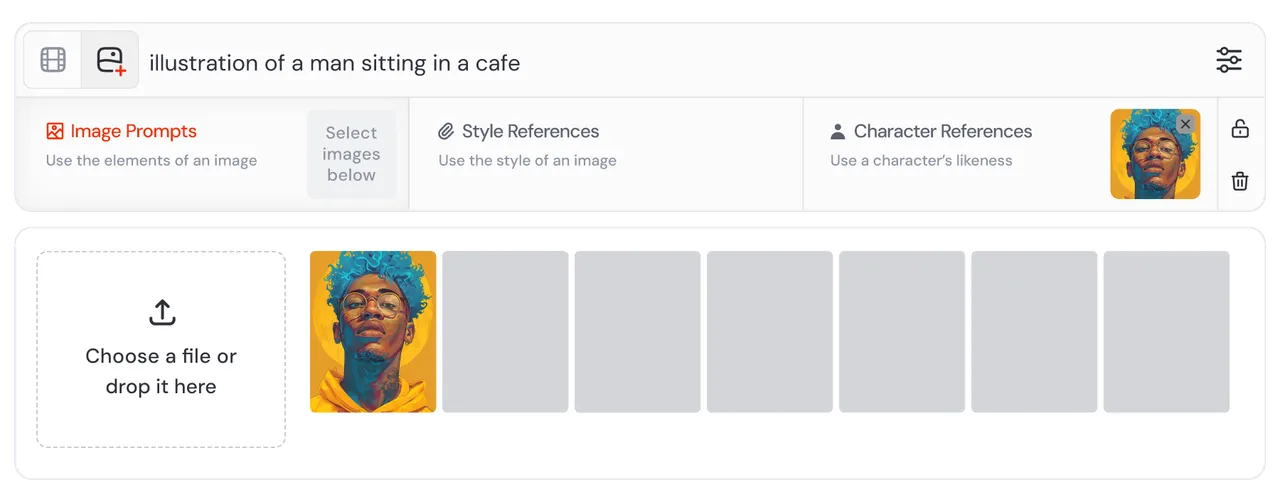
Midjourney V7의 Omni Reference는 이 문제에 대한 직접적인 답이었습니다.
기준이 될 인물 이미지를 넣고, Omni Reference와 reference weight를 통해 그 이미지가 결과에 얼마나 강하게 반영될지 조절합니다.1
당시의 핵심은 좋은 기준 이미지 하나를 만드는 일이었습니다. 얼굴이 잘 보이고, 머리 모양과 실루엣이 분명하며, 안경·흉터·장신구·대표 의상처럼 인물을 알아보게 하는 특징이 들어 있는 이미지 말입니다. 이후에는 장소와 행동, 카메라 구도만 바꿔 가며 같은 기준 이미지를 계속 씁니다. 캐릭터 시트는 말 그대로 정체성을 붙잡아 두는 닻 역할을 했습니다.
이 방식은 분명한 진전이었습니다. 인물이 카페에 있든 사막에 있든 같은 사람처럼 보일 가능성을 높여 줬습니다. 하지만 한계도 분명했습니다.
참조 이미지는 결과를 복사하는 도구가 아니라, 생성의 방향을 잡아 주는 입력값입니다. 조명과 포즈, 카메라 시점이 크게 달라지면 얼굴의 세부와 의상이 함께 흔들릴 수 있습니다.1
참조 강도를 높이면 얼굴은 붙잡히지만, 의상이나 표정까지 굳어 버리기 쉽습니다. 반대로 강도를 낮추면 장면은 자연스러워져도 인물의 정체성이 흐려집니다.
여러 인물이 한 화면에 있거나, 한 인물이 낯선 동작을 해야 할 때는 “누구의 어떤 특징을 유지해야 하는가”가 모호해집니다.
그래서 Midjourney 시대의 캐릭터 시트는 대체로 한 장의 강한 기준 이미지였습니다. 중요한 건 기준 이미지를 계속 바꾸지 않는 것이었습니다. 결과가 나올 때마다 더 마음에 드는 이미지를 새 기준으로 삼으면, 작은 차이가 누적돼 어느 순간 다른 인물이 됩니다. 처음 승인한 이미지를 마스터로 고정하고, 모든 장면을 그 이미지에서 파생시키는 방식이 필요했습니다.
2. Nano Banana 1: 일관성을 유지한 채 ‘새로운 상상’을 시키는 단계
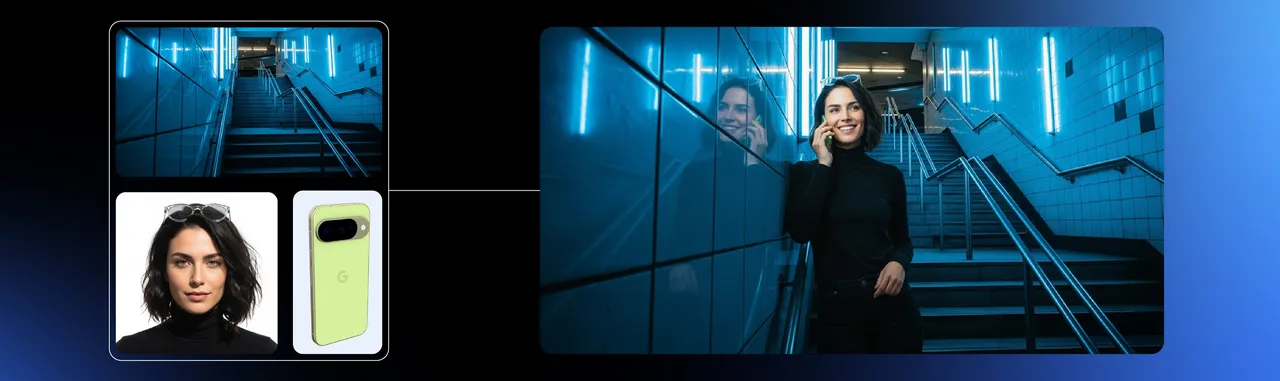
Nano Banana 1은 캐릭터 일관성을 조금 다른 방식으로 다뤘습니다. 기준 이미지를 강하게 붙잡기보다, 이미지를 이해한 뒤 “같은 인물을 이 장소에 놓아 줘”, “의상만 바꿔 줘”, “이 포즈를 취하게 해 줘”처럼 자연어로 이어서 수정하는 경험을 앞세웠습니다. 같은 캐릭터가 낯선 공간과 상황으로 자연스럽게 넘어갈 수 있다는 점에서, 단순한 재현을 넘어선 변화였습니다.2
다만 이 자유도에는 대가가 있었습니다. 모델에게 빈칸이 많을수록 그 빈칸을 스스로 상상해 채우기 때문입니다. 긴 문구나 정보량이 많은 텍스트, 복잡한 레이아웃처럼 정확히 읽히고 배치돼야 하는 요소는 흔들리기 쉬웠습니다. 인물도 마찬가지입니다. 얼굴·의상·나이·소품·화풍·장면을 한 번에 크게 바꾸면, 모델은 무엇을 지키고 무엇을 새로 상상해야 할지 판단해야 했습니다. 그 과정에서 얼굴은 비슷한데 재킷 색이 달라지거나, 장면은 멋진데 소품이 바뀌는 일이 생깁니다.
이 시기의 해법은 “더 자세한 캐릭터 시트”였습니다. 모델이 추측해야 할 여지를 최대한 줄이는 쪽입니다.
정체성: 얼굴형, 헤어스타일, 체형, 피부 특징, 안경, 흉터처럼 장면이 바뀌어도 유지할 정보
상태: 사막 의상, 비에 젖은 재킷, 부상 흔적처럼 이야기 진행에 따라 달라질 정보
연출: 장소, 시간대, 조명, 렌즈, 구도, 동작처럼 컷마다 바꿔도 되는 정보
이 세 층을 나눠 두면 프롬프트도 훨씬 명확해집니다. “같은 캐릭터”라고만 말하는 대신, “얼굴과 체형은 유지하고 재킷만 사막용 망토로 바꾼다. 구도와 조명은 유지한다”처럼 요청할 수 있습니다. 여러 참조 이미지를 쓸 때도 한 장은 얼굴, 다른 한 장은 포즈, 또 다른 한 장은 배경처럼 역할을 나눠 주는 방식이 중요해졌습니다.3
즉, Nano Banana 1 시기의 캐릭터 시트는 인물을 잘 보여 주는 그림을 넘어, 모델에게 전달할 정보를 빠짐없이 정리한 상세한 설정집에 가까웠습니다. 같은 인물이 새로운 장면을 상상할 수 있게 해 줬지만, 그 상상이 엉뚱한 곳으로 새지 않도록 사람이 훨씬 더 구체적으로 지시해야 했습니다.
3. Higgsfield: 이제는 ‘많이 보여 주는 것’이 오히려 방해가 될 수 있다
Higgsfield의 Blockbuster 4K 가이드는 이 흐름이 다시 뒤집히는 지점을 보여 줍니다. 이 사례는 하나의 이미지 모델이 아니라 이미지 생성·편집·영상 생성을 묶은 제작 워크플로입니다. 여기서 캐릭터 시트는 더 이상 정보를 최대한 많이 담는 문서가 아닙니다. 다음 모델이 헷갈리지 않도록, 목적에 맞게 정보를 걸러 낸 입력값입니다.4
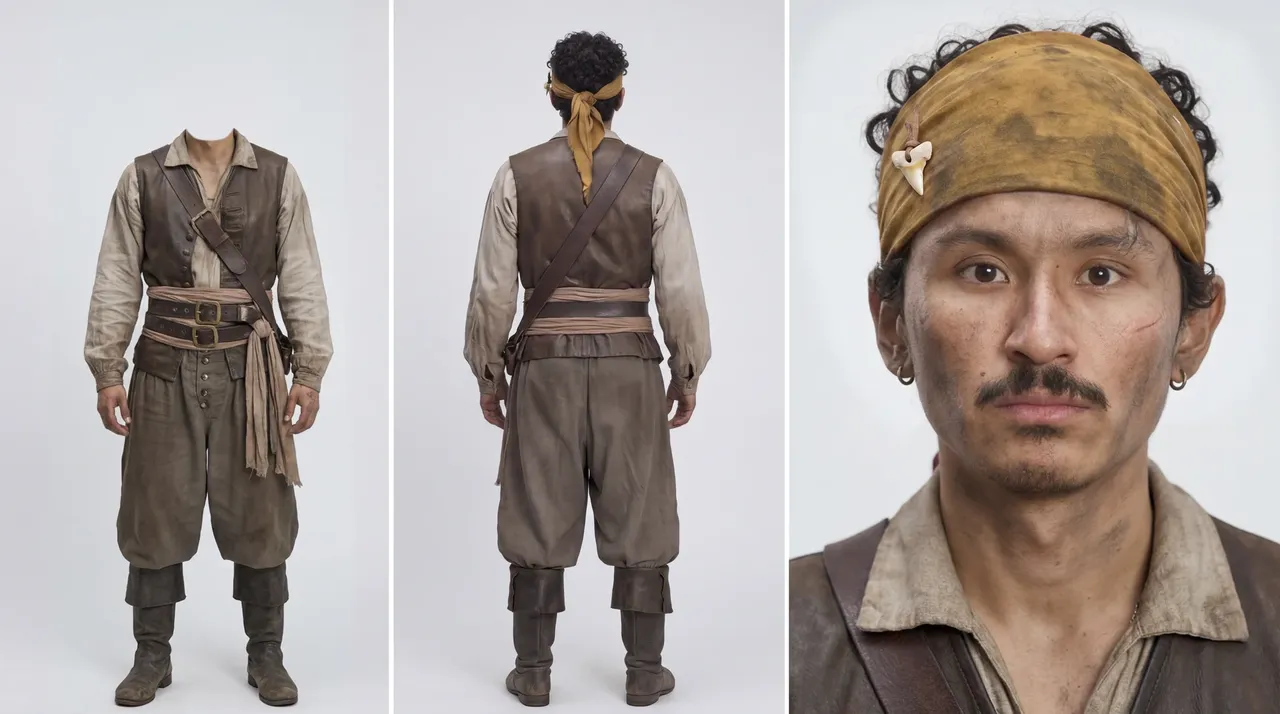
가이드는 먼저 정면 전신, 후면 전신, 정면 클로즈업으로 된 3뷰 캐릭터 시트를 만듭니다. 이 단계에서는 의상과 실루엣, 얼굴을 함께 확인해야 하므로 다양한 뷰가 필요합니다. 사람에게는 이런 마스터 시트가 유용합니다.
하지만 이 시트를 영상 생성 모델에 그대로 넣지는 않습니다. 가이드가 지적하듯 여러 얼굴이 들어 있는 시트는 Seedance가 어느 얼굴을 주인공의 기준으로 잡아야 하는지 혼동하게 만들 수 있습니다. 그래서 영상 생성에 쓰는 참조에서는 얼굴을 반복해서 보여 주지 않고, 정체성을 고정할 얼굴 클로즈업 하나만 남기는 방향을 택합니다.4
이전에는 모델이 놓칠까 봐 얼굴을 정면·측면·전신에 반복해서 넣었다면, 이제는 오히려 중복된 얼굴 정보가 혼선을 만든다고 보는 것입니다. 몸의 실루엣, 의상, 소품, 공간을 보여 주는 시트에는 얼굴을 굳이 거듭 넣지 않습니다. 얼굴은 한 장의 선명한 클로즈업에 맡기고, 나머지 시트는 각자가 담당해야 할 정보만 보여 줍니다.
캐릭터 클로즈업은 얼굴 정체성을 고정합니다.
전신·의상 시트는 실루엣과 복장의 상태를 설명합니다.
장소 시트는 공간의 구조와 분위기를 유지합니다.
소품 시트는 물건의 형태와 디테일을 이어 줍니다.
가이드에서는 이렇게 만든 자산에 이름을 붙여 장면마다 불러옵니다. 예를 들어 주인공, 선박, 선실 같은 자산을 각각 태그로 관리하고, 장면 프롬프트에서는 필요한 자산만 호출합니다. 이때 모델은 얼굴·의상·소품·공간을 한 장의 거대한 캐릭터 시트에서 억지로 해석하지 않아도 됩니다. 각 정보가 어디에 있는지, 어떤 장면에서 필요한지가 분리돼 있기 때문입니다.
‘상세한 한 장’에서 ‘정확한 여러 장’으로
세 단계를 한 줄로 이어 보면 캐릭터 시트의 변화는 다음과 같습니다.
| 시기 | 캐릭터 시트가 해결하려던 문제 | 시트의 형태 |
|---|---|---|
| Midjourney V7 | 장면이 달라져도 같은 사람으로 보이게 하기 | 정체성을 강하게 담은 기준 이미지 한 장 |
| Nano Banana 1 | 같은 인물에게 새로운 상황과 변화를 자연스럽게 부여하기 | 얼굴·의상·상태·연출을 최대한 자세히 적은 설정집 |
| Higgsfield 워크플로 | 여러 모델과 여러 장면에서 자산을 혼동 없이 이어 쓰기 | 목적별로 정보를 나눈 여러 장의 참조 자산 |
중요한 변화는 캐릭터 시트가 단순히 더 정교해진 것이 아니라, 더 선별적으로 변했다는 데 있습니다. 사람에게 보여 줄 마스터 시트에는 많은 정보가 필요할 수 있습니다. 그러나 생성 모델에 넣는 시트는 모든 정보를 담을 필요가 없습니다. 오히려 한 장에 너무 많은 얼굴과 각도, 상태를 넣으면 모델이 잘못 이해할 가능성이 커집니다.
그래서 앞으로는 “최대한 자세하게 만든 뒤, 모델에 넣을 때는 최대한 분명하게 덜어 낸다”가 될 것입니다.
사람을 위한 마스터 시트에는 정면·측면·후면, 의상과 소품, 상태 변화를 충분히 기록합니다.
모델을 위한 입력 시트에는 그 장면에서 필요한 정보만 남깁니다. 얼굴을 고정해야 한다면 선명한 클로즈업 한 장이면 충분할 수 있습니다.
의상·소품·공간은 얼굴과 한데 뭉치지 말고, 각자 독립된 자산으로 관리합니다.
장면마다 필요한 자산만 불러오고, 바뀌지 않아야 할 조건은 프롬프트에 따로 적습니다.
결국 AI 캐릭터 시트의 진화는 “모델에게 얼마나 많은 정보를 줄 것인가”의 문제가 아닙니다. 모델이 지금 무엇을 알아야 하는가를 판단해야합니다. 처음에는 같은 얼굴을 붙잡기 위해 한 장의 이미지를 반복해서 보여 줬고, 그다음에는 모델의 상상력을 통제하기 위해 모든 특징을 자세히 적었습니다. 이제는 더 나은 멀티모달 이해를 전제로, 얼굴·의상·소품·공간을 분리하고 필요한 정보만 정확히 건네는 단계로 넘어가고 있습니다.
참고
1Flowith — Midjourney V7 Consistent Characters: Omni Reference
2Introducing Gemini 2.5 Flash Image, our state-of-the-art image model
3The ultimate Nano Banana prompting guide
4Higgsfield — Make Viral AI Short Films With This Exact Workflow (Blockbuster 4K)
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.