


LangGraph로 복잡한 워크플로 설계하기

체인으로 충분한 일과 그래프가 필요한 일
LCEL 체인은 입력이 한 방향으로 흐르는 작업에 잘 맞습니다. 예를 들어 "질문을 받는다 → 문서를 검색한다 → 프롬프트에 넣는다 → 답변을 생성한다 → 문자열로 파싱한다" 같은 RAG 흐름은 retriever | prompt | model | parser 형태로 깔끔하게 표현할 수 있습니다. 단계가 고정되어 있고, 중간에 되돌아가거나 승인 대기를 할 필요가 없다면 LCEL이 가장 단순합니다.
하지만 실제 업무 자동화는 자주 이런 모양이 됩니다.
검색 결과가 부족하면 다시 검색한다.
초안 품질이 낮으면 수정 단계로 되돌린다.
민감한 답변은 사람이 승인한 뒤 발송한다.
사용자의 피드백을 받아 같은 작업을 이어서 실행한다.
여러 도구 호출 결과와 중간 판단을 장기간 이어지는 작업 상태로 남긴다.
이런 흐름을 하나의 긴 체인으로 만들면 if 문, 재시도 루프, 예외 처리, 상태 저장 코드가 여기저기 섞입니다. 처음에는 동작하지만, 곧 "지금 어느 단계인가?", "왜 이 도구를 다시 호출했는가?", "사람이 승인한 뒤 어디서 재개해야 하는가?"를 추적하기 어려워집니다.
LangGraph는 이런 문제를 그래프 형태로 풀기 위한 LangChain 생태계의 구성 요소입니다. 공식 문서는 워크플로를 "미리 정해진 코드 경로를 따라 특정 순서로 실행되는 흐름"으로, 에이전트를 "상황에 따라 도구 사용과 다음 단계를 더 동적으로 결정하는 흐름"으로 구분합니다1. LangGraph는 이 둘을 모두 다룰 수 있지만, 핵심은 같습니다. 복잡한 실행 과정을 상태, 노드, 엣지로 명시한다는 점입니다.
간단히 정리하면 다음과 같습니다.
| 상황 | 더 적합한 방식 |
|---|---|
| 단순 요약, 분류, 번역 | LCEL 체인 |
| 기본 RAG 질의응답 | LCEL 체인 |
| 조건에 따라 다른 작업으로 분기 | LangGraph |
| 도구 호출 후 결과에 따라 반복 | LangGraph |
| 사람 승인 후 이어서 실행 | LangGraph |
| 장기 상태와 체크포인트 필요 | LangGraph |
중요한 점은 LangGraph가 LCEL을 대체하지 않는다는 것입니다. 보통은 LangGraph의 각 노드 안에서 LCEL 체인을 실행합니다. 즉, LCEL은 "한 단계의 처리 흐름"을 만들고, LangGraph는 "여러 단계를 어떤 순서와 조건으로 실행할지"를 설계합니다.
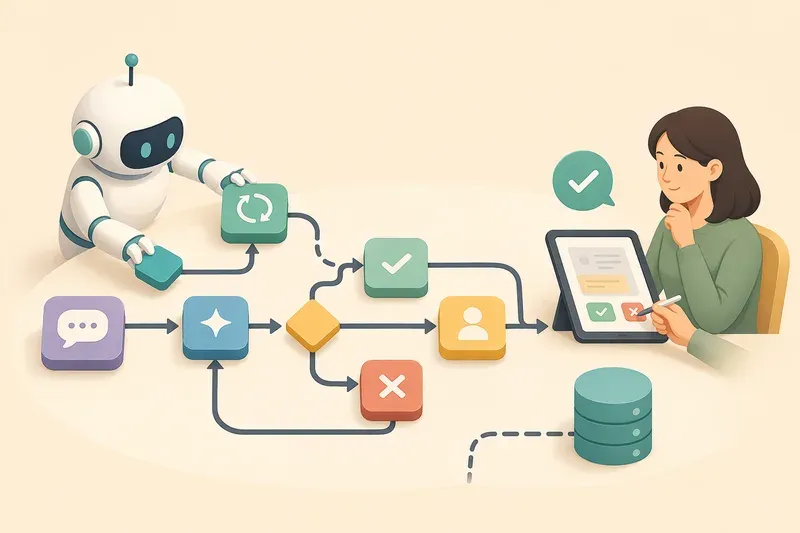 AI 생성 이미지
LangGraph의 기본 단위: 상태, 노드, 엣지
LangGraph를 이해하려면 세 가지 단어만 먼저 잡으면 됩니다.
상태(state)는 워크플로 전체가 공유하는 데이터입니다. 사용자의 원 질문, 검색된 문서, 초안, 검토 의견, 승인 여부, 반복 횟수 같은 값이 들어갑니다.
노드(node)는 하나의 작업 단계입니다. 검색하기, 초안 작성하기, 검토하기, 수정하기, 최종 답변 만들기처럼 독립적으로 테스트할 수 있는 함수가 노드가 됩니다.
엣지(edge)는 다음에 어떤 노드로 이동할지를 나타냅니다. 항상 같은 다음 단계로 이동할 수도 있고, 상태 값에 따라 다른 노드로 분기할 수도 있습니다.
LangGraph의 공식 설계 방식도 이와 비슷합니다. 먼저 자동화하려는 과정을 작은 단계로 나누고, 각 단계를 노드로 만든 뒤, 모든 노드가 읽고 쓸 공유 상태를 설계합니다2.
다음은 문서 작성 워크플로에서 사용할 상태 예시입니다.
from typing import TypedDict, Literal

class WritingState(TypedDict, total=False):
    question: str
    docs: list
    draft: str
    feedback: str
    approved: bool
    revision_count: int
    final_answer: str
    final_status: str
상태 설계에서 흔한 실수는 프롬프트 문자열까지 상태에 넣는 것입니다. 상태에는 오래 유지해야 하는 원자료나 다음 단계에 필요한 식별자를 넣는 편이 좋습니다. 예를 들어 docs에는 검색된 문서 객체나 문서 ID, 발췌문을 두고, 프롬프트에 넣을 context 문자열은 초안 작성 노드 안에서 그때그때 만들면 됩니다. 이렇게 하면 프롬프트 형식을 바꿔도 상태 구조를 크게 바꾸지 않아도 됩니다.
체크포인터를 사용할 계획이라면 상태에 넣는 값이 저장 가능한 형태인지도 확인해야 합니다. 개발 중에는 문서 객체를 그대로 넣어도 문제가 없어 보일 수 있지만, 운영 환경의 저장소에서는 직렬화가 까다로운 객체가 문제를 일으킬 수 있습니다. 그럴 때는 원문 전체 대신 문서 ID, 필요한 발췌문, 저장소 위치처럼 다음 단계에 꼭 필요한 정보만 남기는 편이 안전합니다.
노드는 상태를 입력으로 받고, 변경할 값만 딕셔너리로 반환합니다.
def search_docs(state: WritingState):
    docs = retriever.invoke(state['question'])
    return {'docs': docs}


def write_draft(state: WritingState):
    context = 'nn'.join(doc.page_content for doc in state['docs'])
    draft = draft_chain.invoke({
        'question': state['question'],
        'context': context,
    })
    return {
        'draft': draft,
        'revision_count': 0,
        'approved': False,
        'feedback': '',
    }
여기서 retriever는 앞에서 만든 리트리버라고 생각하면 됩니다. draft_chain은 prompt | model | parser로 만든 LCEL 체인입니다. LangGraph가 검색이나 모델 호출을 새롭게 바꾸는 것이 아닙니다. 이미 만든 구성 요소를 더 큰 절차 안에 배치하는 것입니다.
문서 작성 그래프 설계하기
이제 검색, 초안 작성, 검토, 수정, 최종 응답으로 이어지는 그래프를 만들어 보겠습니다. 전체 흐름은 다음과 같습니다.
START
  ↓
search_docs
  ↓
write_draft
  ↓
human_review
  ├─ 승인 → finalize
  ├─ 수정 요청 → revise_draft → human_review
  └─ 수정 횟수 초과 → finalize(추가 검토 필요 표시)
먼저 수정과 최종화 노드를 정의합니다.
def revise_draft(state: WritingState):
    context = 'nn'.join(doc.page_content for doc in state['docs'])
    revised = revise_chain.invoke({
        'question': state['question'],
        'context': context,
        'draft': state['draft'],
        'feedback': state['feedback'],
    })

    return {
        'draft': revised,
        'revision_count': state.get('revision_count', 0) + 1,
    }


def finalize(state: WritingState):
    if state.get('approved'):
        return {
            'final_answer': state['draft'],
            'final_status': 'approved',
        }

    return {
        'final_answer': '[추가 검토 필요]nn' + state['draft'],
        'final_status': 'needs_review',
    }
수정 노드는 기존 초안과 사람의 피드백을 함께 사용합니다. 이때 반복 횟수도 상태에 저장합니다. 반복 횟수는 안전장치입니다. 모델이 계속 수정만 반복하거나, 사람이 애매한 피드백을 여러 번 주는 경우를 막기 위해 최대 수정 횟수를 둘 수 있습니다.
여기서 finalize는 "무조건 고객에게 발송한다"는 뜻이 아닙니다. 예제에서는 그래프를 끝내고 결과를 반환하는 노드입니다. 승인된 경우에는 그대로 최종 답변으로 넘기고, 수정 횟수를 초과해 종료된 경우에는 추가 검토가 필요하다는 표시를 붙입니다. 실제 서비스에서 발송, 결제, 삭제처럼 되돌리기 어려운 작업을 한다면 반드시 승인 여부를 별도로 확인한 뒤 실행해야 합니다.
분기 함수는 상태를 보고 다음 노드를 결정합니다.
def route_after_review(state: WritingState) -> Literal['finalize', 'revise_draft']:
    if state.get('approved'):
        return 'finalize'

    if state.get('revision_count', 0) >= 2:
        return 'finalize'

    return 'revise_draft'
이 함수는 모델이 아니라 애플리케이션 코드입니다. 그래서 중요한 업무 규칙을 명확하게 강제할 수 있습니다. "승인되면 최종화한다", "승인되지 않았고 수정 횟수가 남아 있으면 수정한다", "정해진 횟수를 넘으면 자동 수정 루프를 멈춘다" 같은 규칙은 프롬프트에만 맡기지 않는 편이 안전합니다.
사람 검토를 중간에 삽입하기
사람 검토가 필요한 이유는 단순합니다. LLM이 만든 결과가 항상 바로 실행되어서는 안 되기 때문입니다. 고객에게 발송되는 메일, 계약서 초안, 비용이 발생하는 API 호출, 데이터 삭제 작업은 사람이 확인해야 할 수 있습니다.
LangGraph에서는 interrupt()를 사용해 그래프 실행을 중간에 멈추고, 외부 입력을 받은 뒤 이어서 진행할 수 있습니다. 단, 여기서 "이어서 진행한다"는 말은 프로그램 카운터가 정확히 같은 줄에서 계속된다는 뜻이 아닙니다. LangGraph는 체크포인터에 저장된 상태를 불러온 뒤, 중단된 노드를 다시 실행하고, Command(resume=...)로 넘긴 값이 interrupt()의 반환값이 되도록 처리합니다3. 그래서 interrupt() 앞에 외부 API 호출이나 데이터베이스 쓰기처럼 반복되면 안 되는 부작용을 두지 않는 것이 좋습니다.
중단 후 재개하려면 상태를 저장할 체크포인터와 실행을 구분할 thread_id가 필요합니다. 개발 단계에서는 메모리 기반 체크포인터로 흐름을 확인할 수 있습니다.
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.types import interrupt, Command

checkpointer = InMemorySaver()


def human_review(state: WritingState):
    review = interrupt({
        'draft': state['draft'],
        'message': '초안을 검토하세요. 승인하려면 approve, 수정하려면 revise를 선택하세요.',
    })

    if review.get('decision') == 'approve':
        return {
            'approved': True,
            'feedback': '',
        }

    return {
        'approved': False,
        'feedback': review.get('feedback', ''),
}interrupt()에 넘기는 값은 호출자에게 보여 줄 데이터입니다. 웹 애플리케이션이라면 이 payload를 받아 검토 화면에 초안을 표시할 수 있습니다. 이 값은 JSON으로 직렬화할 수 있는 단순한 형태로 유지하는 편이 좋습니다.
이제 앞에서 만든 노드들을 그래프로 연결합니다.
from langgraph.graph import StateGraph, START, END

builder = StateGraph(WritingState)

builder.add_node('search_docs', search_docs)
builder.add_node('write_draft', write_draft)
builder.add_node('human_review', human_review)
builder.add_node('revise_draft', revise_draft)
builder.add_node('finalize', finalize)

builder.add_edge(START, 'search_docs')
builder.add_edge('search_docs', 'write_draft')
builder.add_edge('write_draft', 'human_review')

builder.add_conditional_edges(
    'human_review',
    route_after_review,
    {
        'finalize': 'finalize',
        'revise_draft': 'revise_draft',
    },
)

builder.add_edge('revise_draft', 'human_review')
builder.add_edge('finalize', END)

graph = builder.compile(checkpointer=checkpointer)
이 구조의 장점은 흐름이 코드에 드러난다는 것입니다. 어느 단계가 반복될 수 있는지, 사람이 어디서 개입하는지, 최종 종료 지점이 어디인지 한눈에 볼 수 있습니다.
실행할 때는 thread_id를 함께 넘깁니다. thread_id는 이 워크플로 실행을 구분하는 식별자입니다. 앞에서 대화 기록을 세션 ID로 나누었던 것과 비슷합니다.
config = {'configurable': {'thread_id': 'writing-job-001'}}

first_result = graph.invoke(
    {'question': '신규 온보딩 문서를 작성해 주세요.'},
    config=config,
)

print(first_result.get('__interrupt__'))
그래프는 human_review에서 멈추고, 기본 invoke() 호출에서는 반환값에 __interrupt__ 정보가 포함됩니다. 애플리케이션은 이 정보를 이용해 사용자에게 초안을 보여 줍니다. 스트리밍 방식으로 실행한다면 interrupt 정보가 스트림 이벤트에 별도로 드러나므로, UI가 필요한 서비스에서는 스트리밍 실행 방식을 함께 검토할 수 있습니다3.
사용자가 수정 의견을 입력하면 같은 thread_id로 재개합니다.
second_result = graph.invoke(
    Command(resume={
        'decision': 'revise',
        'feedback': '보안 정책 설명을 더 짧고 명확하게 줄여 주세요.',
    }),
    config=config,
)
수정된 초안은 다시 human_review로 돌아갑니다. 이 호출도 다시 사람 검토 지점에서 멈출 수 있습니다. 사용자가 승인하면 같은 방식으로 재개하고, 그래프는 최종 노드로 이동합니다.
final_result = graph.invoke(
    Command(resume={'decision': 'approve'}),
    config=config,
)

print(final_result['final_answer'])
설치된 LangGraph 버전에 따라 메모리 체크포인터 예제가 MemorySaver라는 이름으로 보일 수도 있고, InMemorySaver라는 이름으로 보일 수도 있습니다. 핵심은 같습니다. 메모리에 체크포인트를 저장하는 방식은 개발과 테스트에는 편하지만, 서버가 재시작되면 상태가 사라질 수 있습니다. 실제 서비스에서는 PostgreSQL이나 SQLite 같은 저장소 기반 체크포인터를 사용하고, 누가 언제 승인했는지 감사 로그를 별도로 남기는 것이 좋습니다4.
그래프 설계 기준
LangGraph를 사용할 때 가장 중요한 설계 기준은 "모델에게 맡길 결정"과 "코드로 고정할 규칙"을 나누는 것입니다.
예를 들어 초안 문장을 어떻게 자연스럽게 고칠지는 모델이 잘합니다. 반면 승인되지 않은 문서를 발송하지 않는 규칙, 최대 수정 횟수, 특정 도구 호출 전 사용자 확인 같은 규칙은 코드로 강제해야 합니다. 예제에서 route_after_review가 조건을 직접 판단하는 이유도 여기에 있습니다.
노드를 나누는 기준도 중요합니다. 모든 작업을 하나의 노드에 넣으면 그래프를 쓰는 의미가 줄어듭니다. 반대로 너무 잘게 나누면 상태와 엣지가 복잡해집니다. 보통 다음 기준에 해당하면 별도 노드로 분리할 만합니다.
외부 서비스를 호출한다.
실패했을 때 재시도 방식이 다르다.
중간 결과를 관찰하거나 저장해야 한다.
사람 검토가 들어갈 수 있다.
다른 워크플로에서도 재사용할 수 있다.
상태에는 필요한 값만 남깁니다. 모든 프롬프트, 전체 로그, 거대한 문서 원문을 계속 들고 다니면 비용과 복잡도가 커집니다. 원본 로그는 별도 저장소에 남기고, 그래프 상태에는 다음 단계에 필요한 식별자와 요약 정보만 유지하는 편이 안전합니다.
마지막으로 종료 조건을 반드시 두어야 합니다. 반복이 있는 그래프에는 최대 반복 횟수, 최대 도구 호출 수, 시간 제한, 실패 시 종료 경로가 필요합니다. 복잡한 에이전트가 위험해지는 지점은 대개 "언제 멈출지"가 명확하지 않을 때입니다.
복잡한 에이전트를 더 예측 가능하게 만들기
앞에서 본 에이전트는 모델이 도구를 선택하고, 결과를 읽고, 다시 다음 행동을 결정하는 반복 구조였습니다. 이 방식은 유연하지만, 업무 절차가 중요할수록 모든 결정을 모델에게 맡기기 어렵습니다.
LangGraph를 사용하면 에이전트의 자유도를 필요한 만큼만 열어 둘 수 있습니다. 예를 들어 검색 노드 안에서는 모델이 검색어를 재작성하게 할 수 있습니다. 초안 작성 노드 안에서는 LCEL 체인으로 문서를 작성하게 할 수 있습니다. 하지만 승인 분기, 수정 횟수, 최종 발송 여부는 그래프의 엣지와 상태로 통제합니다.
이렇게 설계하면 복잡한 LLM 애플리케이션을 더 안전하게 운영할 수 있습니다.
현재 단계가 상태로 남는다.
중간 결과를 확인하고 디버깅할 수 있다.
실패한 지점부터 재개할 수 있다.
사람 검토를 자연스럽게 넣을 수 있다.
업무 규칙을 프롬프트가 아니라 코드로 강제할 수 있다.
정리하면, 단순한 입력-출력 흐름은 LCEL로 충분합니다. 하지만 조건 분기, 반복, 승인, 장기 상태가 필요해지는 순간에는 그래프가 더 명확합니다. LangGraph는 복잡한 에이전트를 더 거창하게 만드는 도구가 아니라, 복잡성을 눈에 보이는 구조로 꺼내는 도구입니다.
참고
1Workflows and agents - Docs by LangChain
2Thinking in LangGraph - Docs by LangChain
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.