


분석 엔진은 '요약 버튼'이 아니다
업로드 기능까지 만들면 다음 유혹이 온다. 리뷰 목록을 AI API에 그대로 보내고 "요약해줘"라고 요청하는 것이다. 데모는 금방 나온다. 하지만 고객이 돈을 내는 결과물은 여기서 나오지 않는다.
우리 서비스의 고객은 음식점·카페 사장님이다. 이분들이 원하는 것은 리뷰의 문학적인 요약이 아니다. 오늘 무엇을 고쳐야 하는지, 어떤 강점을 더 밀어야 하는지, 답글과 홍보 문구에 어떤 말을 써야 하는지다.
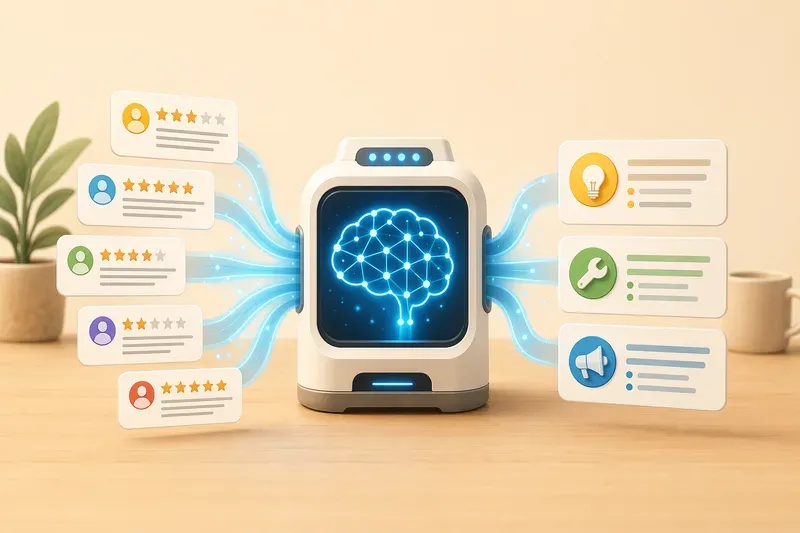
그래서 AI 분석 엔진은 하나의 거대한 프롬프트가 아니라 작은 판단 단계의 묶음으로 설계한다.
리뷰를 긍정, 부정, 중립, 혼합으로 나눈다.
반복되는 불만을 주제별로 묶는다.
고객이 좋아하는 강점을 요약한다.
개선 액션을 우선순위로 제안한다.
답글 초안과 마케팅 문구로 바꾼다.
이렇게 쪼개면 결과가 흔들릴 때 원인을 찾기 쉽다. 감성 분류가 틀렸는지, 불만 묶음이 너무 넓은지, 액션 제안이 추상적인지 구분할 수 있다.
 AI 생성 이미지
작업 흐름부터 고정하기
이전 장에서 우리는 analysis_jobs와 reports 테이블을 만들었다. 업로드 직후 자동 분석하지 않고, 사용자가 미리보기를 확인한 뒤 분석 요청 버튼을 누르게 했다. 이 흐름은 비용 통제에 중요하다.
MVP의 분석 흐름은 다음과 같다.
// 개념 흐름
async function runAnalysisJob(jobId: string) {
  const job = await getAnalysisJob(jobId)
  await markJobRunning(jobId)

  try {
    const reviews = await getReviewsByBatch(job.batch_id)
    const chunks = splitReviewsIntoChunks(reviews)

    const partialResults = []
    for (const chunk of chunks) {
      const result = await analyzeReviewChunk(chunk)
      partialResults.push(result)
    }

    const finalReport = await mergePartialResults(partialResults)
    await saveReport(job, finalReport)
    await markJobCompleted(jobId)
  } catch (error) {
    await markJobFailed(jobId, error)
  }
}
처음부터 복잡한 큐 시스템을 붙일 필요는 없다. 다만 함수 안의 단계를 분리해야 한다. 나중에 리뷰 수가 늘어나거나 실행 시간이 길어지면 analyzeReviewChunk와 mergePartialResults만 백그라운드 작업으로 옮기면 된다.
첫 버전에서는 한 번에 30~100개 리뷰를 안정적으로 처리하는 것을 목표로 잡는다. 고객에게 "최근 3개월 리뷰를 넣어보세요"라고 말했으니, 이 정도 규모가 자연스럽다.
분석 단계를 작게 나눈다
리포트의 최종 결과는 보기 좋아야 하지만, 내부 분석은 기계적으로 나누는 편이 좋다. 예를 들어 리뷰 80개를 한 번에 넣고 다음과 같이 요청하면 결과가 쉽게 흐려진다.
"이 리뷰들을 분석해서 문제점과 마케팅 문구를 알려줘."
AI는 그럴듯한 글을 만들 수 있지만, 어떤 리뷰를 근거로 삼았는지 불분명해진다. 대신 청크별 분석 결과를 다음 구조로 받는다.
{
  "summary": "전반적으로 커피 맛과 분위기에 대한 칭찬이 많지만, 피크 시간대 대기와 직원 응대 속도에 대한 불만이 반복됩니다.",
  "sentiment_counts": {
    "positive": 18,
    "neutral": 4,
    "negative": 6,
    "mixed": 2
  },
  "complaint_topics": [
    {
      "topic": "대기 시간",
      "count": 7,
      "severity": "high",
      "evidence": ["주말에는 주문하고 20분 넘게 기다렸어요", "사람이 많을 때 안내가 없어서 답답했습니다"],
      "confidence": 0.86
    }
  ],
  "strength_topics": [
    {
      "topic": "시그니처 라떼 맛",
      "count": 11,
      "evidence": ["라떼가 고소하고 진해서 또 올 것 같아요"],
      "confidence": 0.9
    }
  ]
}
여기서 중요한 필드는 evidence와 confidence다. evidence는 근거 문장이다. 고객은 AI의 결론보다 "어떤 리뷰 때문에 이런 말이 나왔는지"를 보고 신뢰한다. confidence는 신뢰도다. 정답률을 보장하는 숫자가 아니라, AI가 근거의 반복성과 명확성을 얼마나 높게 봤는지 표시하는 참고 값이다.
프롬프트에는 네 가지를 반드시 넣는다
AI 분석의 품질은 모델 이름만으로 결정되지 않는다. 같은 모델을 써도 프롬프트가 흐리면 결과도 흐리다. 특히 리포트처럼 데이터베이스에 저장해야 하는 결과는 출력 형식이 일정해야 한다.
프롬프트에는 최소 네 가지가 들어가야 한다.
역할: 너는 누구의 관점에서 분석하는가
입력 형식: 어떤 데이터가 들어오는가
출력 JSON 스키마: 어떤 필드로 답해야 하는가
금지 사항: 무엇을 추측하거나 생성하면 안 되는가
구조화된 응답은 단순히 "JSON으로 답해줘"라고 말하는 것보다 스키마를 명확히 줄수록 안정적이다. 일부 AI API는 도구 호출이나 JSON 스키마 기반 출력 강제를 지원하며, 이런 방식은 프롬프트만으로 형식을 맞추는 것보다 일관성과 검증 면에서 유리하다.1
예제 프롬프트는 다음처럼 시작할 수 있다.
너는 음식점·카페 리뷰를 분석해 사장님이 실행할 수 있는 개선 액션을 제안하는 SaaS의 분석 엔진이다.

목표:
- 리뷰 묶음에서 반복 불만, 강점, 개선 우선순위를 찾는다.
- 과장된 진단을 하지 않는다.
- 리뷰에 없는 사실을 만들지 않는다.
- 사장님이 바로 이해할 수 있는 짧고 구체적인 문장으로 쓴다.

입력:
- store_name: 매장명
- business_type: 업종
- reviews: 리뷰 배열
  - rating: 별점 또는 null
  - visited_at: 방문일 또는 null
  - content: 리뷰 본문

출력:
반드시 아래 JSON 구조로만 답한다.
그다음 실제 JSON 구조를 붙인다. 처음부터 너무 복잡하게 만들지 않는다. 중첩이 깊어질수록 오류가 늘어난다.
{
  "overall_summary": "string",
  "sentiment_counts": {
    "positive": "number",
    "neutral": "number",
    "negative": "number",
    "mixed": "number"
  },
  "top_complaints": [
    {
      "topic": "string",
      "description": "string",
      "count": "number",
      "severity": "low | medium | high",
      "evidence": ["string"],
      "confidence": "number"
    }
  ],
  "top_strengths": [
    {
      "topic": "string",
      "description": "string",
      "count": "number",
      "evidence": ["string"],
      "confidence": "number"
    }
  ]
}
위 예시는 실제 값이 아니라 "어떤 타입의 값이 와야 하는지"를 보여주는 구조다. 실제 API에서 JSON 스키마를 지원한다면 number, string, array 같은 타입을 스키마 문법에 맞게 지정하고, 코드에서는 그 스키마로 응답을 검증한다.
금지 사항도 분명히 적는다.
금지 사항:
- 리뷰에 없는 메뉴명, 직원명, 가격 정보를 만들지 않는다.
- 의료, 법률, 위생 사고처럼 심각한 단정이 필요한 표현은 추측하지 않는다.
- evidence에는 입력 리뷰에 실제로 있는 문장만 넣는다.
- confidence는 0부터 1 사이 숫자로 쓴다.
- JSON 외의 설명 문장을 출력하지 않는다.
이 금지 사항은 사소해 보이지만 운영에서 큰 차이를 만든다. AI가 "직원 교육이 부족합니다"라고 단정하는 것과 "응대 속도에 대한 불만이 반복됩니다"라고 말하는 것은 다르다. 전자는 사장님에게 방어심을 만들 수 있고, 후자는 검토 가능한 신호가 된다.
긴 리뷰는 나누고, 결론은 합친다
리뷰가 많아지면 한 번에 넣는 방식은 비용과 품질 양쪽에서 불리하다. 입력이 길수록 토큰 비용이 늘고, 모델이 앞부분이나 뒷부분 일부에 치우칠 수 있다.
그래서 리뷰 묶음을 일정 크기로 나눈다.
function splitReviewsIntoChunks(reviews: Review[]) {
  const chunkSize = 30
  const chunks = []

  for (let i = 0; i < reviews.length; i += chunkSize) {
    chunks.push(reviews.slice(i, i + chunkSize))
  }

  return chunks
}
청크 크기는 정답이 없다. 리뷰가 짧으면 50개도 가능하고, 긴 리뷰가 많으면 20개가 적당할 수 있다. 첫 버전에서는 단순히 개수 기준으로 나누고, 이후 평균 글자 수와 AI API 비용을 보며 조정한다.
청크 분석이 끝나면 mergePartialResults 단계에서 최종 리포트를 만든다. 이때는 원본 리뷰 전체를 다시 넣지 않는다. 각 청크의 요약 결과만 넣어 비용을 줄인다.
최종 병합 프롬프트의 목표는 다르다.
같은 불만 주제를 합친다.
빈도가 높은 주제를 위로 올린다.
심각도와 실행 가능성을 기준으로 개선 우선순위를 정한다.
사장님에게 보여줄 문장으로 다듬는다.
답글 초안과 마케팅 문구를 만든다.
예를 들어 "대기 시간", "주문 지연", "피크타임 혼잡"은 따로 보일 수 있지만 최종 리포트에서는 하나의 주제로 합치는 편이 낫다. 고객에게 필요한 것은 AI가 찾은 모든 라벨이 아니라, 의사결정 가능한 묶음이다.
개선 액션은 '좋은 말'이 아니라 실행 단위여야 한다
많은 AI 리포트가 실패하는 지점은 액션 제안이다. "서비스 품질을 개선하세요", "고객 응대를 강화하세요"는 맞는 말이지만 쓸모가 작다.
우리 서비스의 개선 액션은 다음 네 가지를 포함해야 한다.
무엇을 바꿀지
왜 우선순위가 높은지
이번 주에 할 수 있는 작은 실행은 무엇인지
어떤 리뷰 근거가 있는지
출력 예시는 다음과 같다.
{
  "priority_actions": [
    {
      "title": "주말 피크 시간대 예상 대기 안내 문구 추가",
      "why": "대기 시간 불만이 여러 리뷰에서 반복되며, 맛에 만족한 고객도 대기 경험 때문에 평가를 낮추고 있습니다.",
      "first_step": "토요일·일요일 12~15시에 계산대와 입구에 '주문 후 제조까지 10~15분 소요될 수 있습니다' 안내를 붙입니다.",
      "expected_impact": "불확실성으로 인한 불만을 줄이고, 직원에게 반복 문의가 몰리는 상황을 줄일 수 있습니다.",
      "evidence": ["주문하고 얼마나 기다려야 하는지 몰라서 답답했어요"],
      "confidence": 0.82
    }
  ]
}
이 정도로 써야 사장님이 "그래서 오늘 뭘 하지?"라는 질문에 답을 얻는다. AI 분석 엔진의 가치는 화려한 표현이 아니라 실행 가능한 구체성에서 나온다.
마케팅 문구도 근거에서 출발한다
리뷰 분석 결과는 운영 개선에만 쓰지 않는다. 긍정 리뷰에서 반복되는 강점은 마케팅 문구의 재료가 된다.
예를 들어 고객들이 "라떼가 고소하다", "조용해서 작업하기 좋다", "디저트가 과하지 않다"라고 반복해서 말한다면 광고 문구는 이렇게 바뀔 수 있다.
"고소한 라떼와 조용한 분위기를 찾는 분들을 위한 동네 카페"
"달지 않은 디저트와 진한 커피가 있는 오후 작업 공간"
"리뷰에서 가장 많이 언급된 메뉴: 시그니처 라떼"
여기서도 AI가 없는 말을 만들면 안 된다. "프리미엄 원두", "수제 디저트", "예약 필수 맛집" 같은 표현은 실제 리뷰나 매장 정보에 없으면 제외한다. 마케팅 문구는 매력적이어야 하지만, 고객의 실제 경험과 어긋나면 리뷰 관리 서비스의 신뢰를 해친다.
저장은 원본 응답이 아니라 제품 구조로 한다
AI 응답을 그대로 큰 텍스트 하나로 저장하면 빠르다. 예를 들어 reports에 raw_response나 content 같은 컬럼을 하나 만들고 응답 전문을 넣는 방식이다. 하지만 나중에 화면을 만들 때 불편해진다. 리포트 화면은 요약, 반복 불만, 강점, 개선 액션, 답글 초안, 마케팅 문구를 각각 다른 컴포넌트로 보여줘야 한다.
따라서 reports에는 화면 구조에 맞춘 JSON을 저장한다. 이전 장에서 잡아둔 summary, complaint_patterns, praise_patterns, action_items, reply_templates, marketing_copy 같은 컬럼에 나누어 저장해도 되고, 하나의 JSONB 컬럼을 두어 아래 구조를 담아도 된다. 중요한 것은 AI의 원본 문장을 그대로 믿고 저장하는 것이 아니라, 제품에서 쓰는 구조로 검증한 뒤 저장하는 것이다.
{
  "overall_summary": "string",
  "complaint_topics": [],
  "strength_topics": [],
  "priority_actions": [],
  "reply_templates": [],
  "marketing_copy": [],
  "analysis_meta": {
    "review_count": 82,
    "model": "사용한 모델명",
    "created_at": "2026-07-19T00:00:00.000Z"
  }
}
그리고 저장 전에는 최소 검증을 한다.
필수 필드가 있는가
JSON 파싱이 되는가
confidence가 0~1 사이인가evidence가 비어 있지 않은가마케팅 문구가 너무 길지 않은가
검증에 실패하면 곧바로 사용자에게 이상한 리포트를 보여주지 않는다. analysis_jobs.status를 failed로 바꾸고, 내부 오류 메시지를 남긴다. 사용자가 보는 메시지는 짧게 유지한다.
"분석 중 문제가 발생했습니다. 리뷰 수를 줄이거나 잠시 후 다시 시도해 주세요."
운영자는 별도로 오류 로그를 보고 프롬프트, 입력 데이터, API 응답 중 어디에서 문제가 생겼는지 확인하면 된다.
첫 버전의 합격 기준
AI 분석 엔진의 첫 합격 기준은 기술적으로 멋진 구조가 아니다. 사장님이 리포트를 읽고 다음 세 가지를 말할 수 있어야 한다.
"우리 가게에서 반복되는 문제가 뭔지 알겠다."
"고객들이 좋아하는 포인트가 뭔지 알겠다."
"이번 주에 무엇을 바꿀지 정할 수 있겠다."
이 기준을 통과하면 다음 장에서 리포트 경험을 화면으로 완성할 수 있다. 반대로 이 기준을 통과하지 못하면 UI를 예쁘게 만들어도 제품 가치는 약하다.
AI 제품의 핵심은 API 호출 성공이 아니다. 입력 데이터를 고객의 결정에 도움이 되는 결과물로 바꾸는 것이다. 이 장에서 만든 분석 엔진은 그 변환의 중심이다.
참고
1Structured data response with Amazon Bedrock: Prompt Engineering and Tool Use
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.