


2.8조 파라미터의 초대형 모델
Moonshot AI는 2026년 7월 Kimi K3를 자사의 최상위 모델로 발표했다. 총 파라미터는 2.8조 개이며, 네이티브 멀티모달 처리와 100만 토큰 컨텍스트를 지원한다. 장시간 이어지는 코딩과 지식 작업, 복합 추론을 주요 용도로 내세운다.1
Kimi K3는 발표와 동시에 Moonshot 웹사이트와 API에서 사용할 수 있게 됐다. 모델 가중치는 아직 공개되지 않았으며, 회사는 2026년 7월 27일까지 오픈 웨이트를 배포하겠다고 예고했다. 따라서 발표 시점에는 API로 성능을 시험할 수 있지만, 모델을 직접 내려받아 구조와 동작을 검증하거나 자체 환경에서 재현할 수는 없다.
'최초의 오픈 3T급 모델'이라는 의미
Moonshot은 Kimi K3를 최초의 '오픈 3T급 모델'로 규정한다. 실제 규모는 2.8조 파라미터이므로 3조에 가까운 모델군이라는 의미에서 반올림한 표현이다. 예정대로 가중치가 공개된다면, 프런티어급 초대형 모델을 API뿐 아니라 직접 운영하고 연구할 수 있는 선택지가 넓어진다는 의미가 있다.
직전 최대 규모로 거론된 DeepSeek v4 Pro의 1.6조 파라미터와 비교하면 Kimi K3는 약 1.75배 크다. 1조 파라미터 규모인 Kimi K2.6보다는 2.8배에 달한다. 중국 AI 모델이 비용 효율만으로 경쟁하는 단계를 넘어, 절대적인 모델 규모에서도 미국의 폐쇄형 프런티어 모델과 맞붙겠다는 선언에 가깝다.
다만 파라미터 수가 곧바로 성능을 뜻하지는 않는다. 실제 추론 때 사용하는 파라미터의 범위, 모델 구조, 학습 데이터와 후처리 방식에 따라 같은 규모에서도 결과가 크게 달라진다. 더구나 가중치 공개는 오픈 소스와 같은 뜻이 아니다. 라이선스가 허용하는 상업적 이용과 수정·재배포 범위까지 확인해야 실질적인 개방성을 판단할 수 있다.
Moonshot이 제시한 경쟁 구도
Moonshot의 자체 벤치마크에서 Kimi K3는 코딩과 범용 에이전트 작업을 포함한 여러 평가에서 Claude Opus 4.8 Max와 GPT-5.5 High를 대체로 앞섰다. 반면 최상위 모델인 Claude Fable 5와 GPT-5.6 Sol에는 뒤처졌다.2
이는 Kimi K3가 프런티어 바로 아래가 아니라 최상위권 경쟁에 진입했다는 회사의 주장이다. 그러나 시험 항목과 프롬프트, 추론 예산, 도구 구성에 따라 순위가 달라질 수 있으므로 자체 발표만으로 전반적인 우위를 확정해서는 안 된다. 특히 에이전트 성능은 기반 모델뿐 아니라 검색, 도구 호출, 메모리와 실행 환경을 결합하는 방식에도 크게 좌우된다.
독립 평가에서 확인된 지식 작업 성능
Artificial Analysis의 비공개 장기 지식 작업 평가에서 Kimi K3는 Elo 1547을 기록했다. Kimi K2.6보다 732점 상승한 결과이며, Claude Fable 5에 이어 두 번째에 해당한다. 이 평가는 단순 질의응답보다 분석 품질과 결과물 구성, 요구 조건 충족 여부를 종합해 장시간 지식 작업 능력을 측정한다.3
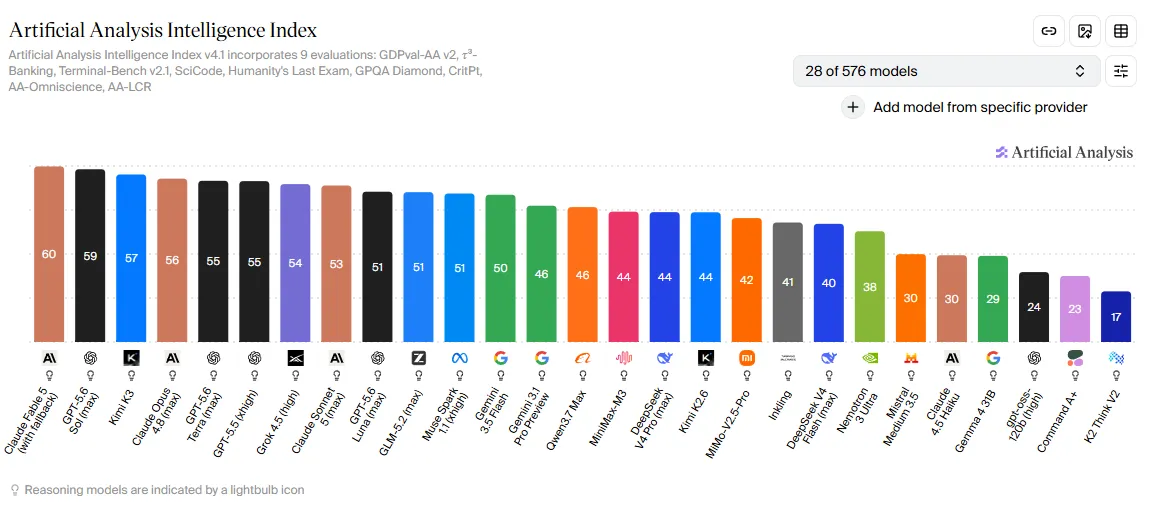
Artificial Analysis Intelligence Index 기준 작업당 비용은 0.94달러였다. GPT-5.6 Sol의 1.04달러와 비슷하고 Claude Opus 4.8의 1.80달러보다는 약 절반이지만, 다른 오픈 웨이트 계열 모델보다는 높다. 여기서 작업당 비용은 API의 명목 토큰 가격이 아니라, 평가에 실제로 들어간 입력·출력 토큰과 각 시험의 가중치를 반영한 수치다.
효율 측면에서는 K2.6보다 작업당 출력 토큰을 21% 적게 사용했다. 출력 단가가 크게 올랐음에도 실제 작업 비용이 어느 정도 억제된 이유를 보여준다. 답변을 무조건 길게 생성하기보다 더 적은 토큰으로 과제를 해결한다면 높은 토큰 단가의 부담을 일부 상쇄할 수 있다.
프런트엔드 코딩 선두
Kimi K3는 Arena.ai의 프런트엔드 코딩 부문에서 Claude Fable 5를 넘어 선두에 올랐다. Arena는 실제 사용자가 모델의 결과물을 비교해 선호도를 축적하기 때문에, 정답이 명확한 전통적 코딩 시험과는 다른 관점을 제공한다.4
이 기록은 Kimi K3가 코드의 문법적 정확성만이 아니라 화면 구성과 사용성, 시각적 완성도가 중요한 웹 프런트엔드 생성에서도 경쟁력이 있음을 보여준다. 다만 Arena 순위 역시 참여자 구성과 표본 수, 모델 업데이트에 따라 계속 바뀔 수 있으므로 고정된 서열로 받아들일 수는 없다.
API 가격과 전략의 변화
Kimi K3의 API 가격은 입력 100만 토큰당 3달러, 출력 100만 토큰당 15달러다. Kimi K2.6의 입력 0.95달러, 출력 4달러와 비교하면 각각 약 3.2배와 3.75배로 올랐다. 중국 AI 연구소가 내놓은 모델 가운데 가장 높은 가격대이며, 저렴한 API를 앞세웠던 기존 중국 모델들과 다른 전략이다.4
특히 출력 중심 서비스에서는 15달러라는 단가가 크게 작용한다. 코드 생성, 보고서 작성, 장시간 에이전트 실행처럼 출력량이 많은 작업은 K2.6보다 비용 증가를 체감하기 쉽다. 반대로 K3가 평가 결과처럼 더 적은 토큰으로 작업을 끝내고 재시도 횟수까지 줄인다면, 실제 총비용은 단순한 토큰 단가 차이보다 작아질 수 있다.
이 가격은 Moonshot이 K3를 저가 대체재보다 프런티어급 제품으로 판매하려 한다는 신호이기도 하다. 높은 가격을 유지하려면 규모 자체가 아니라 더 높은 성공률, 짧은 작업 시간, 우수한 코딩 결과처럼 비용 상승을 정당화할 실질적 가치가 필요하다.
오픈 웨이트 공개 후 확인할 과제
Kimi K3의 초기 결과는 초대형 오픈 웨이트 모델이 폐쇄형 최상위 모델과 경쟁할 수 있다는 가능성을 보여준다. 2.8조 파라미터라는 규모, 장기 지식 작업의 큰 성능 향상, 프런트엔드 코딩 선두 기록은 분명 주목할 만하다.
하지만 현재 수치만으로 결론을 내리기는 이르다. 벤치마크 성능은 프롬프트와 추론 설정, 도구 사용, 평가 표본에 따라 달라지며, 실제 제품 환경에서는 지연시간과 안정성, 환각, 도구 호출 실패, 긴 문맥에서의 일관성이 더 중요할 수 있다.
7월 27일까지로 예고된 가중치 공개 이후에는 모델 구조와 실행에 필요한 하드웨어, 자체 배포 비용, 라이선스, 양자화 가능성, 동일 조건에서의 재현성을 검증해야 한다. Kimi K3의 진짜 의미는 '3T급'이라는 숫자보다, 이 거대한 모델을 외부 개발자가 실제로 운영하고 반복 검증할 수 있는 형태로 공개하느냐에 달려 있다.
참고
2CNBC - Chinese AI has leveled up, and brought renewed focus on the open weight model shift
3Artificial Analysis - Kimi K3 Intelligence, Performance & Price Analysis
4AP - Chinese AI model takes US tech industry by surprise with abilities rivaling Claude and ChatGPT
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.