

밝혀둡니다. 저는 음성 제어 텔레프롬프터 VoiceScroll을 만들고 있고, 이 글의 예시로 씁니다. 아래 원리는 음성 제어 텔레프롬프터 전반에 해당합니다.
일반 텔레프롬프터는 내가 정한 속도로 텍스트가 흘러갑니다. 재생을 누르면 글이 움직이고, 나는 그 속도를 쫓거나 기다립니다. 음성 제어 방식은 다릅니다. 내가 말하는 걸 듣고 거기에 맞춰 텍스트를 움직입니다. 구현 관점에서 어떻게 되는지 적어봅니다.
고정 속도가 불편한 이유
사람은 일정한 속도로 말하지 않습니다. 익숙한 대목은 빨라지고, 중요한 부분은 느려지고, 생각 사이에 멈춥니다. 한 문장 안에서도 속도가 눈에 띄게 바뀝니다. 고정 속도 텔레프롬프터는 이걸 무시하니까, 자연스럽게 말하는 대신 기계 속도에 나를 맞추게 됩니다. 제 경험상 그러면 전달이 밋밋해지고 재촬영이 늘어납니다.
음성 매칭이 돌아가는 방식
VoiceScroll 같은 음성 제어 앱에 대본을 넣으면 대략 이렇게 동작합니다.
대본을 단어 단위로 쪼개 매칭용 인덱스를 만듭니다.
시작을 누르면 마이크가 켜지고 기기의 음성인식이 오디오를 처리하기 시작합니다.
말하면 그 말을 실시간으로 텍스트로 바꿔 대본과 대조합니다.
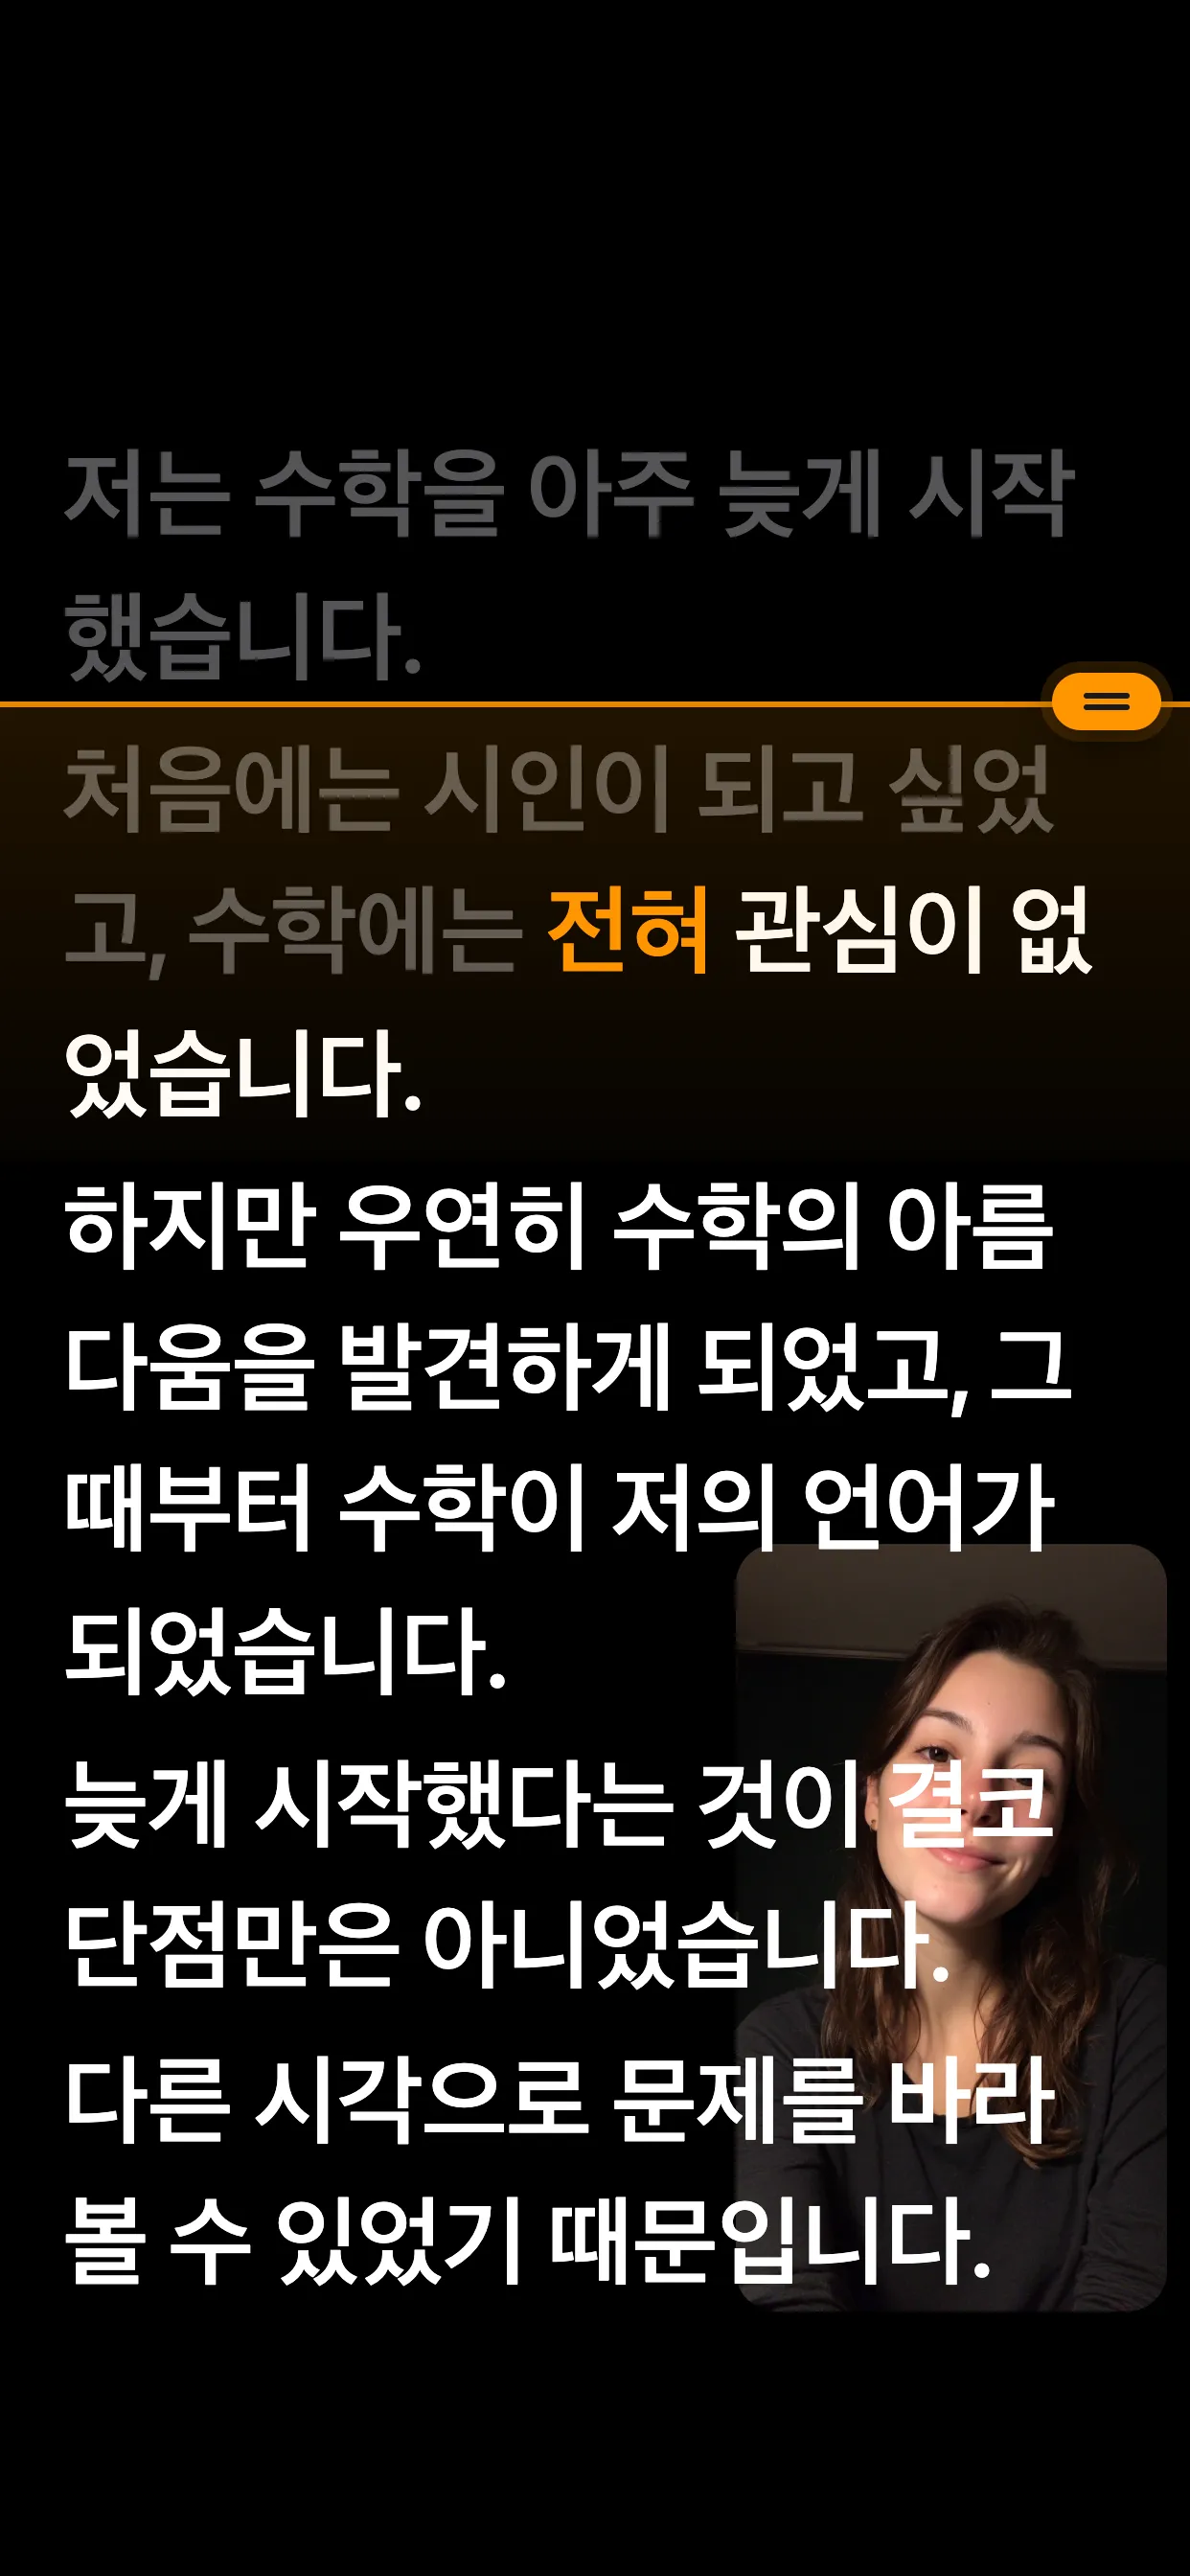
현재 단어가 강조되고, 이미 말한 단어는 흐려지고, 화면은 내 위치가 보이도록 스크롤됩니다.
멈추면 아무것도 안 움직이고, 앞서 나가면 실제 위치로 따라옵니다. 마법은 아니어서 단어를 놓치거나 소음이 심하면 어긋날 수 있지만, 일반적인 환경에선 잘 따라옵니다.
왜 기기 안에서 처리하나
VoiceScroll은 이 과정 전체를 기기 안에서 플랫폼의 음성인식으로 돌립니다. 두 가지가 여기서 나옵니다. 오디오가 폰을 벗어나지 않아 프라이버시에 유리하고, 네트워크 왕복이 없어 매칭이 지연 없이 즉각적으로 느껴집니다.
언어 목록이 생각보다 중요한 이유
VoiceScroll은 9개 언어를 지원합니다. 영어, 한국어, 일본어, 중국어(간체·번체), 독일어, 프랑스어, 포르투갈어, 스페인어입니다. 각 언어는 영어 모델에 번역을 붙인 게 아니라 그 언어 자체의 음성 모델을 씁니다.
이 차이는 한국어나 일본어, 중국어로 녹화해보면 확실합니다. 단어 경계와 글자 처리가 영어와 완전히 다르기 때문에, 그 언어용 모델이 훨씬 안정적으로 따라옵니다.
어디에 잘 맞나
중간에 끊기거나 멈춰야 하는 라이브 발표
두 개 이상의 언어를 오가는 콘텐츠
고정 스크롤 속도 맞추기가 늘 불편했던 사람, 꽤 많습니다
고정 속도도 되긴 됩니다. 다만 내가 어떻게 말하는지에 대한 가정 위에 서 있고, 그 가정이 보통 안 맞습니다. 텍스트가 내 목소리를 따라오게 하면 그 가정이 사라집니다. 몇 번 찍어보면 대부분 스크롤을 신경 안 쓰게 되는데, 그게 목적입니다.
직접 대본으로 음성 추적을 시험해보고 싶다면 VoiceScroll 무료 버전이 여기 있습니다: https://www.voice-scroll.com/ko
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.