


한 대의 서버에 모든 것을 맡기면 생기는 문제
앞 장까지 우리는 EC2로 서버를 만들고, RDS와 DynamoDB로 데이터를 저장하는 방법을 배웠다. 이제 웹 서비스의 다음 고민은 "사용자가 많아지면 어떻게 버틸까?"이다.
처음에는 EC2 한 대로도 충분해 보인다. 사용자는 서버의 퍼블릭 IP나 도메인으로 접속하고, 서버는 웹 페이지를 응답한다. 구조가 단순해서 이해하기 쉽다. 하지만 이 구조에는 큰 약점이 있다.
서버 한 대가 멈추면 서비스 전체가 멈춘다. 접속자가 갑자기 늘어 CPU와 메모리가 부족해져도 도망갈 곳이 없다. 새 버전을 배포할 때 서버를 재시작하면 그 순간 접속 중인 사용자는 오류를 볼 수 있다.
이 문제를 줄이는 기본 해법은 두 가지다.
첫째, 서버를 여러 대 둔다. 둘째, 사용자의 요청을 여러 서버에 나누어 보낸다. AWS에서는 이 역할을 주로 Application Load Balancer와 Auto Scaling Group이 함께 맡는다.
Application Load Balancer는 줄여서 ALB라고 부른다. 사용자의 HTTP 또는 HTTPS 요청을 받아 뒤쪽의 여러 EC2 인스턴스로 나누어 보내는 서비스다. Auto Scaling Group은 줄여서 ASG라고 부르며, 필요한 서버 수를 유지하고 사용량에 따라 서버를 늘리거나 줄인다.
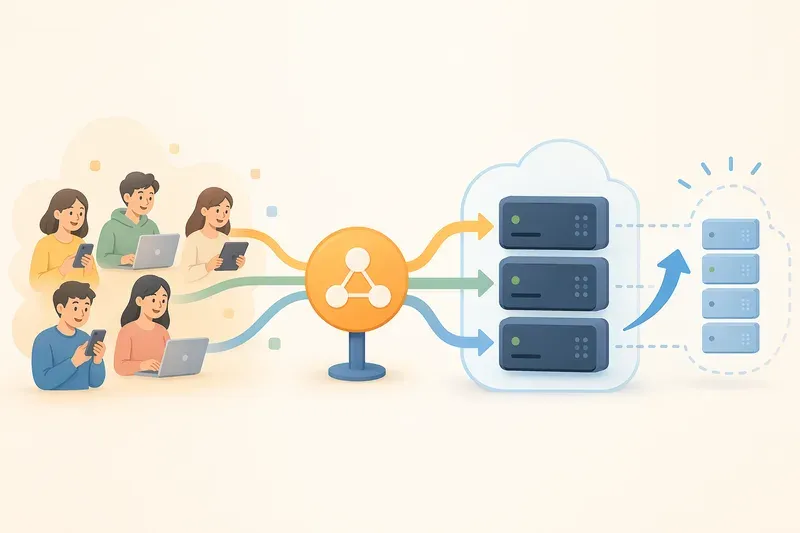 AI 생성 이미지
로드 밸런서는 식당의 안내 직원과 같다
로드 밸런서를 식당 입구의 안내 직원이라고 생각해 보자. 손님이 직접 아무 테이블로나 달려가면 어떤 테이블은 붐비고 어떤 테이블은 비어 있을 수 있다. 안내 직원은 빈자리와 상황을 보고 손님을 적절한 테이블로 보낸다.
ALB도 비슷하다. 사용자는 EC2 한 대의 주소가 아니라 ALB의 주소로 접속한다. ALB는 요청을 받아 뒤쪽의 EC2 인스턴스 중 정상 상태인 서버로 보낸다.
흐름은 다음과 같다.
사용자가 브라우저에서 웹 사이트에 접속한다.
요청이 ALB로 들어온다.
ALB의 리스너가 요청을 받는다.
리스너 규칙에 따라 요청이 대상 그룹으로 전달된다.
대상 그룹 안의 정상 EC2 인스턴스 중 하나가 요청을 처리한다.
여기서 리스너는 "어떤 문으로 들어오는 요청을 받을 것인가"를 정한다. 예를 들어 80번 포트는 HTTP, 443번 포트는 HTTPS 요청을 받는 데 사용된다.
대상 그룹은 "요청을 실제로 처리할 서버 목록"이다. EC2 인스턴스 여러 대를 하나의 대상 그룹에 넣으면, ALB는 그 그룹 안에서 정상 서버를 골라 요청을 보낸다.
초보자가 기억할 핵심은 간단하다.
사용자는 ALB를 보고, ALB는 정상 EC2를 본다.
운영 환경에서는 보통 ALB를 퍼블릭 서브넷에 연결하고, 애플리케이션 EC2는 프라이빗 서브넷에 둔다. 사용자는 ALB까지만 직접 접근하고, EC2에는 ALB만 접근하게 만드는 구조다. 이렇게 하면 EC2의 퍼블릭 노출을 줄일 수 있다.
보안 그룹도 이 흐름에 맞게 나누는 것이 좋다.
ALB 보안 그룹: 인터넷에서 80 또는 443 포트 접근 허용
EC2 보안 그룹: ALB 보안 그룹에서 들어오는 애플리케이션 포트만 허용
EC2 보안 그룹에서 0.0.0.0/0으로 웹 포트를 열어 두면 ALB를 앞에 둔 의미가 줄어든다. 사용자가 EC2에 직접 접근할 수 있기 때문이다. 로드 밸런서를 둔다면, 가능한 한 트래픽의 입구를 ALB로 모으는 것이 안전하다.
대상 그룹과 헬스 체크
ALB가 요청을 잘 나누려면 먼저 어떤 서버가 정상인지 알아야 한다. 이때 사용하는 기능이 헬스 체크다. 헬스 체크는 말 그대로 서버의 건강 상태를 확인하는 검사다.
예를 들어 대상 그룹에 EC2 세 대가 있다고 하자.
EC2-A: 정상
EC2-B: 정상
EC2-C: 애플리케이션 오류
ALB가 아무 서버로나 요청을 보내면 사용자는 가끔 오류를 보게 된다. 그래서 ALB는 정해진 경로로 주기적으로 요청을 보내 서버 상태를 확인한다. 보통 /health 같은 가벼운 주소를 만든다.
정상 서버는 이런 응답을 돌려준다.
200 OK반대로 서버가 응답하지 않거나, 너무 늦게 응답하거나, 기대한 상태 코드가 아니면 ALB는 그 대상을 비정상으로 판단한다. 비정상 대상은 트래픽 분산 대상에서 제외된다. 이후 다시 정상 응답을 일정 횟수 이상 보내면 트래픽을 받을 수 있다.
헬스 체크를 설정할 때는 다음을 확인해야 한다.
헬스 체크 경로가 실제로 존재하는가?
애플리케이션이 해당 경로에 빠르게 응답하는가?
성공으로 볼 HTTP 상태 코드가 맞게 설정되어 있는가?
EC2 보안 그룹이 ALB에서 오는 요청을 허용하는가?
애플리케이션이 헬스 체크 포트에서 실행 중인가?
특히 보안 그룹 실수가 많다. 헬스 체크 요청은 로드 밸런서에서 대상 서버로 들어오기 때문에, 대상 EC2의 보안 그룹은 특정 임의 IP가 아니라 ALB 보안 그룹에서 오는 트래픽을 허용하는 방식으로 구성하는 것이 좋다. 또한 기본 성공 응답은 보통 200으로 이해하면 쉽고, 애플리케이션의 실제 응답과 대상 그룹 설정이 맞아야 한다.1
헬스 체크 경로는 무겁게 만들지 않는 것이 좋다. /health가 매번 복잡한 데이터베이스 조회를 하거나 외부 API를 호출하면, 서버가 실제로는 괜찮은데도 일시적인 지연 때문에 비정상으로 판단될 수 있다. 처음에는 "애플리케이션 프로세스가 살아 있고 기본 응답이 가능한가" 정도를 빠르게 확인하는 경로로 시작하자.
Auto Scaling Group은 서버 수를 지키는 관리자다
ALB가 요청을 나누어 보내는 역할이라면, Auto Scaling Group은 서버 수를 관리하는 역할이다.
ASG에는 세 가지 숫자가 있다.
최소 용량: 아무리 사용자가 적어도 유지할 최소 인스턴스 수
희망 용량: 현재 유지하고 싶은 인스턴스 수
최대 용량: 자동으로 늘릴 수 있는 최대 인스턴스 수
예를 들어 다음처럼 설정할 수 있다.
최소 용량: 2
희망 용량: 2
최대 용량: 4
이 설정은 "평소에는 EC2 두 대를 유지하고, 필요하면 네 대까지 늘릴 수 있으며, 최소 두 대 아래로는 줄이지 않는다"는 뜻이다.
여기서 중요한 점은 ASG가 단순히 서버를 늘리는 도구만은 아니라는 것이다. 서버 수를 유지하는 도구이기도 하다.
희망 용량이 2인데 EC2 한 대가 장애로 종료되면, ASG는 현재 인스턴스가 한 대뿐이라는 것을 감지한다. 그리고 새 EC2를 만들어 다시 두 대를 맞춘다. 사람이 콘솔에 들어가 수동으로 인스턴스를 만들지 않아도 된다.
ASG가 새 서버를 만들려면 "어떤 서버를 만들 것인가"라는 설계도가 필요하다. 이것이 시작 템플릿이다. 시작 템플릿에는 AMI, 인스턴스 타입, 보안 그룹, IAM 역할, User Data 같은 설정이 들어간다.
정리하면 다음과 같다.
시작 템플릿: EC2를 어떻게 만들지 적어 둔 레시피
Auto Scaling Group: 그 레시피대로 EC2 수를 유지하고 조절하는 관리자
대상 그룹: ALB가 트래픽을 보낼 EC2 목록
ALB: 사용자 요청을 정상 EC2로 나누어 보내는 입구
ASG를 대상 그룹에 연결하면 새로 만들어진 EC2가 자동으로 대상 그룹에 등록된다. 그리고 대상 그룹의 헬스 체크를 통과한 뒤 트래픽을 받기 시작한다. 반대로 종료되는 인스턴스는 대상 그룹에서 빠지며, ALB는 더 이상 그 인스턴스로 새 요청을 보내지 않는다.
CPU 사용률로 서버를 늘리고 줄이는 예
자동 확장은 아무 기준 없이 일어나지 않는다. 어떤 지표를 보고 늘릴지 정해야 한다. 가장 이해하기 쉬운 기준은 CPU 사용률이다.
예를 들어 웹 서버 두 대가 있고, 평균 CPU 사용률을 50% 근처로 유지하고 싶다고 하자. ASG에 다음과 같은 정책을 만들 수 있다.
평균 CPU 사용률 목표: 50%
최소 용량: 2
희망 용량: 2
최대 용량: 4
접속자가 늘어 두 서버의 CPU 사용률이 계속 높아지면 ASG는 새 EC2를 추가한다. 이것을 스케일 아웃이라고 한다. 서버를 바깥으로 넓히듯 늘린다는 뜻이다.
반대로 사용자가 줄어 CPU 사용률이 낮게 유지되면 ASG는 인스턴스를 줄일 수 있다. 이것을 스케일 인이라고 한다. 불필요한 서버를 줄이면 비용도 줄어든다.
다만 스케일 인은 신중해야 한다. 서버를 너무 빨리 줄이면 잠깐의 트래픽 변화에도 서버가 늘었다 줄었다를 반복한다. 이런 현상을 흔히 출렁임이라고 부른다. 이를 줄이기 위해 워밍업 시간, 쿨다운 시간, 최소 용량을 적절히 둔다.
CPU만 항상 좋은 기준은 아니다. 웹 서비스에서는 "인스턴스 한 대당 요청 수"가 더 자연스러운 기준일 때도 많다. CPU는 낮지만 요청 대기 시간이 길어질 수 있고, 반대로 CPU는 높아도 사용자가 체감하는 응답은 괜찮을 수 있다. 처음에는 CPU 기준으로 원리를 익히고, 실제 서비스에서는 요청 수, 응답 시간, 큐 길이 같은 지표도 함께 보는 것이 좋다.
비용도 같이 생각해야 한다. 최대 용량을 너무 크게 열어 두면 예상보다 많은 EC2가 생성될 수 있다. 반대로 너무 작게 잡으면 트래픽 증가를 버티지 못한다. 학습 환경에서는 최대 용량을 3이나 4처럼 작게 두고, 실습 후에는 ASG, ALB, 대상 그룹, 시작 템플릿처럼 함께 만든 리소스를 확인해 비용을 정리하자. ALB는 EC2처럼 눈에 잘 띄는 서버가 아니지만 실행 중이면 비용이 발생한다.
무중단에 가까운 배포 패턴
로드 밸런서와 오토 스케일링은 장애 대응뿐 아니라 배포에도 도움이 된다.
한 대 서버에서는 새 버전을 배포할 때 선택지가 좁다. 서버를 재시작하면 그 순간 요청이 실패할 수 있다. 문제가 생기면 다시 이전 버전으로 되돌리는 것도 번거롭다.
여러 대의 EC2와 ALB를 사용하면 방식이 달라진다.
새 설정이나 새 AMI로 EC2를 만든다.
새 EC2가 대상 그룹에 등록된다.
헬스 체크를 통과할 때까지 기다린다.
정상으로 확인된 서버만 트래픽을 받는다.
기존 서버는 대상 그룹에서 천천히 제외하고 종료한다.
이런 방식은 사용자가 서비스를 계속 이용하는 동안 뒤쪽 서버를 교체할 수 있게 해 준다. AWS Auto Scaling에는 인스턴스를 순차적으로 교체하는 기능도 있어, 시작 템플릿을 새 버전으로 바꾸고 기존 인스턴스를 점진적으로 교체하는 흐름을 만들 수 있다.
물론 이것만으로 모든 배포가 완전히 무중단이 되는 것은 아니다. 기존 인스턴스를 대상 그룹에서 제외할 때도 이미 처리 중인 요청을 어떻게 마무리할지, 새 버전과 이전 버전이 잠시 함께 떠 있어도 문제가 없는지 확인해야 한다. 애플리케이션이 서버 내부 디스크에만 업로드 파일을 저장하거나, 로그인 세션을 특정 EC2 메모리에만 저장한다면 특히 문제가 생긴다. 어떤 사용자가 EC2-A에 로그인했는데 다음 요청이 EC2-B로 가면 로그인 정보가 사라질 수 있기 때문이다.
그래서 여러 서버 구조에서는 애플리케이션을 가능한 한 상태 비저장으로 만드는 것이 중요하다. 상태 비저장은 서버 한 대가 꼭 기억하지 않아도 되는 구조라는 뜻이다.
예를 들면 다음과 같다.
업로드 파일은 EC2 내부가 아니라 S3에 저장한다.
사용자 세션은 ElastiCache, DynamoDB, RDS 같은 외부 저장소에 둔다.
설정 값은 서버마다 수동으로 바꾸지 말고 시작 템플릿이나 배포 도구로 관리한다.
로그는 서버 안에만 두지 말고 CloudWatch Logs 같은 곳으로 보낸다.
이렇게 하면 EC2 한 대가 사라져도 서비스 전체가 크게 흔들리지 않는다. ALB와 ASG는 "서버는 언제든 교체될 수 있다"는 클라우드식 운영 방식을 가능하게 해 준다.
짧은 실습 흐름으로 정리하기
이번 장의 내용을 실제로 구성한다면 흐름은 다음과 같다.
간단한 웹 서버 AMI 또는 User Data를 준비한다.
시작 템플릿을 만든다.
대상 그룹을 만들고 헬스 체크 경로를
/health로 설정한다.ALB를 서로 다른 가용 영역의 퍼블릭 서브넷 두 개 이상에 만든다.
ALB 리스너 80번 포트를 대상 그룹으로 연결한다.
Auto Scaling Group을 만들고 최소 2, 희망 2, 최대 4로 설정한다.
ASG를 대상 그룹에 연결한다.
CPU 사용률 기준의 스케일링 정책을 추가한다.
ALB DNS 이름으로 접속해 여러 인스턴스가 응답하는지 확인한다.
EC2 한 대를 중지하거나 종료해 ASG가 새 인스턴스를 만드는지 확인한다.
실습 중에는 보안 그룹을 꼭 확인하자. 사용자는 ALB로 들어오고, EC2는 ALB에서 오는 요청만 받는 구조가 기본이다. RDS를 함께 사용한다면 RDS는 여전히 프라이빗 서브넷에 두고, 애플리케이션 EC2 보안 그룹에서 오는 DB 포트만 허용한다.
이제 우리는 한 대의 EC2를 넘어, 여러 서버가 함께 움직이는 구조를 이해했다. 핵심은 서비스의 입구를 ALB로 모으고, 서버 수는 ASG가 관리하게 하는 것이다. 이렇게 만들면 장애가 나도 새 서버로 회복할 수 있고, 사용자가 늘어도 자동으로 서버를 추가할 수 있다.
다음 장에서는 사용자가 더 빠르게 접속하도록 도메인, CDN, 글로벌 서비스를 연결하는 방법을 살펴본다. ALB가 애플리케이션 서버 앞의 입구라면, CDN은 전 세계 사용자 가까이에 콘텐츠를 놓아 응답 속도를 높이는 역할을 한다.
참고
1How do I troubleshoot failed health checks for my Application Load Balancer?
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.