


화면으로 익히는 PostgreSQL의 기본 구조

처음 보는 화면에서 먼저 봐야 할 것
PostgreSQL에 처음 접속하면 화면 왼쪽에 폴더가 여러 겹으로 펼쳐진 모습을 보게 됩니다. pgAdmin이든 DBeaver든 모양은 조금씩 달라도 큰 흐름은 비슷합니다.
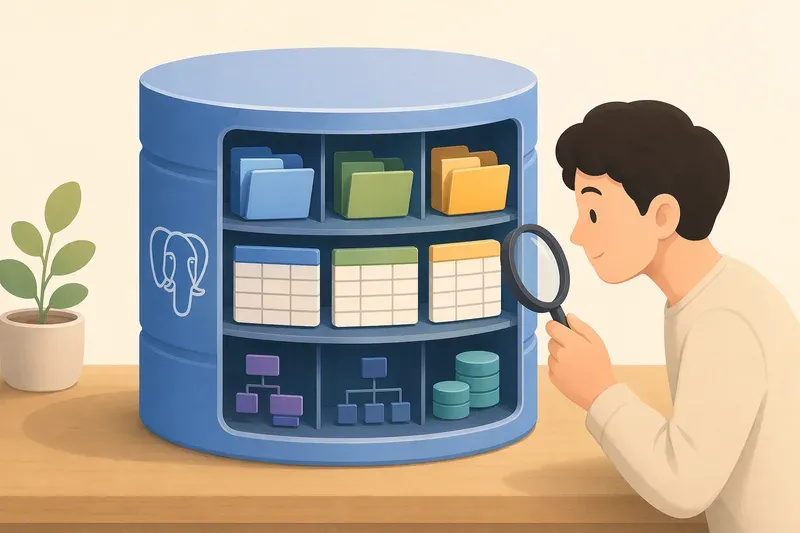
처음에는 이 화면을 데이터베이스의 지도라고 생각하면 됩니다. 지도를 볼 때 바로 목적지로 뛰어가지 않고, 내가 어느 도시와 건물 안에 있는지 확인하듯이 데이터베이스도 위에서 아래로 차근차근 확인합니다.
보통 다음 순서로 내려갑니다.
서버
데이터베이스
스키마
테이블
컬럼
데이터 행
여기서 서버는 PostgreSQL이 실행되는 공간입니다. 그 안에 여러 데이터베이스가 있을 수 있습니다. 한 회사 컴퓨터 안에 인사팀용 데이터베이스, 쇼핑몰용 데이터베이스, 테스트용 데이터베이스가 따로 있을 수 있는 식입니다.
이번 장의 목표는 복잡한 설정을 바꾸는 것이 아닙니다. 처음 보는 화면에서 길을 잃지 않고, 원하는 테이블을 찾아 열어 보고, 그 안에 어떤 항목과 데이터가 들어 있는지 확인하는 것입니다.
 AI 생성 이미지
회사 건물로 이해하는 포함 관계
PostgreSQL의 구조는 처음 들으면 낯설지만, 회사 건물에 비유하면 훨씬 쉽습니다.
데이터베이스: 회사 건물 하나
스키마: 건물 안의 부서 또는 구역
테이블: 부서 안의 서류함 또는 장부
컬럼: 장부의 항목
행: 장부에 적힌 실제 기록 한 줄
예를 들어 shop이라는 데이터베이스가 있다고 해 보겠습니다. 이 데이터베이스는 작은 쇼핑몰 회사 건물입니다. 그 안에 public이라는 스키마가 있습니다. 스키마는 테이블을 담는 구역입니다. 처음 PostgreSQL을 쓰면 대부분 public 스키마를 먼저 만나게 됩니다.
public 스키마 안에는 다음과 같은 테이블이 있을 수 있습니다.
customers: 고객 명단orders: 주문 내역products: 상품 목록
customers 테이블을 열면 컬럼이 보입니다.
customer_id: 고객 번호customer_name: 고객 이름phone: 전화번호city: 거주 지역created_at: 고객 등록일
이 컬럼들은 엑셀의 열 제목과 비슷합니다. 그리고 실제 고객 한 명의 정보가 한 줄로 들어가면 그것이 행입니다.
정리하면, 데이터베이스는 큰 보관함이고, 스키마는 그 안의 칸막이, 테이블은 장부, 컬럼은 장부의 항목, 행은 실제 기록입니다.
GUI 도구에서 테이블 찾기
이제 화면에서 테이블을 찾아보겠습니다. 도구마다 이름은 조금 다르지만 방향은 같습니다.
pgAdmin에서는 보통 다음 순서로 펼칩니다.
왼쪽의
Servers를 엽니다.접속한 서버 이름을 엽니다.
Databases를 엽니다.사용할 데이터베이스를 선택합니다.
Schemas를 엽니다.public을 엽니다.Tables를 엽니다.원하는 테이블 이름을 클릭합니다.
DBeaver에서는 보통 다음 순서로 봅니다.
왼쪽의 데이터베이스 연결을 엽니다.
사용할 데이터베이스를 펼칩니다.
Schemas또는public을 찾습니다.Tables를 엽니다.원하는 테이블을 더블 클릭합니다.
처음에는 많은 폴더가 보여도 당황하지 않아도 됩니다. 초보자가 가장 자주 볼 곳은 Schemas > public > Tables입니다. 다른 폴더들은 나중에 천천히 익혀도 됩니다.
테이블을 열면 보통 몇 가지 탭이 보입니다. 이름은 도구마다 조금 다르지만 의미는 비슷합니다.
Columns: 컬럼 목록
Data 또는 View Data: 실제 데이터
Constraints: 제약 조건
Properties: 테이블의 기본 정보
SQL 또는 DDL: 이 테이블을 만들 때 사용된 SQL 문장
처음에는 Columns와 Data 탭만 잘 봐도 충분합니다. Columns는 장부의 양식을 보는 곳이고, Data는 실제 장부 내용을 보는 곳입니다.
컬럼 이름과 데이터 타입 읽기
테이블 구조를 볼 때 가장 먼저 확인할 것은 컬럼 이름과 데이터 타입입니다.
컬럼 이름은 이 칸에 무엇을 적는지 알려 줍니다. customer_name이면 고객 이름, order_date면 주문일, amount면 금액을 뜻합니다.
데이터 타입은 그 칸에 어떤 종류의 값을 넣을 수 있는지 알려 줍니다. 엑셀에서 어떤 열은 날짜로 쓰고, 어떤 열은 숫자로 쓰는 것과 비슷합니다.
자주 보는 데이터 타입은 다음과 같습니다.
integer: 정수입니다. 고객 번호, 주문 번호, 수량처럼 소수점이 없는 숫자에 씁니다.numeric: 정확한 숫자입니다. 금액처럼 계산 오차가 없어야 하는 값에 자주 씁니다.text: 긴 글자입니다. 메모, 주소, 설명처럼 길이가 일정하지 않은 문장에 씁니다.varchar: 글자입니다. 이름, 전화번호, 코드처럼 비교적 짧은 문자열에 자주 씁니다.date: 날짜입니다. 주문일, 가입일처럼 연월일을 저장합니다.timestamp: 날짜와 시간을 함께 저장합니다. 등록 시각, 수정 시각처럼 몇 시 몇 분까지 필요할 때 씁니다.boolean: 참 또는 거짓입니다. 사용 여부, 동의 여부처럼 예/아니오 값에 씁니다.
예를 들어 customers 테이블의 컬럼이 이렇게 보일 수 있습니다.
| 컬럼 이름 | 데이터 타입 | 뜻 |
|---|---|---|
| customer_id | integer | 고객 번호 |
| customer_name | varchar | 고객 이름 |
| phone | varchar | 전화번호 |
| city | varchar | 지역 |
| created_at | date | 등록일 |
여기서 중요한 점이 있습니다. 전화번호는 숫자처럼 보이지만 보통 varchar 같은 글자 타입으로 저장합니다. 앞자리 0이 사라지면 안 되고, 하이픈이 들어갈 수도 있기 때문입니다. 데이터 타입은 단순히 숫자냐 글자냐의 문제가 아니라, 업무에서 그 값을 어떻게 사용할지에 따라 정합니다.
행 개수로 테이블의 크기 감 잡기
테이블을 열기 전에 행 개수를 확인하면 좋습니다. 행 개수는 그 테이블에 기록이 몇 줄 들어 있는지 알려 줍니다.
고객 테이블에 행이 30개라면 작은 명단입니다. 주문 테이블에 행이 300만 개라면 매우 큰 장부입니다. 큰 테이블을 아무 생각 없이 전부 열면 화면이 느려질 수 있습니다.
pgAdmin이나 DBeaver에서는 테이블을 우클릭한 뒤 View Data 또는 Count Rows와 비슷한 메뉴를 볼 수 있습니다. 도구에 따라 행 개수를 바로 보여 주기도 하고, 별도의 SQL을 실행해야 할 수도 있습니다.
행 개수를 확인하는 SQL은 다음처럼 읽습니다.
고객 테이블에 기록이 몇 줄 있는지 세어 봅니다.
SELECT COUNT(*)
FROM customers;
결과가 이렇게 나왔다고 해 보겠습니다.
| count |
|---|
| 5 |
이 결과는 customers 테이블에 고객 기록이 5줄 있다는 뜻입니다. COUNT(*)는 테이블 안의 행 수를 세는 표현입니다. 지금은 문법을 모두 외울 필요가 없습니다. 화면에서 행 개수를 찾기 어렵다면 이런 SQL로도 확인할 수 있다는 정도만 기억하면 됩니다.
데이터를 열 때는 일부만 미리 보기
테이블의 실제 데이터를 볼 때는 전체를 한 번에 보려고 하지 않는 것이 좋습니다. 특히 업무용 데이터베이스에서는 한 테이블에 수십만 줄, 수백만 줄이 들어 있을 수 있습니다.
화면 도구에서 View First 100 Rows, View Top 100 Rows, Fetch first rows 같은 메뉴가 보이면 그것을 선택합니다. 의미는 처음 몇 줄만 미리 보겠다는 뜻입니다.
SQL로 표현하면 다음과 같습니다.
고객 테이블에서 처음 5명의 고객만 미리 봅니다.
SELECT *
FROM customers
LIMIT 5;
예상 결과는 다음과 비슷합니다.
| customer_id | customer_name | phone | city | created_at |
|---|---|---|---|---|
| 1 | 김민지 | 010-1111-2222 | 서울 | 2026-01-05 |
| 2 | 박준호 | 010-2222-3333 | 부산 | 2026-01-08 |
| 3 | 이서연 | 010-3333-4444 | 대전 | 2026-01-11 |
| 4 | 최도윤 | 010-4444-5555 | 인천 | 2026-01-15 |
| 5 | 정하은 | 010-5555-6666 | 광주 | 2026-01-20 |
SELECT *는 모든 컬럼을 보여 달라는 뜻입니다. LIMIT 5는 결과를 5줄까지만 보여 달라는 뜻입니다. 이 문장은 데이터를 바꾸지 않습니다. 보기만 하는 조회 문장입니다.
초보자는 앞으로도 새 테이블을 만나면 먼저 일부만 미리 보는 습관을 들이는 것이 좋습니다.
기본키, 외래키, 제약 조건은 표시만 먼저 익히기
테이블 화면을 보다 보면 열쇠 모양 아이콘이나 PK, FK, NOT NULL 같은 표시를 볼 수 있습니다. 처음에는 이 단어들이 어렵게 느껴질 수 있습니다. 지금은 정확한 설계 방법보다, 화면에서 무엇을 뜻하는지 눈에 익히는 것이 중요합니다.
기본키는 한 행을 구별하는 대표 번호입니다. 고객 명단에서 주민등록번호처럼 민감한 값을 쓰자는 뜻은 아닙니다. 보통은 customer_id처럼 시스템이 붙인 고객 번호를 씁니다. 같은 고객 번호가 두 번 나오면 안 됩니다.
화면에서는 기본키가 보통 열쇠 모양으로 표시되거나 PK라고 표시됩니다.
외래키는 다른 테이블의 기본키를 가리키는 값입니다. 주문 테이블에 customer_id가 있다면, 그 주문이 어느 고객의 주문인지 알려 주기 위해 고객 테이블의 customer_id와 연결됩니다.
화면에서는 외래키가 FK라고 표시되거나, Constraints 탭 안에 관계 정보로 보일 수 있습니다.
제약 조건은 데이터가 엉뚱하게 들어오지 않도록 막는 규칙입니다.
NOT NULL: 비워 둘 수 없음UNIQUE: 같은 값을 중복해서 넣을 수 없음PRIMARY KEY: 기본키FOREIGN KEY: 외래키CHECK: 정해진 조건을 만족해야 함
예를 들어 주문 수량은 0보다 커야 합니다. 이런 규칙을 걸어 두면 실수로 수량에 -3 같은 값이 들어가는 일을 막을 수 있습니다.
지금은 제약 조건을 만들 필요가 없습니다. 대신 테이블을 볼 때 이런 표시가 어디에 있는지 확인해 보세요. 테이블을 잘 이해하는 사람은 데이터뿐 아니라 그 데이터에 걸린 규칙도 함께 봅니다.
고객 테이블과 주문 테이블 함께 훑어보기
이 책에서는 앞으로 고객 명단과 주문 내역을 자주 예로 들겠습니다. 두 테이블은 업무에서 가장 이해하기 쉬운 관계를 보여 줍니다.
먼저 고객 테이블은 고객 한 명당 한 줄입니다.
| customer_id | customer_name | city |
|---|---|---|
| 1 | 김민지 | 서울 |
| 2 | 박준호 | 부산 |
| 3 | 이서연 | 대전 |
주문 테이블은 주문 한 건당 한 줄입니다.
| order_id | customer_id | order_date | amount |
|---|---|---|---|
| 101 | 1 | 2026-02-01 | 35000 |
| 102 | 1 | 2026-02-03 | 18000 |
| 103 | 2 | 2026-02-05 | 52000 |
여기서 눈여겨볼 컬럼은 customer_id입니다. 고객 테이블에서는 고객을 구별하는 기본키입니다. 주문 테이블에서는 이 주문이 누구의 주문인지 알려 주는 외래키입니다.
즉, 주문 번호 101번과 102번은 모두 customer_id가 1입니다. 고객 테이블에서 1번 고객은 김민지입니다. 따라서 김민지 고객이 두 번 주문했다는 뜻입니다.
이처럼 PostgreSQL은 모든 정보를 한 장의 거대한 엑셀 시트에 넣지 않습니다. 고객 정보는 고객 테이블에, 주문 정보는 주문 테이블에 나누어 저장합니다. 그리고 필요한 순간에 customer_id 같은 공통 항목으로 연결합니다.
나누어 저장하면 장점이 있습니다. 김민지 고객의 전화번호가 바뀌어도 고객 테이블 한 곳만 고치면 됩니다. 주문 테이블의 모든 주문 기록에 고객 이름과 전화번호를 반복해서 적을 필요가 없습니다.
새 테이블을 만났을 때의 확인 순서
앞으로 낯선 데이터베이스를 열게 되면 다음 순서로 확인해 보세요.
내가 어느 데이터베이스에 접속했는지 확인합니다.
Schemas > public > Tables에서 테이블 목록을 봅니다.테이블 이름으로 무엇을 담는 장부인지 짐작합니다.
Columns에서 컬럼 이름과 데이터 타입을 봅니다.기본키와 외래키 표시가 있는지 확인합니다.
행 개수를 확인합니다.
실제 데이터는 처음 몇 줄만 미리 봅니다.
이 순서를 지키면 처음 보는 화면에서도 당황할 일이 줄어듭니다. 데이터베이스를 잘 다루는 첫걸음은 어려운 SQL을 외우는 것이 아닙니다. 지금 내가 어떤 장부를 보고 있는지, 그 장부가 어떤 항목으로 구성되어 있는지, 다른 장부와 어떻게 이어지는지 파악하는 것입니다.
이번 장에서 기억할 핵심은 간단합니다. PostgreSQL 화면은 폴더처럼 내려가며 읽습니다. 데이터베이스 안에 스키마가 있고, 스키마 안에 테이블이 있고, 테이블 안에 컬럼과 행이 있습니다. 그리고 기본키와 외래키는 테이블 사이의 길을 알려 주는 표지판입니다.
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.