


이미지와 프레임으로 원하는 움직임 만들기

텍스트만으로 부족할 때 이미지가 필요하다
Text to Video는 빠르게 장면을 시험하기 좋다. 하지만 "이 인물처럼 생겨야 한다", "이 제품 모양은 유지해야 한다", "처음에는 이렇게 서 있고 마지막에는 저렇게 앉아 있어야 한다"처럼 시각적으로 정확한 조건이 생기면 텍스트만으로는 부족해진다.
이때 이미지는 Flow에게 가장 강한 설명서가 된다. 긴 문장으로 얼굴형, 의상, 제품 각도, 배경 색감을 계속 설명하는 대신 이미지를 보여 주면 된다. Flow에는 이런 목적에 맞게 Frames to Video와 Ingredients to Video 같은 입력 방식이 제공된다. Google Flow는 텍스트, 이미지, 영상 입력을 함께 활용해 영상을 만드는 제작 환경으로 안내되며, 입력 방식에는 Text to Video, Frames to Video, Ingredients to Video가 포함된다1.
두 기능의 차이는 간단하다.
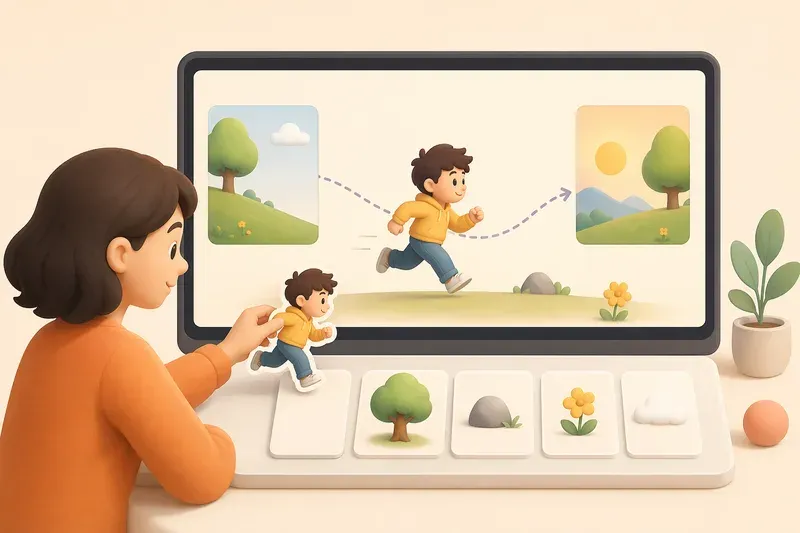
Frames to Video: 시작 프레임과 종료 프레임을 넣어, 그 사이의 움직임이나 전환을 만든다.
Ingredients to Video: 캐릭터, 소품, 배경, 스타일 같은 시각 요소를 참조로 넣고 영상 속에서 계속 유지하게 한다.
즉, 프레임은 "어디서 시작해 어디로 도착할지"를 정하고, Ingredients는 "무엇이 계속 등장해야 하는지"를 정한다. 둘 다 이미지를 활용하지만 목적이 다르다. 움직임의 출발점과 도착점을 잡고 싶다면 Frames를, 캐릭터나 제품의 일관성을 유지하고 싶다면 Ingredients를 먼저 생각하면 된다.
 AI 생성 이미지
Frames to Video: 시작점과 도착점 정하기
Frames to Video는 영상의 처음과 끝을 더 정확히 통제하고 싶을 때 쓴다. 예를 들어 시작 프레임에는 카페 창가에 앉은 인물이 있고, 종료 프레임에는 그 인물이 문 앞에 서 있는 모습이 있다고 하자. Flow는 두 이미지를 보고 "이 장면이 저 장면으로 이어져야 한다"고 이해한다. 사용자는 그 사이에서 어떤 행동과 카메라 움직임이 일어나야 하는지만 설명하면 된다.
기본 작업 순서는 다음과 같다.
Flow에서 기존 프로젝트를 열거나 새 프로젝트를 만든다.
프롬프트 입력 영역에서 영상 생성 방식 또는 모델 선택 메뉴를 확인한다.
Video > Frames 또는 Frames to Video에 해당하는 방식을 선택한다.
시작 이미지와 종료 이미지를 각각 추가한다.
텍스트 프롬프트에는 두 프레임 사이에서 일어날 행동과 전환을 적는다.
화면비, 길이, 출력 수, 크레딧 차감을 확인한 뒤 Generate를 실행한다.
Google Flow 도움말도 시작 프레임과 종료 프레임을 추가한 뒤, 두 프레임 사이에서 일어날 행동이나 전환을 텍스트로 설명하라고 안내한다2. 다만 실제 화면의 메뉴 이름, 지원 모델, 지원되는 이미지 유형은 지역, 구독 단계, 업데이트 시점에 따라 달라질 수 있다. 그래서 이 책에서는 버튼 이름을 외우기보다 "프레임을 넣고, 그 사이의 움직임을 말한다"는 원리를 중심으로 이해하는 편이 좋다.
여기서 중요한 점은 텍스트 프롬프트가 이미지를 다시 설명하는 문장이 아니라는 것이다. 이미지는 이미 "생김새"를 말하고 있다. 텍스트는 "어떻게 움직일지"를 말해야 한다.
예시는 다음처럼 쓸 수 있다.
시작 프레임의 인물이 천천히 자리에서 일어나 창밖을 한 번 바라본 뒤, 종료 프레임처럼 카페 문 앞에 서는 장면. 카메라는 인물을 부드럽게 따라가며, 따뜻한 오후 햇빛과 조용한 분위기를 유지한다.
영어식 표현으로 정리하면 다음과 같다.
The character from the start frame slowly stands up, glances out the window, and walks toward the door, ending in the pose shown in the end frame. Use a gentle tracking shot, warm afternoon light, and a quiet cinematic mood.
좋은 결과를 얻으려면 시작 프레임과 종료 프레임이 서로 너무 멀리 떨어져 있지 않아야 한다. 앉아 있는 인물이 갑자기 하늘을 날아 도시 위에 떠 있는 종료 프레임으로 바뀌면, 모델은 그 사이를 자연스럽게 연결하기 어렵다. 한 클립에는 하나의 큰 변화만 넣는 것이 안전하다.
이전 클립의 한 프레임을 다음 장면의 시작점으로 쓰기
여러 클립을 이어 붙일 때 가장 자주 생기는 문제는 장면 전환이 튄다는 것이다. 첫 번째 클립에서는 인물이 컵을 들고 있었는데, 다음 클립에서는 컵이 사라지거나 옷의 색이 조금 달라지는 식이다.
이 문제를 줄이는 쉬운 방법은 이전 클립에서 마음에 드는 한 프레임을 저장해 다음 클립의 시작 프레임으로 사용하는 것이다. 꼭 마지막 프레임일 필요는 없다. 인물의 얼굴, 손, 소품, 배경이 가장 안정적으로 보이는 순간을 고르면 된다. Flow 도움말에서도 영상의 한 프레임을 저장해 이후 생성의 Ingredient, 시작 프레임, 종료 프레임으로 사용할 수 있다고 안내한다2.
작업 흐름은 다음과 같다.
첫 번째 클립을 생성한다.
결과를 보며 다음 장면으로 이어가기 좋은 순간을 찾는다.
그 프레임을 이미지 자산으로 저장하거나 캡처한다.
다음 생성에서 그 이미지를 시작 프레임으로 넣는다.
프롬프트 첫 문장에 "이 시작 프레임에서 이어지는 장면"이라고 명시한다.
예시는 다음과 같다.
시작 프레임에서 바로 이어지는 장면. 같은 인물, 같은 의상, 같은 카페 조명을 유지한다. 인물은 들고 있던 컵을 테이블에 내려놓고 천천히 카메라 쪽으로 고개를 든다. 카메라는 고정된 미디엄 샷을 유지한다.
여기서 핵심은 "새 장면"이 아니라 "이어지는 장면"이라고 적는 것이다. Flow에게 이전 장면과의 연결성을 강조하면 캐릭터와 소품의 드리프트를 줄이는 데 도움이 된다. 단, 이전 프레임의 화면이 흔들렸거나 손 모양이 이상하면 그 오류도 이어질 수 있다. 다음 장면의 기준으로 쓸 프레임은 예쁜 프레임보다 안정적인 프레임이어야 한다.
Ingredients to Video: 캐릭터, 소품, 배경의 역할 정하기
Frames to Video가 시작과 끝의 구도를 통제하는 방식이라면, Ingredients to Video는 영상 안에 들어갈 시각 재료를 정하는 방식이다. 캐릭터 기준 이미지, 제품 사진, 배경 콘셉트 이미지, 스타일 참고 이미지를 함께 넣고 "각 이미지가 영상에서 어떤 역할을 하는지" 설명한다.
Flow 도움말에 따르면 Ingredients는 기기에서 끌어다 놓거나, 프로젝트에 업로드된 자산을 선택하거나, 프롬프트에서 @로 자산 이름을 검색해 추가할 수 있다2. Google의 실전 팁에서는 Ingredients를 캐릭터, 오브젝트, 스타일처럼 일관되게 유지할 시각 요소로 설명하며, 프롬프트에서 각 요소가 장면 안에서 어떻게 쓰이는지 분명히 적으라고 안내한다3.
프롬프트 구조는 다음처럼 잡으면 쉽다.
@캐릭터이미지는 주인공의 얼굴, 헤어스타일, 의상 기준으로 사용한다.
@제품이미지는 주인공이 손에 들고 있는 소품으로 사용하며, 형태와 색상을 유지한다.
@배경이미지는 정확한 구도보다 전체 분위기와 색감 참고로 사용한다.
주인공은 밤거리에서 제품을 들어 올려 확인하고, 네온사인이 반사되는 젖은 보도 위를 천천히 걷는다.
영어식으로 쓰면 다음과 같다.
Use @character as the main character reference, keeping the same face, hairstyle, and outfit. Use @product as the handheld prop, preserving its shape and color. Use @street_background as a mood and lighting reference, not an exact composition. The character slowly walks along a wet neon street while checking the product in their hand.
Ingredients를 많이 넣는다고 항상 좋아지는 것은 아니다. 참조가 많을수록 모델이 무엇을 우선해야 할지 헷갈릴 수 있다. 특히 캐릭터 이미지와 텍스트 설명이 서로 다르면 결과가 흔들린다. 예를 들어 이미지는 검은 코트를 입고 있는데 프롬프트에는 흰색 재킷이라고 쓰면, 모델은 둘 중 하나를 선택하거나 어색하게 섞을 수 있다.
또한 제품 화면에서 한 번에 넣을 수 있는 Ingredients 수, 지원 모델, 지원 파일 형식은 달라질 수 있다. 예전 안내나 블로그 글의 숫자를 외우기보다, 생성 직전 Flow 화면에서 현재 제한을 확인하는 습관이 더 안전하다.
화면비가 다르면 왜 잘리거나 여백이 생길까
참조 이미지는 좋은데 결과 영상에서 머리가 잘리거나 제품이 화면 밖으로 밀려나는 경우가 있다. 가장 흔한 원인은 화면비 불일치다.
예를 들어 16:9 가로 이미지를 참조로 넣고 9:16 세로 영상을 만들면 Flow는 둘 중 하나를 해야 한다. 이미지를 세로 화면에 맞게 잘라 내거나, 빈 공간을 새로 상상해서 채워야 한다. 이 과정에서 인물의 팔, 제품의 옆면, 배경의 중요한 요소가 사라질 수 있다.
반대로 세로 인물 사진을 16:9 영상에 넣으면 좌우 배경이 새로 만들어질 수 있다. 이 자체가 나쁜 것은 아니지만, 브랜드 제품이나 세트 디자인처럼 정확해야 하는 장면에서는 문제가 된다.
안전한 방법은 다음과 같다.
최종 영상이 9:16이면 참조 이미지도 가능하면 9:16으로 준비한다.
16:9 영상용 장면은 처음부터 가로 구도로 기준 이미지를 만든다.
인물의 머리, 손, 제품 주변에 충분한 여백을 둔다.
제품은 화면 중앙에 두고, 너무 가장자리에 배치하지 않는다.
화면비가 다를 때는 "이 이미지는 구도 참고가 아니라 캐릭터 참고"라고 역할을 제한한다.
프롬프트에도 다음처럼 적을 수 있다.
참조 이미지는 캐릭터 외형 참고로만 사용한다. 최종 영상은 9:16 세로 화면에 맞게 재구성하되, 인물의 머리와 손, 들고 있는 제품이 잘리지 않게 유지한다.
이 문장은 모델에게 두 가지를 동시에 알려 준다. 첫째, 참조 이미지의 모든 구도를 그대로 따를 필요는 없다. 둘째, 잘리면 안 되는 핵심 요소가 있다.
텍스트 지시와 이미지 참조가 싸우지 않게 하기
이미지를 넣었다고 텍스트를 대충 써도 되는 것은 아니다. 이미지는 생김새를 알려 주고, 텍스트는 행동과 우선순위를 알려 준다. 둘이 같은 방향을 가리켜야 한다.
생성 전에 다음 체크리스트를 확인하자.
캐릭터: 이미지 속 인물과 텍스트 설명의 나이, 의상, 헤어스타일이 맞는가?
소품: 제품이나 물건의 색상, 형태, 위치를 서로 다르게 지시하지 않았는가?
프레임: 시작 프레임에서 종료 프레임까지 한 클립 안에서 도달 가능한 변화인가?
역할: 각 Ingredient가 캐릭터용인지, 소품용인지, 배경용인지, 스타일용인지 분명한가?
카메라: 한 장면에 tracking shot, zoom in, aerial view처럼 여러 카메라 의도를 동시에 넣지 않았는가?
화면비: 참조 이미지와 최종 영상 비율이 다를 때 잘릴 위험이 있는 요소를 적었는가?
유지와 변경: 무엇을 유지하고 무엇을 바꿀지 문장으로 나누어 썼는가?
가장 안정적인 프롬프트는 길기만 한 프롬프트가 아니다. 이미지가 이미 말하고 있는 내용은 반복하지 않고, 이미지가 말하지 못하는 행동, 감정, 카메라, 유지 조건을 보완하는 프롬프트다.
실패했을 때 먼저 볼 것
결과가 마음에 들지 않으면 무작정 다시 생성하지 말고 원인을 좁혀야 한다.
캐릭터 얼굴이 달라졌다면 참조 이미지가 너무 작거나 흐릴 수 있다. 얼굴이 선명하고 배경이 단순한 기준 이미지를 다시 준비한다. 제품이 사라졌다면 "손에 들고 있는 소품으로 영상 전체에 유지"처럼 역할과 지속 조건을 분명히 쓴다. 움직임이 이상하다면 시작 프레임과 종료 프레임의 차이가 너무 큰 것이다. 중간 장면을 하나 더 만들고 두 번에 나누어 생성한다.
화면이 잘렸다면 화면비와 여백 문제를 확인한다. 특히 세로 숏폼 영상은 인물의 머리와 손이 쉽게 잘린다. 이때는 기준 이미지를 세로 비율로 다시 만들거나, 프롬프트에 "full body visible", "keep the product fully in frame", "do not crop the head or hands"처럼 잘림 방지 문장을 넣는다.
프롬프트와 이미지가 서로 충돌하는지도 확인해야 한다. Flow 도움말의 권장 사항처럼 텍스트 프롬프트는 시각 입력을 보완해야지, 반대로 지시해서는 안 된다2. 결과가 흔들릴 때는 프롬프트를 더 길게 쓰기보다 "유지할 것"과 "변경할 것"을 나누어 다시 적는 편이 낫다.
Frames to Video와 Ingredients to Video의 목적은 완벽한 한 번의 생성을 보장하는 것이 아니다. 텍스트만으로 불안정했던 부분을 이미지로 고정하고, 움직임과 전환을 더 예측 가능하게 만드는 것이다. 텍스트는 행동을 지시하고, 이미지는 형태를 지시한다. 이 둘을 나누어 생각하면 원하는 장면에 훨씬 가까워진다.
참고
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.