


파라미터는 AI 모델이 학습 과정에서 조정한 내부 숫자 값입니다. 쉽게 말해, AI가 답을 만들 때 참고하는 수많은 '조절 손잡이'입니다.
한 줄로 요약하면 이렇습니다. 파라미터 수는 AI 모델의 크기를 보여주는 중요한 숫자지만, 그 자체가 곧 똑똑함의 점수는 아닙니다.
뉴스에서 "1750억 파라미터 모델", "70B 오픈소스 모델", "소형 7B 모델" 같은 표현을 자주 봅니다. 여기서 B는 billion, 즉 10억을 뜻합니다. 70B는 700억 개, 7B는 70억 개 파라미터라는 말입니다. 숫자가 크면 모델 규모가 크다는 뜻은 맞습니다. 하지만 "파라미터가 많다 = 무조건 더 좋다"로 읽으면 AI 뉴스를 절반만 이해한 것입니다.
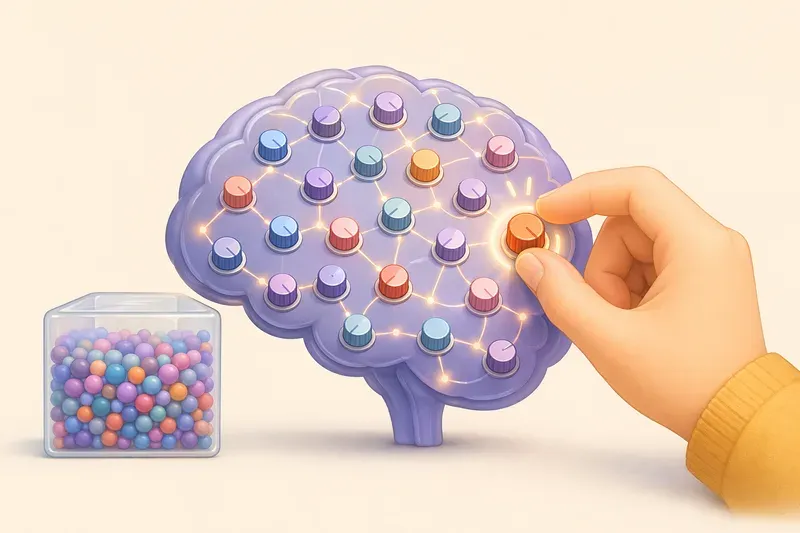 AI 생성 이미지
파라미터는 AI 안의 '조절 손잡이'다
딥러닝 모델은 입력을 받아 여러 층을 거치며 계산합니다. 문장을 읽는 LLM이라면 사용자의 질문이 토큰으로 나뉘고, 그 토큰들이 숫자로 바뀐 뒤 여러 계산 단계를 통과합니다. 이때 모델 안에는 수많은 숫자 값이 있습니다. 이 숫자들이 바로 파라미터입니다.
일상 비유로 보면 오디오 믹서의 손잡이와 비슷합니다. 보컬을 조금 키우고, 베이스를 낮추고, 고음을 조정하면 같은 노래도 다르게 들립니다. AI 모델도 마찬가지입니다. 내부의 수많은 숫자 값이 조금씩 달라지면 같은 입력을 받아도 다른 결과를 냅니다.
다만 사람이 파라미터를 하나씩 직접 돌리는 것은 아닙니다. AI는 학습 데이터로 문제를 풀어 보고, 예측이 틀리면 내부 숫자를 조금씩 바꿉니다. LLM의 경우에는 다음에 올 토큰을 예측해 보고, 실제 데이터와의 차이를 줄이는 방향으로 파라미터를 조정합니다. 이 과정을 엄청나게 많이 반복하면서 모델은 더 자연스러운 답을 만들 수 있게 됩니다.
즉 파라미터는 "AI가 외운 문장 목록"이 아닙니다. "서울의 수도는?" 같은 질문과 답을 그대로 서랍에 넣어 둔 것이 아니라, 수많은 데이터에서 패턴을 배우며 조정된 숫자들의 묶음에 가깝습니다.
1750억 파라미터는 왜 유명해졌을까
"1750억 파라미터"라는 표현은 GPT-3가 알려지면서 널리 퍼졌습니다. OpenAI가 공개한 GPT-3 논문은 GPT-3를 1750억 개 파라미터를 가진 자기회귀 언어모델로 설명했습니다.1 당시에는 이 숫자가 매우 컸기 때문에 AI 뉴스에서 모델 규모를 상징하는 표현처럼 쓰였습니다.
여기서 중요한 점은 1750억 개가 "지식 1750억 개"라는 뜻이 아니라는 것입니다. 파라미터는 지식 조각의 개수가 아닙니다. 하나의 파라미터가 "사과", 다른 파라미터가 "경제", 또 다른 파라미터가 "코딩"을 담당하는 식으로 깔끔하게 나뉘지도 않습니다.
더 정확히는, 파라미터는 모델이 언어의 패턴을 계산하기 위해 쓰는 내부 숫자입니다. 이 숫자들이 함께 작동하면서 "이 문맥 다음에는 어떤 말이 자연스러운가", "이 질문에는 어떤 형식의 답이 어울리는가" 같은 판단에 영향을 줍니다.
그래서 "1750억 파라미터"라는 말은 이렇게 읽으면 됩니다.
이 모델은 내부에 조정된 숫자 값이 1750억 개 있다.
그만큼 저장 공간과 계산량이 많이 필요하다.
복잡한 언어 패턴을 표현할 여지가 크다.
하지만 이 숫자만으로 답변 품질을 단정할 수는 없다.
파라미터가 많으면 무엇이 좋아질까
파라미터 수가 많아지면 모델의 표현력이 커질 수 있습니다. 표현력이란 복잡한 패턴을 담아낼 수 있는 능력입니다.
작은 노트에는 간단한 메모만 적을 수 있지만, 큰 노트에는 더 많은 주제와 관계를 정리할 수 있습니다. 비슷하게 파라미터가 많은 모델은 언어, 코드, 추론, 번역, 요약처럼 다양한 패턴을 담을 공간이 커집니다.
이 때문에 대규모 언어모델 경쟁에서 파라미터 수는 오랫동안 중요한 홍보 포인트였습니다. "우리 모델은 몇십억 파라미터입니다", "이전 모델보다 몇 배 커졌습니다" 같은 발표가 이어진 이유도 여기에 있습니다.
하지만 큰 노트가 있다고 해서 반드시 좋은 글이 적히는 것은 아닙니다. 빈칸이 많아도 내용이 부실하면 쓸모가 없습니다. AI도 마찬가지입니다. 파라미터 수가 많아도 학습 데이터가 나쁘거나, 학습 방식이 부실하거나, 실제 서비스에 맞게 최적화되지 않으면 좋은 답을 내기 어렵습니다.
왜 '크면 무조건 좋다'가 아닐까
파라미터 수는 자동차의 배기량이나 카메라의 화소 수처럼 보이기 쉽습니다. 숫자가 커 보이면 더 좋아 보입니다. 하지만 실제 제품은 한 가지 숫자로 판단하기 어렵습니다.
AI 모델도 마찬가지입니다. 파라미터가 많으면 장점이 있지만 비용도 함께 커집니다.
첫째, 학습 비용이 커집니다. 많은 파라미터를 조정하려면 많은 데이터와 계산 자원이 필요합니다. 대규모 GPU, 긴 학습 시간, 높은 전력 비용이 따라옵니다.
둘째, 추론 비용도 커질 수 있습니다. 추론은 학습이 끝난 모델이 실제 질문에 답하는 과정입니다. 모델이 클수록 답변 한 번을 만드는 데 더 많은 계산이 필요할 수 있습니다. 그래서 큰 모델은 느리거나 비쌀 수 있습니다.
셋째, 데이터가 충분하지 않으면 큰 모델도 제대로 배우지 못합니다. 큰 그릇을 준비했지만 재료가 부족한 상황과 비슷합니다. 연구자들은 모델 크기와 학습 데이터 양 사이의 균형이 중요하다고 설명해 왔습니다. 특히 DeepMind 연구진의 Chinchilla 스케일링 논의는 같은 계산 예산 안에서는 모델만 키우기보다 파라미터 수와 학습 토큰 수를 함께 맞추는 것이 중요하다는 관점을 널리 알렸습니다.2
즉 좋은 AI 모델은 "큰 모델"이 아니라 "크기, 데이터, 학습 방식, 사용 목적이 잘 맞는 모델"에 가깝습니다.
AI 발표에서 파라미터 수를 읽는 법
AI 모델 발표를 볼 때는 파라미터 수를 첫 번째 단서로 삼되, 마지막 결론으로 삼지는 않는 것이 좋습니다.
예를 들어 이런 문장을 봤다고 해봅시다.
"A사는 70B 파라미터 규모의 오픈소스 언어모델을 공개했다."
이 문장에서 알 수 있는 것은 "상당히 큰 언어모델이 공개됐다"는 정도입니다. 그다음에는 이런 질문을 해야 합니다.
어떤 데이터로 학습했나?
한국어 성능은 어떤가?
코딩, 수학, 요약, 번역 중 어디에 강한가?
실제 사용 비용은 어느 정도인가?
모델 가중치가 공개됐나, 아니면 API만 제공되나?
벤치마크 성능이 실제 업무에서도 이어지나?
또 다른 문장을 보겠습니다.
"B사는 7B 소형 모델이 70B 모델에 가까운 성능을 낸다고 밝혔다."
이 문장은 "작은 모델이 큰 모델을 이겼다"로 단순히 읽으면 안 됩니다. 어떤 과제에서 가까운 성능인지, 어떤 언어에서 테스트했는지, 어떤 방식으로 압축하거나 최적화했는지 확인해야 합니다. 작은 모델은 모바일 기기, 사내 서버, 빠른 응답이 중요한 서비스에서 오히려 더 실용적일 수 있습니다.
파라미터 수보다 함께 봐야 할 것들
파라미터를 제대로 이해하려면 세 가지를 같이 봐야 합니다.
첫째는 데이터 품질입니다. 모델은 데이터에서 패턴을 배웁니다. 데이터가 편향되어 있거나 오래됐거나 오류가 많으면, 파라미터가 아무리 많아도 답변 품질이 흔들립니다. 좋은 재료 없이 좋은 요리가 나오기 어려운 것과 같습니다.
둘째는 학습 방식입니다. 같은 데이터와 비슷한 크기의 모델이라도 어떻게 학습시키는지에 따라 성능이 달라집니다. 기본 학습 이후 사람의 피드백을 반영하거나, 특정 업무에 맞게 파인튜닝하거나, 안전성 기준을 적용하는 과정이 결과에 영향을 줍니다.
셋째는 추론 최적화입니다. 실제 서비스에서는 모델이 얼마나 빠르게, 안정적으로, 적절한 비용으로 답하느냐가 중요합니다. 기업이 "작지만 빠른 모델", "온디바이스 AI", "비용 효율적인 모델"을 강조하는 이유도 여기에 있습니다. 모델 크기만 키우는 경쟁에서, 이제는 효율과 목적 적합성도 중요한 경쟁력이 되었습니다.
파라미터를 한 문장으로 기억하기
파라미터는 AI 모델이 학습을 통해 조정한 내부 숫자 값입니다. 파라미터 수가 많으면 모델의 표현력이 커질 수 있지만, 그것만으로 모델이 더 똑똑하다고 말할 수는 없습니다.
AI 뉴스에서 "몇 억 파라미터", "몇십억 파라미터"라는 숫자를 보면 이렇게 읽으면 됩니다.
"이 모델은 이 정도 크기의 내부 계산 구조를 갖고 있구나. 이제 데이터, 학습 방식, 실제 성능, 비용을 함께 봐야겠구나."
이렇게 읽으면 숫자에 압도되지 않고, 모델 발표의 핵심을 더 정확히 볼 수 있습니다.
같이 보면 좋은 단어
[딥러닝] — 파라미터가 조정되는 모델 구조를 이해하는 출발점입니다.
[LLM] — 파라미터 수가 자주 언급되는 대표적인 AI 모델입니다.
[오픈소스 모델] — 7B, 13B, 70B 같은 숫자가 실제로 자주 등장하는 영역입니다.
참고
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.