


딥러닝은 인공신경망을 여러 층으로 쌓아 데이터 속 복잡한 패턴을 배우는 머신러닝 방법입니다. 한 줄로 말하면, 딥러닝의 '깊다'는 말은 AI가 사람처럼 깊이 생각한다는 뜻이 아니라 데이터를 여러 단계로 바꿔 가며 모델이 다루기 좋은 형태로 만든다는 뜻입니다.
챗GPT, 이미지 생성 AI, 음성 인식, 얼굴 인식 기사에서 딥러닝이라는 말이 자주 나오는 이유가 여기에 있습니다. 글, 사진, 소리처럼 복잡한 데이터는 사람이 규칙을 하나하나 적기 어렵습니다. 딥러닝은 그 복잡한 신호를 여러 층에서 조금씩 가공해 더 쓸 만한 패턴으로 바꿉니다.
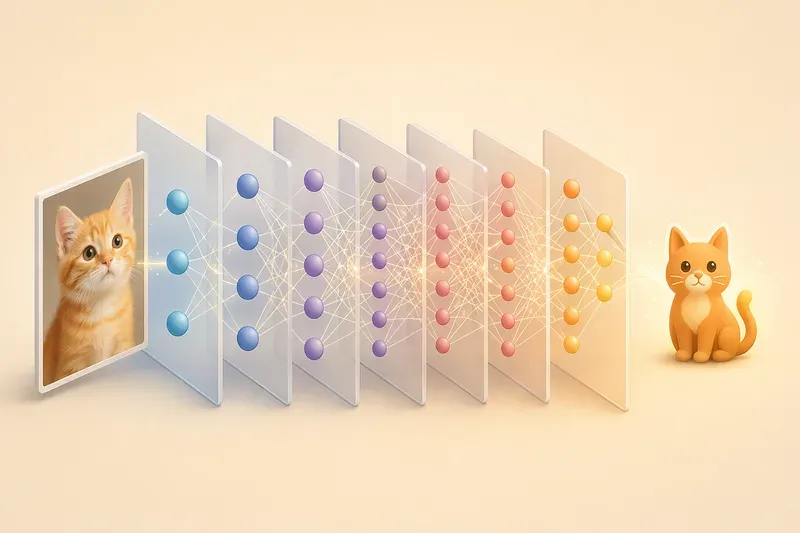 AI 생성 이미지
딥러닝은 머신러닝의 한 종류다
먼저 위치를 잡아야 합니다.
AI: 컴퓨터가 사람처럼 보이는 판단·예측·생성을 하게 만드는 큰 분야
머신러닝: 데이터를 보고 패턴을 배워 예측하는 AI 방법
딥러닝: 머신러닝 중에서도 여러 층의 인공신경망을 쓰는 방법
즉 딥러닝은 AI와 같은 말이 아닙니다. AI라는 큰 집 안에 머신러닝이라는 방이 있고, 그 안에 딥러닝이라는 더 구체적인 도구가 있다고 보면 됩니다.
전통적인 머신러닝에서는 사람이 중요한 특징을 어느 정도 골라 줘야 하는 경우가 많았습니다. 예를 들어 집값을 예측한다면 면적, 위치, 연식, 역과의 거리 같은 항목을 사람이 정리합니다. 모델은 그 항목과 가격 사이의 관계를 배웁니다.
딥러닝은 이 과정 일부를 더 자동화합니다. 특히 이미지, 음성, 자연어처럼 사람이 특징을 깔끔하게 정리하기 어려운 데이터에서 강합니다. 사진 한 장을 보고 "이건 고양이다"라고 판단하려면 수염, 귀, 눈, 털, 자세 같은 특징을 봐야 합니다. 그런데 이 특징을 모두 규칙으로 쓰기는 어렵습니다. 딥러닝은 많은 예시를 보며 어떤 신호가 중요한지 내부에서 조금씩 배웁니다.
'층을 쌓는다'는 말의 뜻
딥러닝의 기본 구조는 인공신경망입니다. 인공신경망은 사람의 뇌를 그대로 복사한 것이 아니라, 신호가 여러 노드를 거쳐 변환되는 계산 구조입니다. 보통 입력층, 은닉층, 출력층으로 나눠 설명합니다.1
입력층: 데이터가 들어오는 곳입니다. 사진의 픽셀, 문장의 토큰, 음성의 신호가 여기에 들어옵니다.
은닉층: 입력을 여러 방식으로 계산하고 바꾸는 중간 단계입니다.
출력층: 최종 결과를 내는 곳입니다. "고양이일 확률 92%", "다음 단어는 '입니다'일 가능성이 높음" 같은 답이 나옵니다.
여기서 딥러닝의 핵심은 은닉층이 여러 개라는 점입니다. 한 층만 거치는 것이 아니라, 첫 번째 층의 결과가 두 번째 층으로 가고, 두 번째 층의 결과가 세 번째 층으로 갑니다. 각 층은 앞 층의 결과를 다시 계산해 다음 층으로 넘깁니다.
일상 비유로는 공장 조립 라인을 떠올리면 쉽습니다. 원재료가 들어오면 첫 공정에서 자르고, 다음 공정에서 다듬고, 다음 공정에서 조립하고, 마지막에 완제품이 나옵니다. 딥러닝도 원본 데이터를 바로 답으로 바꾸지 않습니다. 여러 공정을 지나며 점점 더 의미 있는 형태로 바꿉니다.
그래서 '딥'은 감정이 깊다거나 철학적으로 생각한다는 뜻이 아닙니다. 중간 계산 단계가 많다는 뜻입니다.
사진을 보면 왜 '깊다'는 말이 필요한지 보인다
딥러닝을 이해할 때 가장 쉬운 예는 이미지 인식입니다. 고양이 사진을 모델이 본다고 해봅시다.
처음 들어오는 것은 고양이라는 의미가 아닙니다. 컴퓨터 입장에서는 수많은 픽셀 숫자입니다. 어느 위치가 밝은지, 어떤 색인지, 값이 어떻게 변하는지가 전부입니다.
딥러닝 모델의 앞쪽 층은 아주 단순한 패턴을 볼 수 있습니다.
밝고 어두운 경계
선의 방향
색의 변화
작은 모서리
그다음 층은 이런 단순한 패턴을 조합합니다.
둥근 곡선
삼각형에 가까운 귀 모양
털처럼 반복되는 질감
눈 주변의 형태
더 깊은 층에서는 더 큰 단위의 패턴을 봅니다.
고양이 얼굴
몸통의 윤곽
앉아 있는 자세
배경과 물체의 구분
마지막에는 "이 이미지는 고양이에 가깝다"는 판단이 나옵니다. 실제 딥러닝 모델의 내부가 사람이 보는 방식과 완전히 같다는 뜻은 아닙니다. 하지만 낮은 층이 단순한 특징을, 뒤쪽 층이 더 복잡한 특징을 다루는 방식은 딥러닝을 설명할 때 자주 쓰이는 핵심 개념입니다.2
이 구조 덕분에 딥러닝은 사람이 직접 "고양이를 구별하는 규칙 1,000개"를 쓰지 않아도 됩니다. 많은 고양이 사진과 고양이가 아닌 사진을 보며, 어떤 패턴 조합이 고양이 판단에 도움이 되는지 학습합니다.
챗GPT도 딥러닝과 연결된다
딥러닝은 이미지에만 쓰이지 않습니다. 챗GPT 같은 대규모 언어모델도 딥러닝 기반입니다. 다만 사진 대신 문장을 다룹니다.
언어모델은 문장을 글자 그대로만 보는 것이 아니라, 단어와 단어 사이의 관계를 숫자로 바꿔 계산합니다. "오늘 날씨가" 다음에 어떤 말이 자연스러운지, "계약서를 요약해 줘"라는 요청에서 사용자가 원하는 작업이 무엇인지, 긴 문단 안에서 앞뒤 문장이 어떻게 이어지는지 학습합니다.
여기서도 여러 층이 중요합니다. 문장이 층을 거칠수록 모델 내부의 숫자 표현이 계속 바뀌고, 그 과정에서 가까운 단어 관계뿐 아니라 더 넓은 문맥과 의미 관계까지 반영됩니다. 다만 모델의 어느 층이 어떤 역할만 맡는다고 딱 잘라 말하기는 어렵습니다. 모델이 사람처럼 의미를 '느낀다'고 말하기도 어렵습니다. 더 정확히는, 엄청난 양의 텍스트에서 통계적·구조적 패턴을 배워 다음에 올 말이나 적절한 답변을 계산합니다.
뉴스에서 "새 AI 모델이 더 깊고 큰 신경망을 사용했다"거나 "파라미터 수가 늘었다"는 표현이 나오면, 대개 이런 계산 구조가 더 커졌다는 뜻입니다. 층이 많고, 연결이 많고, 조정해야 할 숫자가 많아진 것입니다.
딥러닝이 갑자기 강해진 이유
딥러닝 아이디어가 어느 날 갑자기 생긴 것은 아닙니다. 신경망 연구는 오래전부터 있었습니다. 그런데 최근 10여 년 사이 딥러닝이 크게 주목받은 이유는 크게 세 가지입니다.
첫째, 데이터가 많아졌습니다. 인터넷, 스마트폰, 센서, 디지털 서비스가 늘면서 이미지, 문장, 음성, 클릭 기록 같은 데이터가 폭발적으로 쌓였습니다. 딥러닝은 예시가 많을수록 복잡한 패턴을 배울 기회가 늘어납니다.
둘째, GPU가 발전했습니다. 딥러닝은 비슷한 계산을 엄청나게 많이 반복합니다. 특히 행렬 곱셈처럼 숫자 묶음을 한꺼번에 계산하는 작업이 많습니다. GPU는 이런 병렬 계산에 강한 장치라 딥러닝 학습 속도를 크게 높였습니다.3
CPU가 일을 똑똑한 직원 몇 명이 순서대로 처리하는 방식에 가깝다면, GPU는 단순 계산을 하는 직원 수천 명이 동시에 움직이는 방식에 가깝습니다. 딥러닝 학습에는 후자가 잘 맞습니다. 수많은 픽셀, 토큰, 파라미터를 동시에 계산해야 하기 때문입니다.
셋째, 알고리즘과 학습 기법이 개선되었습니다. 층을 깊게 쌓으면 표현력은 좋아질 수 있지만, 학습이 불안정해지거나 계산이 어려워지는 문제가 있었습니다. 이를 다루는 여러 기법이 발전하면서 더 큰 모델을 더 잘 학습시킬 수 있게 됐습니다.
그래서 딥러닝의 성장은 한 가지 이유로 설명하기 어렵습니다. 데이터, GPU, 알고리즘이 함께 맞물리며 가능해진 변화입니다.
딥러닝은 만능이 아니다
딥러닝이 강력하다고 해서 모든 문제에 딥러닝이 정답은 아닙니다.
데이터가 적으면 잘 배우기 어렵습니다. 학습에 비용이 많이 들 수도 있습니다. 모델이 왜 그런 판단을 했는지 설명하기 어려운 경우도 있습니다. 또 학습 데이터에 편향이 있으면 결과에도 편향이 반영될 수 있습니다.
예를 들어 작은 회사의 단순 재고 예측 문제라면 복잡한 딥러닝보다 전통적인 머신러닝이나 엑셀 기반 분석이 더 낫기도 합니다. 반대로 수많은 이미지에서 불량품을 찾거나, 긴 문서를 요약하거나, 음성을 문자로 바꾸는 일처럼 데이터가 복잡하고 패턴이 다양한 문제에서는 딥러닝이 강점을 보입니다.
중요한 질문은 "딥러닝을 쓰는가?"가 아니라 "이 문제에 딥러닝이 필요한가?"입니다.
뉴스에서 이렇게 읽으면 된다
앞으로 기사에서 딥러닝이라는 단어를 보면 이렇게 해석하면 됩니다.
"이 AI는 사람이 규칙을 하나하나 적은 것이 아니라, 여러 층의 신경망이 많은 데이터에서 패턴을 배워 작동하는구나."
그리고 한 걸음 더 들어가면 세 가지를 확인하면 좋습니다.
어떤 데이터를 배웠는가?
이미지인지, 텍스트인지, 음성인지, 의료 기록인지에 따라 모델의 성격이 달라집니다.얼마나 큰 계산 자원이 필요한가?
큰 딥러닝 모델일수록 학습과 운영에 많은 GPU, 전력, 데이터센터가 필요할 수 있습니다.결과를 어디까지 믿을 수 있는가?
딥러닝은 패턴을 잘 찾지만, 항상 진실을 말하거나 원인을 이해하는 것은 아닙니다.
딥러닝을 이해하면 AI 뉴스의 절반이 훨씬 덜 낯설어집니다. 챗GPT, 이미지 생성, 음성 인식, 자율주행, 추천 알고리즘 뒤에는 대개 "데이터를 여러 층에서 바꿔 가며 패턴을 배우는 모델"이 있습니다. 그게 딥러닝의 핵심입니다.
같이 보면 좋은 단어
머신러닝: 딥러닝이 속한 더 큰 범주입니다. AI가 데이터를 보고 배운다는 말의 기본 구조를 이해할 수 있습니다.
GPU와 엔비디아: 딥러닝이 왜 많은 계산 자원을 필요로 하는지, 왜 AI 뉴스에 반도체 기업이 자주 나오는지 연결됩니다.
파라미터: 딥러닝 모델 안에서 학습을 통해 조정되는 숫자입니다. 모델 크기와 성능 이야기를 읽을 때 자주 등장합니다.
참고
1Neural Networks & Deep Learning — Causal Inference and Machine Learning
2Review of deep learning: concepts, CNN architectures, challenges, applications, future directions
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.