


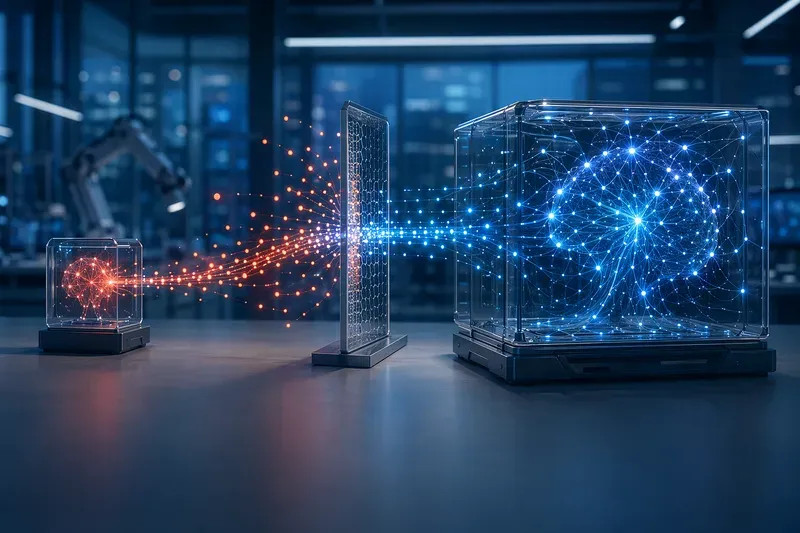
좋은 정답 라벨이 충분하지 않을 때도 강한 AI 모델을 학습시켜야 하는 경우가 있습니다. 이때 등장하는 문제가 약한-강한 일반화입니다. 약한 모델이 만든 라벨을 감독 신호로 사용해 더 강한 학생 모델을 개선하는 접근입니다.1
ICML 2026 논문 Trust Functions: Near-Lossless Weak-to-Strong Generalization은 이 문제를 다른 각도에서 봅니다. 핵심은 “약한 교사의 답을 얼마나 잘 활용할 것인가”가 아니라, 약한 교사의 답 중 무엇을 믿을 것인가입니다.1
약한-강한 일반화는 데이터 선택 문제다
약한 모델의 출력은 완전히 신뢰할 수도, 전부 버릴 수도 없습니다. 어떤 답은 학생 모델에 좋은 학습 신호가 되지만, 어떤 답은 오히려 성능을 해칠 수 있습니다.
이 논문은 그래서 약한-강한 일반화의 핵심을 데이터 선택 문제로 정리합니다. 약한 라벨 중 학습에 사용할 만큼 신뢰할 수 있는 라벨을 식별하는 일이 중요하다는 것입니다.1
이를 위해 제안되는 개념이 Trust function입니다. Trust function은 각 약한 라벨에 스칼라 형태의 신뢰 점수를 부여합니다.1 그리고 Trust filtering은 이 신뢰 점수를 이용해 약한 감독 신호를 걸러내는 방식입니다.
즉, 약한 교사를 그대로 따르는 것이 아니라 언제 믿고 언제 무시할지 결정하는 필터를 두는 셈입니다.
Trust filtering이 바꾸는 것
일반적인 pseudo-labeling에서는 약한 모델이 만든 라벨을 대량으로 사용합니다. 문제는 그 안에 잘못된 신호도 함께 들어간다는 점입니다. 강한 학생 모델은 더 큰 용량을 갖고 있기 때문에, 좋은 신호뿐 아니라 나쁜 신호도 강하게 학습할 수 있습니다.
Trust filtering은 이 위험을 줄입니다. 약한 라벨마다 신뢰도를 평가하고, 학습에 도움이 될 가능성이 높은 신호를 선별합니다. 이 관점에서는 모델을 더 복잡하게 만드는 것보다 학습 데이터의 신뢰도를 관리하는 것이 성능의 핵심 변수가 됩니다.
논문은 Trust filtering을 세계 지식, 정량적 추론, 전략 게임 등 여러 도메인에서 평가했습니다.12 일부 실험에서는 Trust filtering으로 학습한 학생 모델이 정답 라벨 기반 감독과 맞먹거나 이를 넘어서는 성능을 보였습니다.1
이는 중요한 결과입니다. 약한 감독은 보통 정답 라벨보다 낮은 품질의 대체재로 여겨지지만, 잘 선별하면 강한 모델 학습에 충분히 경쟁력 있는 신호가 될 수 있다는 뜻입니다.
왜 단순한 라벨 청소 이상인가
Trust function은 단순히 오답을 제거하는 도구로만 볼 수 없습니다. 논문 관련 자료는 신뢰 필터링이 쉬운 예제부터 배우는 암묵적 커리큘럼을 만들고, 정답 라벨이 불완전한 경우에도 좋은 대안 답을 살릴 수 있으며, 더 일관된 gradient 업데이트를 만든다고 설명합니다.2
이 설명의 실무적 의미는 분명합니다. 약한 라벨의 품질은 “맞다/틀리다”만으로 판단하기 어렵습니다. 어떤 라벨은 완벽한 정답은 아니어도 모델이 배울 만한 구조를 담고 있을 수 있습니다. 반대로 겉보기에는 그럴듯하지만 학습을 방해하는 라벨도 있을 수 있습니다.
따라서 Trust function의 가치는 약한 라벨을 이분법적으로 제거하는 데 있지 않습니다. 강한 학생 모델이 배울 만한 신호를 더 안정적으로 선택하고 배열하는 데 있습니다.
실무에서 봐야 할 기준
이 논문이 주는 실용적 질문은 “약한 모델을 쓸 수 있는가?”가 아닙니다. 더 중요한 질문은 다음입니다.
약한 모델의 출력마다 신뢰도를 매길 수 있는가?
신뢰 점수가 실제 학습 성능과 연결되는가?
낮은 신뢰도의 라벨을 걸러냈을 때 남는 데이터가 충분한가?
정답 라벨이 부족하거나 비싼 영역에서 약한 감독을 대체 신호로 쓸 수 있는가?
모든 약한 라벨을 그대로 사용하는 방식은 간단하지만 위험합니다. 반대로 신뢰 기준을 만들 수 있다면, 라벨 비용을 줄이면서도 강한 모델 학습에 필요한 신호를 확보할 가능성이 커집니다. 특히 라벨이 비싸거나 모호한 영역에서 이 접근은 더 의미가 있습니다.
결론
Trust Functions: Near-Lossless Weak-to-Strong Generalization의 핵심 메시지는 명확합니다. 약한-강한 일반화의 병목은 단순히 모델 크기나 학습 알고리즘만이 아닙니다. 약한 교사의 답 중 무엇을 믿을지 고르는 능력이 강한 학생 모델을 만드는 핵심 변수입니다.
약한 감독을 쓸 때 중요한 것은 더 많은 pseudo-label을 모으는 것만이 아닙니다. 그중 어떤 신호를 학습에 통과시킬지 판단하는 체계가 필요합니다. Trust function은 바로 그 판단을 모델 학습의 중심에 놓는 접근입니다.
참고
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.