


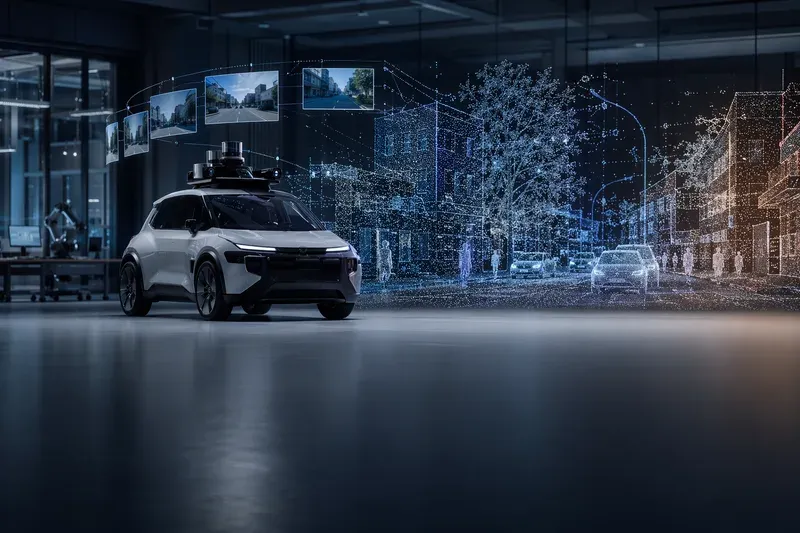
3D LiDAR 모델을 키우는 데 가장 큰 병목 중 하나는 데이터다. LiDAR 의미 분할은 3D 스캔의 각 포인트에 의미 레이블을 붙이는 작업이며, 자율주행 인식에서 핵심 과제로 다뤄진다.1 하지만 실제 LiDAR 스캔을 대규모로 수집하고 촘촘하게 라벨링하는 일은 비용이 크다.
비디오 기반 3D LiDAR 사전학습은 이 병목을 다른 방향에서 푼다. 핵심은 웹 비디오에서 프레임을 추출하고, π³ 같은 3D 복원 모델로 포인트 클라우드를 만든 뒤, 이를 3D·LiDAR 백본의 사전학습 데이터로 사용하는 것이다.2 즉, 실제 3D 스캔을 직접 모으기보다 비디오에서 3D 학습 신호를 끌어내려는 접근이다.
왜 비디오가 3D 사전학습 데이터가 될 수 있나
공간 지능은 사물의 의미와 3D 기하 구조를 함께 포착하는 시각 표현을 필요로 한다.3 예를 들어 자율주행 모델은 “이것이 자동차인가”뿐 아니라 “어디에 있고, 얼마나 떨어져 있으며, 주변 구조와 어떤 관계에 있는가”까지 이해해야 한다.
여기서 기존 사전학습 패러다임은 서로 다른 장단점을 보인다. 비전-언어 모델은 언어 감독을 통해 시각 관측을 의미 개념과 잘 정렬한다.3 반면 비디오 생성 모델은 시간에 따라 변화하는 시각 세계에서 표현을 학습하기 때문에, 깊이·카메라 움직임·밀집 기하와 관련된 신호를 더 잘 드러낼 수 있다.3
비디오 기반 3D 사전학습이 흥미로운 이유가 여기에 있다. 영상에는 시점 변화가 있고, 그 변화는 3D 구조를 추론하는 단서가 된다. 따라서 비디오는 단순한 2D 이미지 묶음이 아니라, “공간을 보는 법”을 학습시키는 대규모 원천 데이터가 될 수 있다.
핵심은 완벽한 스캔이 아니라 확장 가능한 학습 신호다
이 접근을 “실제 LiDAR 스캔의 완전한 대체재”로 이해하면 초점이 흐려진다. 더 중요한 질문은 따로 있다. 비디오에서 생성한 포인트 클라우드가 충분히 크고 다양한 사전학습 신호를 제공할 수 있는가?
관련 연구 노트에 따르면 LAM3C는 온라인 비디오로 만든 RoomTours 데이터셋을 사용하며, 약 4.9만 개의 video-generated point cloud 장면으로 학습한다.2 또한 실제 3D 스캔 없이도 ScanNet fine-tuning 성능에서 기존 실스캔·합성 데이터 기반 방법과 비슷한 수준을 보였다고 보고됐다.2
물론 비디오 생성 포인트 클라우드는 깨끗하지 않다. 흔들림, 누락된 영역, 겹친 표면, 복원 오류 같은 잡음이 생길 수 있다. 따라서 이 방법의 성패는 “비디오를 3D로 바꿀 수 있는가”보다 “잡음이 섞인 대규모 3D 신호에서 견고한 표현을 배울 수 있는가”에 달려 있다.
적용할 때 봐야 할 기준
첫째, 실제 다운스트림 과제에서 성능이 좋아지는지 확인해야 한다. 3D 의미 분할, 인스턴스 분할, 객체 탐지처럼 목표 과제별로 검증해야 하며, 단순히 사전학습 데이터 규모가 커졌다는 사실만으로 충분하지 않다.
둘째, 의미와 기하의 균형을 봐야 한다. 동결 특징 프로빙 연구는 공간 지능을 의미 태깅, 인스턴스 그룹화, 3D 기하 예측의 세 축으로 비교했다.3 그 결과 VLM은 의미 태깅과 인스턴스 그룹화에서 강했고, VGM은 밀집 기하와 카메라 움직임에 대해 더 접근 가능한 신호를 제공했다.3
이 결과는 3D LiDAR 사전학습에도 시사점이 있다. 비디오 기반 학습은 기하 신호를 확장하는 데 강점이 있지만, 의미 이해까지 충분히 확보하려면 다른 감독 신호와의 결합이 중요할 수 있다. 실제로 VLM과 VGM을 단순히 융합하는 것만으로도 기하와 의미 양쪽에서 강한 표현을 얻었다는 보고가 있다.3
결론: LiDAR를 없애는 기술이 아니라 학습 규모를 키우는 기술
비디오 기반 3D LiDAR 모델 사전학습의 가치는 명확하다. 비싼 3D 스캔과 라벨에만 의존하던 학습 파이프라인을, 웹 비디오 규모의 데이터로 확장하려는 시도다.
따라서 앞으로의 관찰 포인트는 세 가지다. 얼마나 큰 비디오 기반 3D 데이터를 만들 수 있는가, 복원 잡음을 얼마나 잘 견디는가, 그리고 실제 자율주행 환경의 LiDAR 과제에서 얼마나 견고하게 성능으로 이어지는가. 이 세 조건을 만족할수록 비디오 기반 사전학습은 3D 인식 모델을 키우는 실용적인 기반 기술에 가까워질 것이다.
1TOWARDS FOUNDATION MODELS FOR LIDAR SEMANTIC SEGMENTATION IN AUTONOMOUS DRIVING
23D sans 3D Scans: Scalable Pre-training from Video-Generated Point Clouds
3Which Pretraining Paradigm Better Serves Spatial Intelligence?
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.