


핵심 요약
월드 모델은 하나의 기술이 아니라, 세계를 보고 만들고 행동하기 위한 여러 기능의 묶음이다.
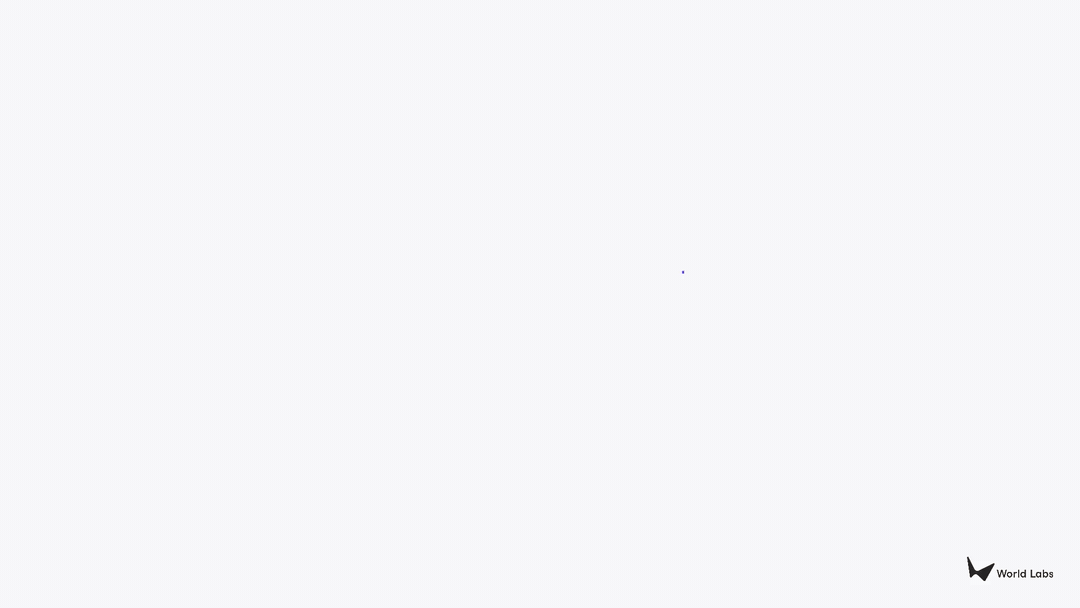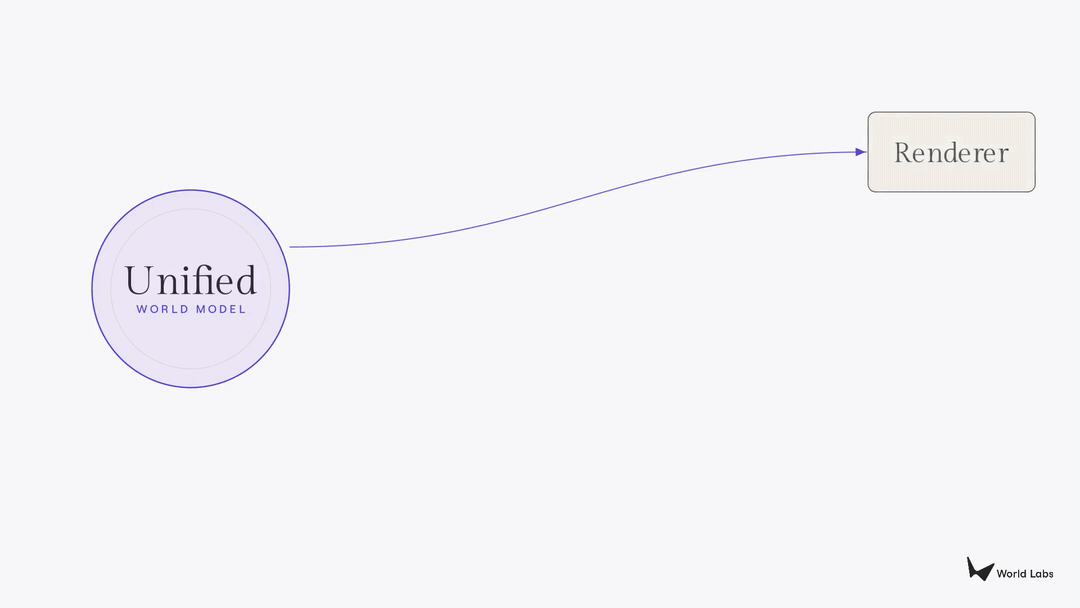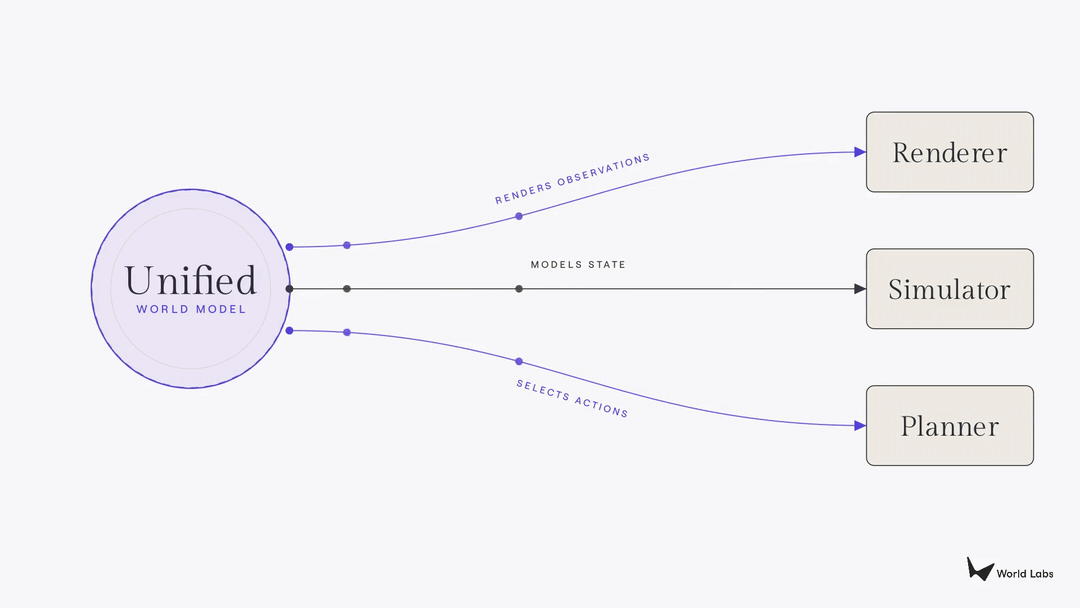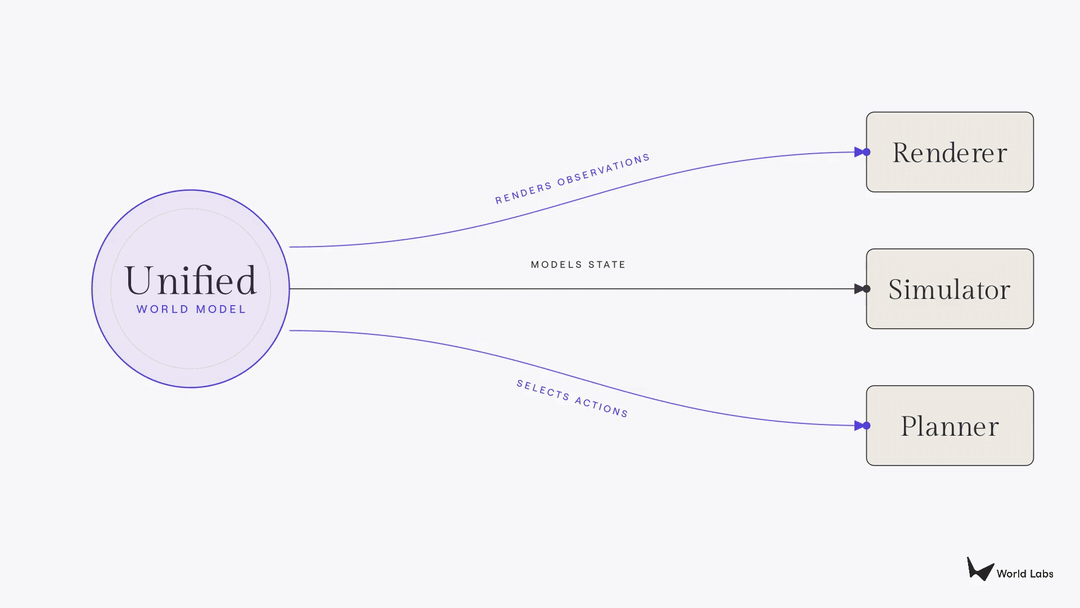
핵심 기능은 관찰을 만드는 렌더러, 상태를 만드는 시뮬레이터, 행동을 결정하는 플래너로 나뉜다.
이 셋은 점점 하나로 합쳐지고 있으며, 그 중심에는 물리적으로 믿을 수 있는 시뮬레이션이 있다.
월드 모델은 "텍스트"가 아니라 "공간과 시간"을 배운다
언어 모델은 단어와 문장의 패턴을 배운다. 반면 월드 모델은 공간, 시간, 물체, 빛, 힘, 움직임의 패턴을 배운다.
예를 들어 언어 모델은 "컵이 테이블 위에 있다"는 문장을 잘 다룰 수 있다. 하지만 월드 모델은 컵의 위치, 모양, 재질, 무게, 밀었을 때의 움직임까지 다뤄야 한다.
그래서 월드 모델은 단순히 예쁜 이미지를 만드는 기술이 아니다. 실제 세계처럼 보이고, 실제 세계처럼 움직이며, 실제 세계 안에서 행동할 수 있게 만드는 기반 기술이다.
에이전트와 세계를 잇는 기본 루프
월드 모델을 이해하려면 에이전트와 세계의 반복 구조를 봐야 한다.
에이전트는 행동을 한다. 행동은 세계의 상태를 바꾼다. 에이전트는 그 상태를 직접 보지 못하고, 카메라 이미지나 센서값 같은 관찰만 받는다. 그 관찰을 바탕으로 다시 다음 행동을 선택한다.
여기서 상태는 세계의 실제 모습이다. 모든 물체의 위치, 속도, 성질까지 포함한 완전한 현실이다.
관찰은 그 상태의 일부만 비친 그림자다. 사람의 눈, 로봇의 카메라, 자율주행차의 라이다는 모두 세계 전체가 아니라 일부 관찰만 제공한다.
렌더러: 세계를 "보이게" 만드는 모델
렌더러는 관찰을 만든다. 쉽게 말해 사람이 볼 수 있는 이미지나 영상을 출력하는 모델이다.
텍스트를 입력하면 영화 같은 드론 영상을 만들어 주는 비디오 생성 모델이 대표적이다. 사용자의 조작에 따라 실시간으로 화면을 만들어내는 인터랙티브 생성 시스템도 렌더러에 속한다.
렌더러의 핵심 기준은 시각적 그럴듯함이다. 보기에는 멋진 도시를 만들 수 있지만, 그 도시의 도로가 실제로 연결되어 있는지, 건물이 물리적으로 안정적인지는 보장하지 않는다.
즉 렌더러는 "무엇처럼 보이는가"에 강하지만, "실제로 무엇인가"에는 약할 수 있다.
시뮬레이터: 세계의 "상태"를 만드는 모델
시뮬레이터는 세계의 구조적 상태를 만든다. 단순히 보기 좋은 화면이 아니라, 기하 구조와 물리 법칙, 동역학을 갖춘 세계를 출력한다.
예를 들어 건축가는 건물이 예쁘게 보이는지만이 아니라 실제 구조가 맞는지 알아야 한다. 로봇 연구자는 컵이 화면에 잘 보이는지만이 아니라 로봇 팔이 컵을 밀었을 때 어떻게 움직이는지 알아야 한다.
시뮬레이터는 인간 전문가와 컴퓨터 프로그램 모두를 위한 도구다. 건축, 게임, 영화, 자율주행, 로봇 학습, 물류, 공장 자동화 같은 분야에서 현실을 대신해 실험할 수 있는 안전한 공간을 제공한다.
플래너: 다음 "행동"을 결정하는 모델
플래너는 관찰과 목표를 받아 다음 행동을 출력한다.
예를 들어 로봇이 "컵을 집어라"라는 목표를 받았다고 하자. 플래너는 카메라로 본 장면을 바탕으로 팔을 어디로 뻗고, 손가락을 어떻게 닫고, 어떤 힘으로 들어 올릴지 결정해야 한다.
렌더러가 행동을 입력받아 관찰을 만든다면, 플래너는 관찰을 입력받아 행동을 만든다. 둘은 서로 반대 방향에서 같은 루프를 다룬다.
플래너는 로봇, 자율 시스템, 에이전트 AI에서 특히 중요하다. 하지만 아직 대부분의 성과는 제한된 실험실 환경에 머물러 있다.
왜 시뮬레이션이 핵심인가
렌더러는 이미 상업적으로 성숙했다. 이미지 생성과 영상 생성 서비스는 빠르게 확산되고 있다. 하지만 시각적으로 그럴듯한 결과가 물리적으로 정확하다는 뜻은 아니다.
플래너는 가장 흥미롭지만 아직 초기 단계다. 실제 주방, 창고, 병원처럼 복잡하고 예측 불가능한 환경에서 안정적으로 작동하는 로봇은 아직 큰 도전이다.
시뮬레이션은 이 둘을 잇는 다리다. 정확한 기하 구조와 물리 법칙이 있으면, 그 위에서 화면도 만들 수 있고 행동 결과도 예측할 수 있다.
그래서 시뮬레이터는 월드 모델의 뼈대에 가깝다. 겉모습이 렌더링이고, 행동이 플래닝이라면, 시뮬레이션은 그 둘이 기대는 현실의 구조다.
시뮬레이션이 어려운 이유
시뮬레이션에는 좋은 데이터가 부족하다. 인터넷에는 영상과 이미지는 많지만, 정확한 3D 구조, 재질, 물리 속성, 충돌 정보가 붙은 데이터는 훨씬 적다.
또한 시뮬레이션과 현실 사이에는 차이가 있다. 가상 환경에서는 잘 작동하던 로봇이 실제 세계에서는 실패할 수 있다. 이를 흔히 sim-to-real gap이라고 부른다.
생성형 시뮬레이터에는 추가 위험도 있다. 겉보기에는 멀쩡한 3D 물체가 내부적으로는 꼬여 있거나, 크기와 비율이 잘못되어 물리 계산이 엉망이 될 수 있다.
특히 딱딱한 물체, 천, 액체, 부드러운 물체가 함께 상호작용하는 다중 물리 시뮬레이션은 계산 비용이 매우 크다.
경계는 점점 무너지고 있다
렌더러, 시뮬레이터, 플래너는 따로 발전해 왔지만, 실제로는 같은 세계 이해를 공유한다.
컵을 제대로 이해하는 모델이라면 컵을 여러 각도에서 그릴 수 있어야 한다. 동시에 컵을 밀었을 때의 움직임도 예측해야 하고, 손으로 집는 행동도 계획할 수 있어야 한다.
최근 연구들은 이 경계를 흐리고 있다. 비디오 생성 모델을 행동 예측에 활용하거나, 하나의 모델이 시각적 표현과 물리 충돌 구조를 함께 출력하는 방식이 등장하고 있다.
결국 중요한 방향은 수동적 출력에서 상호작용 가능한 시스템으로의 전환이다. 예쁜 화면만 만드는 AI에서, 조작하고 실험하고 행동할 수 있는 AI로 이동하는 것이다.
통합 월드 모델의 목표
궁극적인 목표는 하나의 기반 모델이 세 가지 기능을 모두 수행하는 것이다.
필요할 때는 사진처럼 사실적인 장면을 렌더링하고, 필요할 때는 물리적으로 정확한 3D 구조를 만들고, 필요할 때는 목표를 달성하기 위한 행동 순서를 계획하는 모델이다.
이런 모델은 로봇, 자율주행, 게임, 영화, 건축, 제조, 물류, 과학 연구에 큰 영향을 줄 수 있다.
다만 하나의 모델 안에서 시각적 아름다움과 물리적 정밀성을 동시에 만족시키는 일은 매우 어렵다. 예쁘게 보이는 것과 정확하게 작동하는 것은 종종 충돌한다.
인사이트
월드 모델을 볼 때는 "얼마나 그럴듯한가"보다 "무엇을 출력하는가"를 먼저 봐야 한다.
이미지를 출력하면 렌더러, 물리적으로 계산 가능한 상태를 출력하면 시뮬레이터, 행동을 출력하면 플래너다.
실용적으로는 시뮬레이션 능력이 가장 중요한 판별 기준이다. 예쁜 영상은 감탄을 만들지만, 정확한 시뮬레이션은 로봇을 훈련시키고 건물을 검증하며 현실 세계의 결정을 가능하게 한다.
앞으로의 핵심 질문은 이것이다. AI가 세계를 말로 설명하는 것을 넘어, 세계를 만들고 실험하고 그 안에서 행동할 수 있는가.
출처 및 참고 : (1) A Functional Taxonomy of World Models - Dr. Fei-Fei Li
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.