


보는 것과 공간을 이해하는 것은 다르다
카메라가 상자를 본다고 해서 로봇이 곧바로 상자를 다룰 수 있는 것은 아니다. 이미지 인식은 보통 "이 사진에 무엇이 있는가"를 맞히는 일에서 출발한다. 고양이, 사람, 자동차, 의자처럼 물체의 이름을 붙인다. 이것도 중요하지만 피지컬 AI에는 충분하지 않다.
피지컬 AI가 알아야 할 질문은 더 구체적이다.
그 물체가 내 앞 몇 미터에 있는가?
내 팔이 닿을 수 있는 위치인가?
사람과 충돌하지 않고 지나갈 수 있는가?
물체가 움직이고 있는가, 멈춰 있는가?
지금 행동하면 다음 순간 공간은 어떻게 바뀌는가?
즉, 피지컬 AI의 지능은 단순히 보는 능력이 아니라 공간 속 관계를 이해하는 능력에서 시작된다. "무엇이 보이는가"에서 "어디에 있고, 얼마나 떨어져 있으며, 어떻게 움직일 수 있는가"로 확장되어야 한다.
예를 들어 물류 로봇이 창고 통로에서 사람과 팔레트를 동시에 본다고 하자. 이미지 인식만 한다면 "사람 1명, 팔레트 1개"라고 말할 수 있다. 하지만 공간 이해를 하는 로봇은 다르게 판단한다. 사람은 오른쪽에서 왼쪽으로 걷고 있고, 팔레트는 통로 중간을 막고 있으며, 왼쪽 벽과 팔레트 사이에는 로봇이 지나가기엔 폭이 좁다고 계산한다. 그래서 속도를 줄이거나 멈추거나 우회 경로를 찾는다.
이 차이가 피지컬 AI를 화면 속 AI와 구분한다.
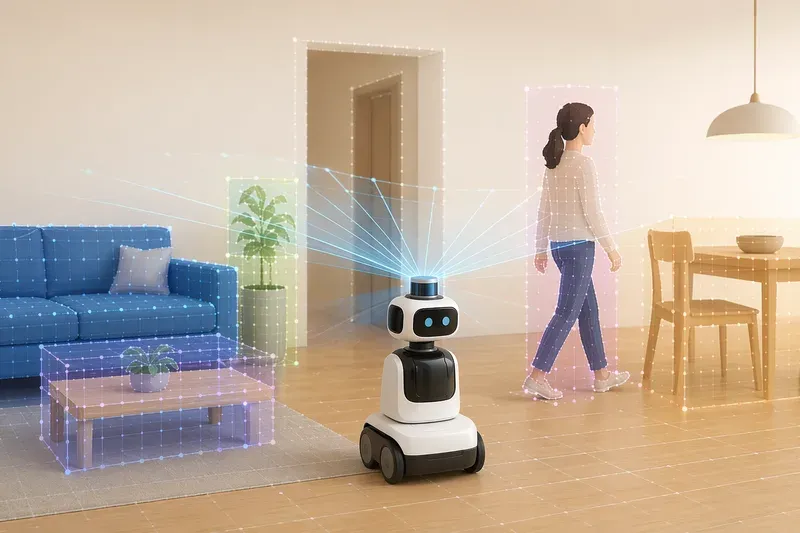 AI 생성 이미지
2차원 이미지에서 3차원 세계로
현실 세계는 3차원이다. 그러나 카메라 이미지는 기본적으로 2차원이다. 사진 안에서는 멀리 있는 큰 물체와 가까이 있는 작은 물체가 비슷한 크기로 보일 수 있다. 따라서 피지컬 AI는 이미지에 담긴 색과 형태만이 아니라 깊이를 추정해야 한다.
깊이 추정은 각 물체가 센서로부터 얼마나 떨어져 있는지 계산하는 기술이다. 사람의 두 눈이 조금 다른 각도에서 같은 장면을 보고 거리감을 얻는 것처럼, 로봇도 두 대의 카메라를 사용해 거리 차이를 계산할 수 있다. 이를 스테레오 비전이라고 한다. 스테레오 비전은 두 이미지 사이의 차이를 이용해 물체까지의 거리를 추정한다.
라이다는 빛을 쏘고 되돌아오는 시간을 측정해 깊이를 얻는다. 깊이 카메라는 픽셀마다 거리 정보를 함께 제공한다. 어떤 방식이든 목표는 같다. 평면 이미지에 보이는 물체를 실제 공간의 위치로 옮겨 놓는 것이다.
이렇게 얻은 정보는 점들의 집합으로 표현될 수 있다. 앞 장에서 본 포인트 클라우드가 대표적이다. 포인트 클라우드는 물체와 벽, 바닥의 표면을 3차원 점으로 나타낸다. 로봇은 이 점들을 보고 "여기는 벽이다", "여기는 빈 공간이다", "이 물체는 내 진행 방향을 막고 있다"라고 판단한다.
최근 로봇 인식 시스템은 깊이 추정, 위치 추정, 물체 자세 추적, 3D 재구성, 지도 생성을 하나의 흐름으로 묶어 사용한다. 이는 로봇이 단순히 보이는 대상을 분류하는 데서 그치지 않고, 물체가 어디에 있으며 어떤 방향을 향하고 있고 어디로 안전하게 움직일 수 있는지를 파악하기 위해서다.1
SLAM: 지도와 내 위치를 동시에 찾기
피지컬 AI가 움직이려면 두 가지를 알아야 한다. 첫째, 주변 공간이 어떻게 생겼는가. 둘째, 그 공간 안에서 내가 어디에 있는가.
이 두 문제를 함께 푸는 기술이 SLAM이다. SLAM은 Simultaneous Localization and Mapping의 약자로, 한국어로는 동시적 위치 추정 및 지도 작성이라고 부른다. 쉽게 말해 "낯선 공간을 돌아다니며 지도를 만들고, 동시에 그 지도 안에서 자기 위치를 찾는 기술"이다.
사람도 비슷한 일을 한다. 처음 들어간 건물에서 우리는 복도, 문, 계단, 안내판을 보며 머릿속에 대략적인 지도를 만든다. 동시에 "나는 지금 입구에서 오른쪽으로 꺾은 뒤 두 번째 복도에 있다"라고 자신의 위치를 추정한다. 로봇도 센서 데이터로 이 과정을 수행한다.
SLAM이 필요한 이유는 현실 공간이 항상 미리 준비된 지도처럼 깔끔하지 않기 때문이다. 공장에는 임시 적재물이 생기고, 물류센터에는 박스 위치가 바뀌며, 병원 복도에는 침대와 사람이 이동한다. 자율주행차도 도로 공사, 주차 차량, 보행자처럼 계속 변하는 요소를 만난다.
SLAM 시스템은 카메라, 라이다, IMU 같은 센서 정보를 사용한다. IMU는 관성 측정 장치로, 기기의 회전과 가속도를 측정한다. 로봇은 바퀴가 얼마나 돌았는지, 카메라 장면이 어떻게 바뀌었는지, 라이다 점들이 이전 순간과 어떻게 이어지는지 비교한다. 그 결과 "내가 조금 앞으로 이동했다", "오른쪽으로 회전했다", "이 벽은 이전에 본 벽과 같은 벽이다"라고 추정한다.
이 과정이 안정적이어야 행동도 안정적이다. 자신의 위치를 30cm 잘못 알면 좁은 통로에서 벽에 부딪힐 수 있다. 로봇 팔이 물체의 위치를 몇 cm 잘못 계산하면 집게가 상자를 놓치거나 옆 물체를 칠 수 있다. 공간 이해는 곧 안전의 문제다.
지도는 그림이 아니라 행동을 위한 구조다
사람에게 지도는 길을 찾기 위한 그림처럼 보인다. 하지만 피지컬 AI의 지도는 단순한 그림이 아니다. 행동을 계산하기 위한 구조다.
로봇의 지도에는 여러 정보가 들어간다.
벽, 기둥, 선반처럼 움직이지 않는 구조물
사람, 차량, 다른 로봇처럼 움직이는 대상
지나갈 수 있는 빈 공간
충돌 위험이 있는 장애물
작업 대상의 위치와 크기
바닥의 경사, 턱, 좁은 통로 같은 이동 조건
이 정보는 때로 점유 격자로 표현된다. 점유 격자는 공간을 작은 칸으로 나누고, 각 칸이 비어 있는지, 막혀 있는지, 불확실한지를 표시하는 방식이다. 3차원에서는 작은 정육면체 단위인 복셀을 사용하기도 한다. 복셀은 2차원 이미지의 픽셀을 3차원으로 확장한 개념이다.
예를 들어 청소 로봇은 거실을 작은 칸으로 나누어 소파가 있는 칸, 벽이 있는 칸, 지나갈 수 있는 칸을 구분한다. 물류 로봇은 통로 폭과 장애물 위치를 반영해 이동 가능한 영역을 계산한다. 자율주행차는 차선, 연석, 보행자, 주변 차량, 신호등 위치를 함께 고려해 주행 가능한 공간을 찾는다.
중요한 점은 지도 자체가 목적이 아니라는 것이다. 지도는 행동 후보를 만들기 위한 중간 표현이다. 피지컬 AI는 지도를 바탕으로 "왼쪽으로 피한다", "속도를 줄인다", "멈춘다", "팔을 위로 들어 집는다" 같은 선택지를 만든다.
거리와 방향이 행동 후보를 만든다
공간 이해의 핵심은 관계 계산이다. 피지컬 AI는 물체 하나를 따로 보지 않는다. 사람, 물체, 장애물, 자기 몸의 위치를 함께 본다.
협동 로봇 팔을 생각해 보자. 로봇 팔 앞에 상자가 있고, 옆에는 작업자가 있다. 로봇은 상자의 이름만 알아서는 안 된다. 상자의 중심이 어디인지, 집게가 잡을 수 있는 면은 어디인지, 작업자의 손과 얼마나 떨어져 있는지, 팔을 움직일 때 지나가는 경로가 안전한지 계산해야 한다.
이때 필요한 정보는 다음과 같다.
물체까지의 거리
물체의 크기와 방향
사람과 로봇 사이의 거리
로봇 팔이 움직일 수 있는 범위
충돌 가능성이 있는 경로
행동 후 물체가 놓일 위치
자율주행차도 마찬가지다. 앞차를 인식하는 것만으로는 부족하다. 앞차와의 거리, 상대 속도, 옆 차선 차량의 위치, 보행자의 이동 방향, 정지선까지의 거리, 도로 곡률을 함께 계산해야 한다. 그래야 감속할지, 차선을 유지할지, 정지할지 결정할 수 있다.
일부 연구와 시스템은 카메라로 감지한 물체의 깊이와 실제 크기를 추정한 뒤, 이를 SLAM 지도 안의 장애물 정보로 바꾸어 경로 계획에 사용한다. 즉, "보이는 물체"를 "피해야 할 공간" 또는 "작업해야 할 대상"으로 변환하는 것이다.2
이 변환이 피지컬 AI의 중요한 단계다. 감지된 데이터는 그대로 행동이 되지 않는다. 데이터는 위치, 거리, 방향, 크기, 위험도 같은 형태로 정리되어야 한다. 그래야 판단 단계가 안전한 행동 후보를 비교할 수 있다.
시간에 따라 변하는 장면을 추적하기
정적인 사진 분석은 한 순간을 다룬다. 하지만 피지컬 AI가 만나는 현실은 계속 변한다. 사람은 걷고, 문은 열리고, 상자는 밀리고, 자동차는 가속하고, 로봇 자신도 움직인다.
따라서 피지컬 AI는 장면을 한 번 이해하고 끝낼 수 없다. 계속 추적해야 한다. 추적은 같은 대상이 시간에 따라 어디로 이동하는지 이어서 파악하는 과정이다.
물류센터의 이동 로봇이 앞에 있는 사람을 본다고 하자. 첫 순간에는 사람이 오른쪽에 있다. 0.5초 뒤에는 통로 중앙으로 이동한다. 다시 0.5초 뒤에는 로봇의 경로와 겹칠 수 있다. 로봇은 현재 위치만 보는 것이 아니라 짧은 미래를 예측해야 한다. "지금 속도로 계속 가면 2초 뒤 충돌 가능성이 있다"라고 판단해야 안전하게 멈출 수 있다.
이것이 어려운 이유는 센서 데이터가 완벽하지 않기 때문이다. 사람은 선반 뒤로 잠깐 가려질 수 있다. 반사되는 바닥 때문에 라이다 점이 흔들릴 수 있다. 카메라는 조명 변화에 영향을 받는다. 로봇 자신이 움직이면 화면 전체가 바뀌어 보인다.
그래서 피지컬 AI는 공간을 기억해야 한다. 방금 전 보였던 사람이 잠깐 가려졌다고 해서 사라졌다고 판단하면 위험하다. 이전 위치와 이동 방향을 바탕으로 "아직 저 근처에 있을 가능성이 높다"고 추정해야 한다. 이처럼 공간 이해에는 현재 감지뿐 아니라 짧은 시간의 기억이 포함된다.
공간 이해는 판단과 제어의 출발점이다
피지컬 AI의 흐름은 감지한다–판단한다–행동한다–피드백을 받는다로 이어진다. 공간 이해는 감지와 판단 사이에 놓인 핵심 단계다.
센서가 현실을 데이터로 바꾸면, 공간 이해는 그 데이터에 구조를 부여한다. 어디가 비어 있는지, 어디가 막혀 있는지, 무엇이 움직이는지, 무엇을 잡아야 하는지, 어디로 가면 위험한지 정리한다. 그런 다음 판단 시스템은 목표와 제약을 고려해 행동을 선택한다.
좋은 공간 이해는 로봇을 똑똑하게 보이게 만든다. 그러나 더 정확히 말하면, 좋은 공간 이해는 로봇이 무리하지 않게 만든다. 지나갈 수 없는 곳을 억지로 지나가지 않고, 사람 가까이에서 속도를 줄이고, 물체를 잡기 전에 위치를 다시 확인하게 한다.
피지컬 AI에서 지능은 큰 명령을 이해하는 능력만이 아니다. "저 상자를 옮겨라"라는 명령을 실행하려면 상자의 위치, 주변 장애물, 사람과의 거리, 로봇 팔의 경로, 놓을 장소의 여유 공간을 모두 알아야 한다. 현실의 지능은 공간 속에서 검증된다.
다음 단계는 이렇게 이해한 공간을 바탕으로 무엇을 할지 정하는 일이다. 피지컬 AI는 가능한 행동 후보 중에서 안전하고 효율적인 선택을 해야 한다. 이때 필요한 것이 판단과 계획이다.
참고
1R²D²: Building AI-based 3D Robot Perception and Mapping with NVIDIA Research
2Object Depth and Size Estimation using Stereo-vision and Integration with SLAM
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.