


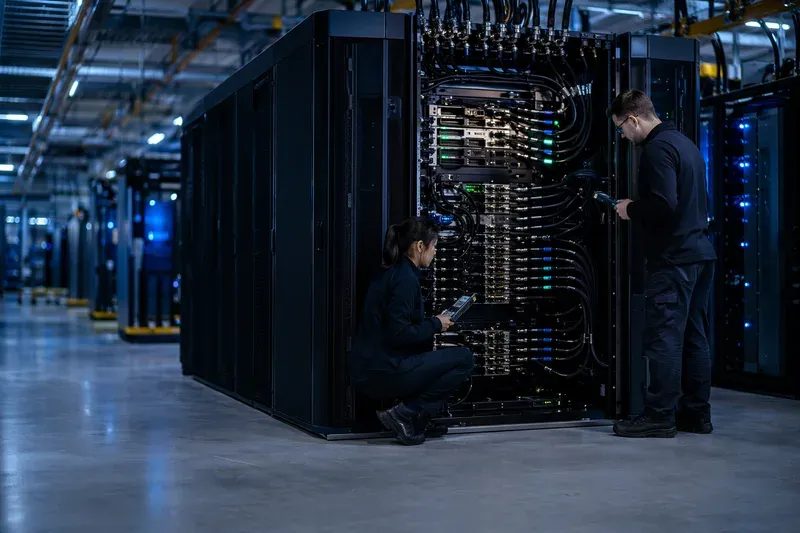
Michael Dell이 Dell과 NVIDIA가 첫 Vera Rubin NVL72 시스템을 CoreWeave에 전달했고, 이 시스템이 L11 진단을 통과했다고 밝히면서 Vera Rubin NVL72에 대한 관심이 커졌습니다. 그러나 이 소식의 핵심은 단순한 “첫 출하”가 아닙니다. 더 중요한 변화는 AI 인프라의 설계 기준이 에이전트형 추론에 맞춰 재편되고 있다는 점입니다.
Vera Rubin NVL72는 무엇인가
Vera Rubin NVL72는 NVIDIA Vera Rubin 플랫폼의 핵심 컴퓨트 엔진입니다. NVIDIA는 이 시스템이 에이전트형 AI 추론 부하의 상당 부분을 처리한다고 설명합니다.1
이 시스템은 단일 GPU 제품이라기보다 랙 단위 AI 컴퓨터에 가깝습니다. 랙 하나에 72개의 Rubin GPU와 36개의 Vera CPU가 들어가는 구조로 소개되며,2 NVIDIA 자료 기준으로 랙당 최대 3,600 PFLOPS의 NVFP4 연산 성능, 20.7TB의 HBM4, 1.6PB/s의 메모리 대역폭을 제공합니다.1
따라서 Vera Rubin NVL72를 이해할 때는 “새 GPU가 얼마나 빠른가”보다 “랙 전체가 어떻게 하나의 추론 시스템으로 동작하는가”를 봐야 합니다.
왜 에이전트형 AI가 인프라 기준을 바꾸는가
에이전트형 AI는 한 번의 질문에 한 번 답하고 끝나는 방식이 아닙니다. 한 세션 안에서 계획 수립, 도구 호출, 관찰, 재질문이 반복되며 수백 건의 추론 요청이 이어질 수 있습니다.1
이 구조에서는 개별 요청의 평균 처리 속도만으로는 충분하지 않습니다. 여러 단계의 요청이 누적되기 때문에 작은 지연도 전체 응답 시간을 크게 늘릴 수 있습니다. 특히 프리미엄 AI 서비스의 에이전트형 디코드는 멀티턴 요청, 작은 배치, 매우 낮은 지연을 동시에 요구합니다.1
장문 컨텍스트와 조 단위 파라미터 MoE 모델도 부담을 키웁니다. KV 캐시, 시스템 프롬프트, 도구 정의, 대화 이력 같은 데이터가 여러 가속기 사이에서 처리되어야 하기 때문입니다.1 결국 에이전트형 AI에서는 연산 성능뿐 아니라 메모리 용량, 메모리 대역폭, 가속기 간 연결 구조가 함께 중요해집니다.
Vera Rubin NVL72에서 봐야 할 기준
Vera Rubin NVL72를 평가할 때 FLOPS만 보는 것은 부족합니다. 실제 서비스 관점에서는 다음 기준이 더 중요해집니다.
첫째, 장문 컨텍스트를 얼마나 안정적으로 처리할 수 있는가.
둘째, 많은 사용자가 동시에 접속해도 지연 시간이 크게 흔들리지 않는가.
셋째, 토큰당 비용이 실제 서비스 매출 구조와 맞는가.
NVIDIA는 Vera Rubin NVL72가 프리필, 장문 컨텍스트 디코드 어텐션, 고동시성 서빙을 처리하는 역할을 맡는다고 설명합니다.1 이는 AI 인프라 경쟁의 초점이 단순한 GPU 수량에서 랙 단위의 메모리, 대역폭, 서빙 구조로 이동하고 있음을 보여줍니다.
결론: 첫 출하보다 중요한 것은 설계 방향이다
첫 Vera Rubin NVL72 전달 소식은 분명 상징적인 출하 이벤트입니다. 하지만 더 큰 의미는 에이전트형 AI 시대에 필요한 인프라의 기준이 구체화되고 있다는 데 있습니다.
앞으로 AI 서비스를 설계하거나 인프라를 평가할 때는 최대 연산 성능만으로 판단하기 어렵습니다. 지연 시간, 메모리 대역폭, 장문 컨텍스트 처리 능력, 동시 서빙 성능을 함께 봐야 합니다. Vera Rubin NVL72는 이러한 변화가 랙 단위 시스템으로 구현되고 있음을 보여주는 사례입니다.
1How the NVIDIA Vera Rubin Platform is Solving Agentic AI's Scale-Up Problem
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.