


핵심 요약
DeepSWE는 Datacurve가 2026년 5월 공개한 장기 소프트웨어 엔지니어링 벤치마크다.1
목적은 AI 코딩 에이전트가 실제 개발 업무처럼 긴 호흡의 복잡한 작업을 수행할 수 있는지 평가하는 것이다.
113개 태스크, 91개 오픈소스 저장소, 5개 언어를 다루며, 짧은 프롬프트로 긴 구현을 요구한다.1
SWE-Bench Pro보다 과제가 크고, 검증기 오류율이 낮다는 점을 핵심 차별점으로 내세운다.2
공개 리더보드에서는 GPT-5.5가 70%로 선두이며, GPT-5.4 56%, Claude Opus 4.7 54%가 뒤를 이었다.3
다만 공개 직후 자료이므로, 독립 검증과 후속 논의가 필요하다.
DeepSWE란 무엇인가
DeepSWE는 AI 코딩 에이전트를 평가하기 위한 장기 작업 중심 벤치마크다. Datacurve는 기존 공개 벤치마크가 비교적 짧고 명확한 수정 과제에 치우쳐 있어, 실제 개발자가 에이전트에게 맡기는 복잡한 업무를 충분히 반영하지 못한다고 본다.1
핵심 문제의식은 단순하다. 좋은 코딩 에이전트는 한 파일의 작은 버그만 고치는 도구가 아니라, 낯선 코드베이스를 탐색하고, 관련 파일을 찾고, 구현 방향을 정하고, 테스트와 회귀 문제까지 확인해야 한다. DeepSWE는 바로 이 능력을 보려는 평가다.
목적
AI 코딩 에이전트가 실제 개발 업무에 가까운 긴 작업을 수행할 수 있는지 평가한다.
단순 코드 생성 능력보다 코드베이스 탐색, 요구사항 해석, 구현, 검증, 회귀 방지 능력을 함께 본다.
기존 벤치마크에서 비슷해 보이던 상위 모델 간 차이를 더 뚜렷하게 드러내려 한다.
기업이 AI 코딩 도구를 고를 때, 단순 리더보드 점수가 아니라 과제 설계와 검증 방식까지 보게 만드는 데 의미가 있다.
핵심 특징
총 113개 태스크로 구성되어 있다.
91개 활성 오픈소스 저장소를 대상으로 한다.
언어는 TypeScript, Go, Python, JavaScript, Rust 5개다.1
프롬프트는 짧고 자연스럽지만, 실제 구현은 길고 복잡하다.
태스크는 기존 커밋이나 PR을 그대로 가져오지 않고 새로 작성해 오염 가능성을 낮췄다.
검증기는 구현 방식이 아니라 관찰 가능한 동작을 기준으로 수동 작성되었다.1
태스크마다 에이전트가 읽는 프롬프트, 실행 가능한 검증기, 리뷰용 참고 구현이 포함된다.
검증기는 공개 API와 출력 결과를 중심으로 확인하도록 설계되어, 정답 구현과 다른 방식의 해결도 받아들일 수 있게 했다.
DeepSWE의 중요한 설계 방향은 "짧게 지시하고, 길게 해결하게 한다"는 점이다. 실제 개발 현장에서는 사용자가 에이전트에게 모든 함수명과 내부 구조를 상세히 지정하지 않는다. 보통 원하는 동작을 짧게 설명하고, 에이전트가 스스로 코드 구조를 파악하길 기대한다. DeepSWE는 이 상황을 평가에 반영하려 한다.
SWE-Bench Pro와의 차이
DeepSWE가 가장 강하게 비교하는 대상은 SWE-Bench Pro다.
SWE-Bench Pro 과제는 평균 약 120줄의 코드 변경으로 해결되는 반면, DeepSWE 참고 구현은 평균 668줄 수준이다.2
VentureBeat 보도에 따르면 DeepSWE는 SWE-Bench Pro보다 더 짧은 프롬프트를 주면서도 약 5.5배 많은 코드 작성을 요구한다.3
SWE-Bench Pro 검증기는 Datacurve 감사에서 약 8% false positive, 24~25% false negative를 보였고, 전체적으로 약 32% disagreement가 있었다.1
DeepSWE 검증기는 같은 방식의 비교에서 약 1.4% disagreement로 보고되었다.1
여기서 중요한 점은 검증기 품질이다. 벤치마크 점수는 결국 "무엇을 정답으로 인정하느냐"에 크게 의존한다. 검증기가 너무 좁으면 올바른 대안 구현을 틀렸다고 할 수 있고, 너무 허술하면 부분 구현을 맞았다고 할 수 있다. DeepSWE는 이 문제를 줄이기 위해 행동 기반 검증기를 직접 작성했다고 설명한다.
공개 리더보드 요지
DeepSWE 공개 결과에서는 기존 벤치마크에서 비슷해 보이던 모델 간 격차가 크게 벌어졌다.
GPT-5.5: 70%
GPT-5.4: 56%
Claude Opus 4.7: 54%
Claude Sonnet 4.6: 32%
Gemini 3.5 Flash: 28%
GPT-5.4-mini, Kimi K2.6: 각 24%3
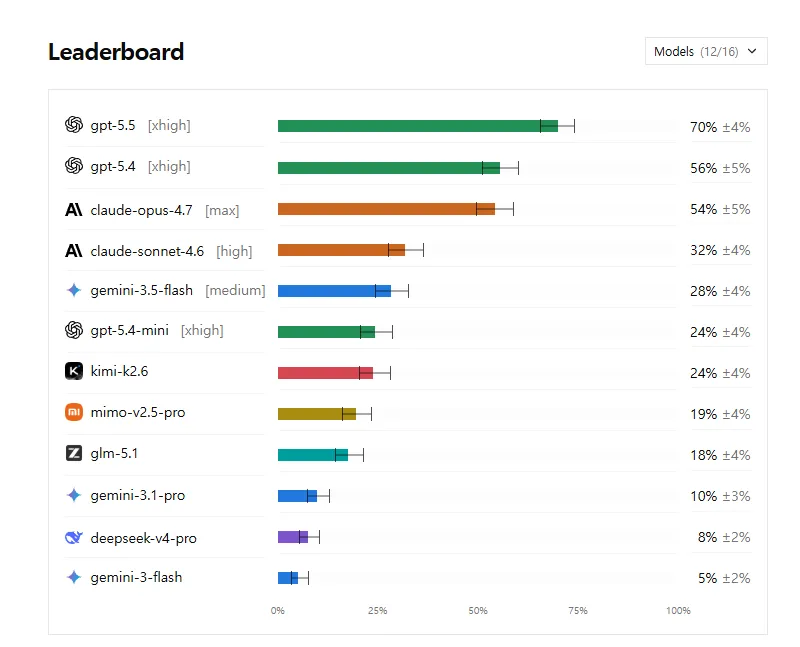
이 결과의 메시지는 "상위 모델이 모두 비슷하다"는 인상을 흔든다는 데 있다. 특히 GPT-5.5가 선두로 제시되며, 긴 호흡의 실제형 과제에서는 모델 간 차이가 더 크게 드러날 수 있음을 보여준다.
시사점
DeepSWE가 던지는 첫 번째 메시지는 벤치마크 오염 문제다. 기존 GitHub 이슈나 PR, 커밋에서 과제를 가져오면 모델이 사전학습 중에 문제나 해법을 봤을 가능성이 생긴다. 이런 경우 점수는 문제 해결 능력이 아니라 기억이나 검색 능력을 반영할 수 있다.
두 번째 메시지는 검증 취약성이다. 자동 테스트가 있다고 해서 항상 좋은 채점기는 아니다. 원래 PR에 붙어 있던 테스트는 특정 구현을 확인하기 위해 만들어졌을 수 있고, 미래의 다양한 해결책을 공정하게 평가하도록 설계된 것은 아닐 수 있다.
세 번째 메시지는 실제 엔지니어링 작업에 가까운 평가가 필요하다는 점이다. AI 코딩 도구는 점점 더 긴 작업을 맡고 있다. 따라서 평가도 단일 파일 수정이나 짧은 패치보다, 여러 파일과 복잡한 코드 구조를 다루는 방향으로 가야 한다.
기업 입장에서는 리더보드 점수만 보면 위험하다. 어떤 과제로 평가했는지, 과제가 기존 공개 데이터와 얼마나 독립적인지, 검증기가 올바른 대안 구현을 받아들이는지, 특정 하네스나 도구 사용 방식에 점수가 좌우되는지를 함께 봐야 한다.
주의점
DeepSWE는 공개 직후의 벤치마크다. Datacurve가 제시한 수치와 분석은 흥미롭지만, 아직 독립적인 재현과 외부 검토가 충분히 쌓였다고 보기는 어렵다.
따라서 현재 단계에서는 DeepSWE를 "기존 AI 코딩 벤치마크의 약점을 지적하는 강한 문제 제기"이자 "장기 소프트웨어 엔지니어링 평가를 향한 새 시도"로 보는 것이 적절하다. 최종 판단은 후속 검증, 커뮤니티 논의, 다른 하네스와 모델 조합의 반복 평가를 지켜본 뒤 내려야 한다.
출처
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.