


Dataset과 DataLoader로 데이터 공급하기

데이터는 한 번에 전부 넣지 않는다
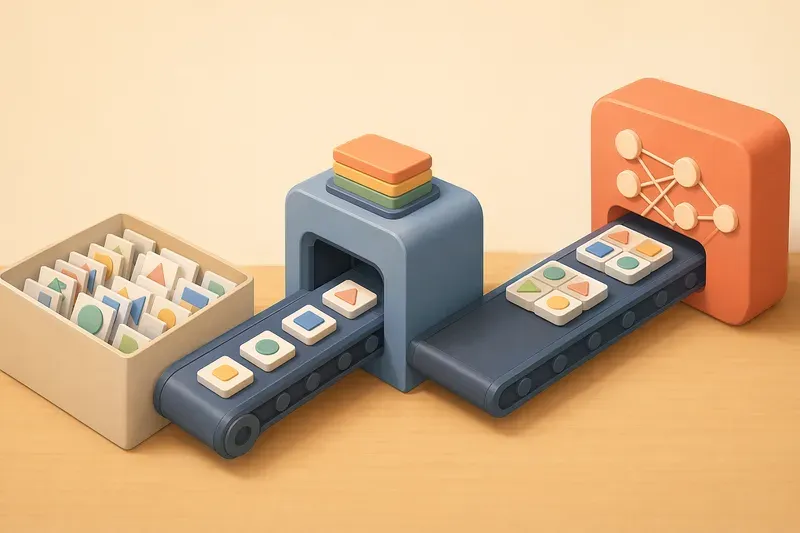
모델을 학습시킬 때 데이터를 한꺼번에 모두 넣는 경우는 드뭅니다. 데이터가 많으면 메모리에 부담이 되고, 학습도 불안정해질 수 있습니다. 그래서 PyTorch에서는 데이터를 샘플 단위로 관리하고, 학습할 때는 여러 샘플을 묶은 배치 단위로 모델에 전달합니다.
이때 역할이 나뉩니다.
Dataset: 데이터에서 샘플 하나를 꺼내는 역할DataLoader: 여러 샘플을 배치로 묶고, 필요하면 순서를 섞는 역할
좋은 학습 코드는 데이터를 직접 for문으로 뒤섞고 나누지 않습니다. Dataset과 DataLoader에 맡기면 코드가 짧아지고, 학습 루프도 깔끔해집니다.
FashionMNIST 데이터셋 불러오기
이번에는 torchvision에서 제공하는 FashionMNIST를 사용합니다. 옷, 신발, 가방 같은 흑백 이미지가 들어 있는 간단한 이미지 분류 데이터셋입니다.
import torch
from torch.utils.data import DataLoader
from torchvision import datasets
from torchvision.transforms import ToTensor

train_data = datasets.FashionMNIST(
    root="data",
    train=True,
    download=True,
    transform=ToTensor()
)

test_data = datasets.FashionMNIST(
    root="data",
    train=False,
    download=True,
    transform=ToTensor()
)train=True는 학습용 데이터를 뜻합니다. train=False는 테스트용 데이터를 뜻합니다. 두 데이터를 분리하는 이유는 중요합니다. 모델은 학습 데이터로 공부하고, 테스트 데이터로 실력을 확인해야 합니다. 공부한 문제로만 점수를 매기면 실제 성능을 공정하게 알 수 없습니다.
transform=ToTensor()는 이미지를 PyTorch 텐서로 바꾸는 최소한의 변환입니다. 변환은 다음 장에서 더 자세히 다룹니다.
Dataset은 샘플 하나를 꺼낸다
Dataset은 리스트처럼 사용할 수 있습니다. len()으로 전체 개수를 확인하고, 인덱스로 샘플 하나를 꺼낼 수 있습니다.
print(len(train_data))
print(len(test_data))

image, label = train_data[0]

print(image.shape)
print(label)
FashionMNIST 이미지 하나의 shape는 보통 다음과 같습니다.
torch.Size([1, 28, 28])앞의 1은 채널 수입니다. 흑백 이미지라서 채널이 1개입니다. 뒤의 28, 28은 이미지의 높이와 너비입니다. label은 이 이미지가 어떤 종류인지 나타내는 정답 번호입니다.
DataLoader는 배치로 묶는다
모델은 보통 샘플 하나씩 학습하지 않고, 여러 개를 묶은 배치로 학습합니다. DataLoader는 이 작업을 담당합니다.
batch_size = 64

train_loader = DataLoader(
    train_data,
    batch_size=batch_size,
    shuffle=True
)

test_loader = DataLoader(
    test_data,
    batch_size=batch_size,
    shuffle=False
)batch_size=64는 한 번에 이미지 64개를 모델에 넣겠다는 뜻입니다. 배치 크기가 너무 작으면 학습이 흔들릴 수 있고, 너무 크면 메모리를 많이 사용합니다. 초보 단계에서는 32나 64부터 시작하면 충분합니다.
shuffle=True는 학습 데이터를 매 epoch마다 섞겠다는 뜻입니다. 데이터가 항상 같은 순서로 들어가면 모델이 순서에 영향을 받을 수 있습니다. 학습 데이터는 보통 섞습니다. 반대로 테스트 데이터는 성능 확인이 목적이므로 보통 섞지 않습니다.
배치의 shape 확인하기
이제 DataLoader에서 배치 하나를 꺼내 보겠습니다.
for X, y in train_loader:
    print("X shape:", X.shape)
    print("y shape:", y.shape)
    print("X dtype:", X.dtype)
    print("y dtype:", y.dtype)
    break
출력은 보통 다음과 비슷합니다.
X shape: torch.Size([64, 1, 28, 28])
y shape: torch.Size([64])
X dtype: torch.float32
y dtype: torch.int64X는 이미지 배치입니다. [64, 1, 28, 28]은 이미지 64장, 채널 1개, 높이 28, 너비 28을 뜻합니다. y는 라벨 배치입니다. 이미지 64장에 대응하는 정답 번호 64개가 들어 있습니다.
앞으로 학습 루프에서는 이 X와 y를 모델에 전달합니다. 보통 흐름은 다음과 같습니다.
for X, y in train_loader:
    # X: 입력 이미지 배치
    # y: 정답 라벨 배치
    pass
이 구조가 PyTorch 학습 코드의 기본 뼈대입니다.
핵심 정리
Dataset은 샘플 하나를 꺼내는 방법을 알고 있습니다. DataLoader는 그 샘플들을 배치로 묶고, 학습에 맞게 순서를 섞어 줍니다.
학습 데이터와 테스트 데이터는 반드시 분리해야 합니다. 모델은 학습 데이터로만 배워야 하고, 테스트 데이터는 마지막에 성능을 확인하는 용도로 사용해야 합니다.
다음 장에서는 ToTensor()처럼 입력 데이터를 모델에 맞게 바꾸는 Transform을 더 자세히 살펴봅니다.
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.