


이 장에서 배울 것
이번 장에서는 가장 기본적인 지도학습 모델 두 가지를 배운다. 하나는 선형 회귀이고, 다른 하나는 로지스틱 회귀다.
선형 회귀는 숫자를 예측하는 모델이다. 예를 들어 공부 시간으로 시험 점수를 예측하거나, 집의 면적과 위치 정보로 집값을 예측할 때 쓴다. 로지스틱 회귀는 이름에 "회귀"가 들어가지만 주로 분류에 사용한다. 예를 들어 이메일이 스팸인지 아닌지, 고객이 이탈할지 남을지 예측할 때 쓴다.
이 장의 목표는 공식을 외우는 것이 아니다. 선형 모델이 데이터를 어떻게 바라보고, 어떤 방식으로 예측하며, 결과를 어떻게 평가하는지 이해하는 것이다.
왜 이 주제가 중요한가
머신러닝을 처음 배울 때 복잡한 모델부터 배우면 모델이 왜 그런 예측을 했는지 알기 어렵다. 반면 선형 회귀와 로지스틱 회귀는 구조가 단순하다. 그래서 모델이 어떤 특징을 중요하게 봤는지 해석하기 쉽다.
단순한 모델은 약한 모델이 아니다. 실제 프로젝트에서는 먼저 단순한 모델을 기준점으로 만든다. 이 기준 모델보다 복잡한 모델이 확실히 좋아지는지 확인해야 한다. 만약 선형 회귀나 로지스틱 회귀만으로도 충분한 성능이 나온다면, 굳이 더 복잡한 모델을 쓸 필요가 없다.
좋은 머신러닝 실무자는 "가장 강력한 모델"을 먼저 찾지 않는다. 먼저 문제를 정의하고, 데이터를 나누고, 단순한 기준 모델을 만든 뒤, 성능과 오류를 확인한다.
핵심 개념 설명
선형 회귀: 직선으로 값을 예측하기
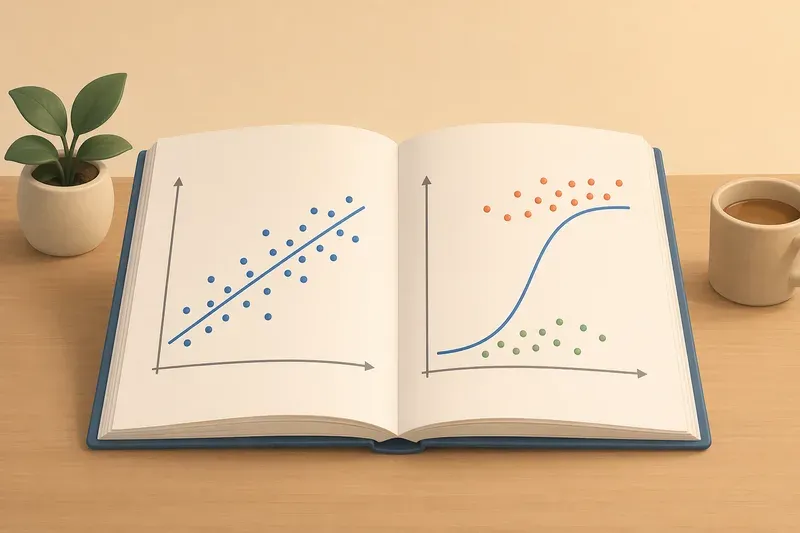
선형 회귀는 입력값과 정답 사이의 관계를 직선으로 설명하려는 모델이다. 입력 특징이 하나라면 그래프 위에 직선을 긋는다고 생각하면 된다.
예를 들어 공부 시간이 늘수록 시험 점수가 높아지는 데이터가 있다고 하자. 선형 회귀는 이 데이터 사이를 가장 잘 지나가는 직선을 찾는다. 그 직선을 이용해 새로운 학생의 공부 시간이 주어졌을 때 예상 점수를 계산한다.
직선은 보통 다음과 같은 형태로 표현한다.
예측값 = 기울기 × 입력값 + 절편여기서 기울기는 입력값이 1만큼 증가할 때 예측값이 얼마나 변하는지를 뜻한다. 절편은 입력값이 0일 때의 기준값이다.
특징이 여러 개라면 직선 대신 여러 방향을 가진 평면처럼 생각할 수 있다. 예를 들어 집값을 예측할 때 면적, 방 개수, 역과의 거리 같은 여러 특징을 함께 사용할 수 있다. 이때 모델은 각 특징에 가중치를 붙인다. 가중치가 크다는 것은 그 특징이 예측에 더 크게 영향을 준다는 뜻이다.
회귀 예측의 오차: MAE와 MSE
회귀 모델은 숫자를 예측한다. 그래서 예측이 얼마나 빗나갔는지 계산할 수 있다.
평균절대오차, MAE는 예측값과 실제값의 차이를 절댓값으로 바꾼 뒤 평균낸 값이다.
실제값 100, 예측값 90 → 오차 10
실제값 100, 예측값 130 → 오차 30
MAE는 "평균적으로 얼마나 틀렸는가"를 직관적으로 보여준다.
평균제곱오차, MSE는 오차를 제곱한 뒤 평균낸 값이다. 큰 오차를 더 강하게 벌준다. 예측이 조금씩 빗나가는 것보다 몇 개의 예측이 크게 틀리는 상황을 더 심각하게 본다.
MAE는 해석이 쉽고, MSE는 큰 실수에 민감하다. 둘 중 하나만 정답은 아니다. 문제 상황에 따라 선택해야 한다.
로지스틱 회귀: 확률로 분류하기
로지스틱 회귀는 이름은 회귀지만 분류 모델로 많이 쓴다. 핵심은 숫자를 그대로 예측하는 것이 아니라, 어떤 클래스에 속할 확률을 예측한다는 점이다.
예를 들어 이메일이 스팸일 확률이 0.82라고 해보자. 우리가 임계값을 0.5로 정했다면 0.82는 0.5보다 크므로 "스팸"으로 분류한다. 반대로 확률이 0.21이면 "스팸 아님"으로 분류한다.
예측 확률 ≥ 0.5 → 1번 클래스
예측 확률 < 0.5 → 0번 클래스
여기서 0.5 같은 기준을 임계값이라고 한다. 임계값은 항상 0.5일 필요는 없다. 사기 거래 탐지처럼 놓치면 위험한 문제에서는 더 낮은 임계값을 사용할 수도 있다.
로지스틱 회귀도 내부적으로는 특징들에 가중치를 붙인다. 그리고 데이터 공간에서 두 클래스를 나누는 선이나 면을 만든다. 이를 결정 경계라고 한다. 결정 경계 한쪽은 0번 클래스, 다른 쪽은 1번 클래스로 예측된다.
쉬운 비유 또는 사례
선형 회귀는 자를 대고 추세선을 긋는 것과 비슷하다. 점들이 완벽하게 한 줄에 있지는 않지만, 전체 흐름을 가장 잘 설명하는 선을 찾는다. 그 선을 따라 아직 보지 못한 값을 추정한다.
로지스틱 회귀는 출입 심사대와 비슷하다. 모델은 각 사람의 정보를 보고 "통과할 가능성"을 계산한다. 가능성이 기준보다 높으면 통과, 낮으면 보류로 판단한다. 중요한 것은 확률과 최종 결정이 다르다는 점이다. 확률은 0.7처럼 연속적인 값이고, 최종 분류는 통과 또는 보류처럼 딱 나뉜 결과다.
직접 해보는 실습
아래 실습은 scikit-learn에 포함된 데이터로 진행한다. 외부 파일이 없어도 실행할 수 있다.
1단계: 선형 회귀 실습
from sklearn.datasets import load_diabetes
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, mean_squared_error

# 데이터 불러오기
X, y = load_diabetes(return_X_y=True)

# 훈련 데이터와 테스트 데이터 나누기
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 모델 만들기와 학습
model = LinearRegression()
model.fit(X_train, y_train)

# 예측
pred = model.predict(X_test)

# 평가
mae = mean_absolute_error(y_test, pred)
mse = mean_squared_error(y_test, pred)

print("MAE:", mae)
print("MSE:", mse)
print("첫 5개 예측값:", pred[:5])
print("첫 5개 실제값:", y_test[:5])
결과를 볼 때는 숫자 하나만 보지 말고 예측값과 실제값을 함께 비교하자. MAE가 40이라면 평균적으로 실제값에서 약 40 정도 벗어났다는 뜻이다. MSE는 제곱 단위라 값이 더 크게 보일 수 있다.
모델의 가중치도 확인할 수 있다.
print("가중치:", model.coef_)
print("절편:", model.intercept_)
가중치는 각 특징이 예측에 미치는 방향과 크기를 나타낸다. 단, 특징들의 단위가 다르면 가중치 크기를 단순 비교하면 안 된다.
2단계: 로지스틱 회귀 실습
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix

# 데이터 불러오기
X, y = load_breast_cancer(return_X_y=True)

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 스케일 맞추기
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 모델 학습
clf = LogisticRegression(max_iter=1000)
clf.fit(X_train_scaled, y_train)

# 예측
pred = clf.predict(X_test_scaled)
proba = clf.predict_proba(X_test_scaled)

print("정확도:", accuracy_score(y_test, pred))
print("혼동 행렬:n", confusion_matrix(y_test, pred))
print("첫 5개 예측 확률:n", proba[:5])predict()는 최종 클래스를 출력한다. predict_proba()는 각 클래스에 속할 확률을 출력한다. 분류 문제에서는 최종 정답만 보지 말고 확률도 함께 확인하는 습관이 필요하다.
흔한 실수와 오류 분석
1. 같은 데이터로 학습하고 평가하기
훈련 데이터로 학습한 뒤 같은 데이터로 성능을 재면 모델이 새 데이터에서도 잘할지 알 수 없다. 지난 장에서 배운 것처럼 훈련 데이터와 테스트 데이터를 나누어야 한다.
2. 스케일 차이를 무시하기
어떤 특징은 0에서 1 사이이고, 어떤 특징은 수천 단위일 수 있다. 이런 차이는 특히 로지스틱 회귀 같은 선형 모델의 학습에 영향을 줄 수 있다. 그래서 StandardScaler처럼 평균을 0, 표준편차를 1에 가깝게 맞추는 전처리를 자주 사용한다.
3. 이상치에 끌려가는 선형 회귀
이상치는 다른 값들과 크게 동떨어진 데이터다. 선형 회귀는 전체 오차를 줄이려 하기 때문에 몇 개의 이상치에 직선이 크게 흔들릴 수 있다. 예측이 이상하게 나온다면 산점도나 오차가 큰 샘플을 확인해야 한다.
4. 다중공선성을 해석하지 못하기
다중공선성은 특징들끼리 서로 너무 비슷한 정보를 담고 있는 상태를 말한다. 예를 들어 "집의 면적"과 "방의 개수"가 매우 강하게 함께 움직일 수 있다. 이런 경우 모델의 예측 성능은 괜찮아도 각 가중치를 해석하기 어려워질 수 있다.
초보 단계에서는 이렇게 기억하면 충분하다. 선형 모델의 가중치는 유용한 해석 도구지만, 데이터의 스케일과 특징 간 관계를 확인하지 않고 바로 결론을 내리면 위험하다.
5. 정확도만 보고 분류 모델을 판단하기
로지스틱 회귀 실습에서 정확도를 계산했지만, 정확도만으로 충분하지 않은 경우가 많다. 특히 클래스 비율이 불균형하면 문제가 된다. 예를 들어 정상 거래가 99%, 사기 거래가 1%인 데이터에서 모든 거래를 정상이라고 예측해도 정확도는 99%다. 하지만 사기 거래를 하나도 잡지 못하므로 좋은 모델이 아니다.
이 문제는 다음 장에서 더 자세히 다룬다.
요약
선형 회귀는 숫자를 예측하는 회귀 모델이다. 입력과 정답 사이의 관계를 직선 또는 평면으로 설명한다. 기울기와 절편은 모델이 찾은 예측 규칙이다.
회귀 모델은 MAE와 MSE 같은 지표로 평가할 수 있다. MAE는 평균적인 오차 크기를 직관적으로 보여주고, MSE는 큰 오차를 더 강하게 반영한다.
로지스틱 회귀는 분류 모델이다. 각 클래스에 속할 확률을 계산하고, 임계값을 기준으로 최종 클래스를 정한다. 결정 경계는 모델이 클래스를 나누는 기준선이다.
두 모델은 단순하지만 매우 중요하다. 복잡한 모델을 쓰기 전에 기준 모델로 삼기 좋고, 결과를 해석하기도 쉽다.
퀴즈
선형 회귀는 주로 어떤 종류의 문제에 사용하는가?
기울기가 크다는 것은 입력값 변화가 예측값에 어떤 영향을 준다는 뜻인가?
MAE와 MSE의 차이를 설명해보자.
로지스틱 회귀가 분류에 사용되는 이유는 무엇인가?
임계값을 0.5에서 0.3으로 낮추면 어떤 변화가 생길 수 있는가?
선형 모델에서 스케일 조정이 필요한 이유는 무엇인가?
다중공선성이 있으면 모델 해석에 어떤 문제가 생길 수 있는가?
체크리스트
선형 회귀가 값을 예측하는 방식이라고 설명할 수 있다.
기울기와 절편의 의미를 그래프 관점에서 이해했다.
MAE와 MSE가 각각 어떤 오차를 나타내는지 구분할 수 있다.
로지스틱 회귀가 확률과 임계값으로 분류한다는 것을 이해했다.
LinearRegression으로 회귀 모델을 학습하고 평가할 수 있다.LogisticRegression으로 분류 모델을 학습하고 예측 확률을 확인할 수 있다.스케일, 이상치, 다중공선성이 선형 모델에 영향을 줄 수 있음을 안다.
다음 장 연결
이번 장에서는 모델을 만들고 간단한 지표로 평가했다. 하지만 실제 문제에서는 "성능이 좋다"는 말을 더 조심해서 써야 한다. 회귀와 분류는 서로 다른 평가 기준이 필요하고, 데이터가 어떻게 나뉘었는지에 따라 결과도 달라진다.
다음 장에서는 정확도, 정밀도, 재현율, F1 점수 같은 분류 지표와 교차검증을 배운다. 모델 하나의 점수만 보는 단계에서 벗어나, 더 믿을 수 있는 평가 방법으로 넘어간다.
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.