


본문만 저장하면 부족하다
RAG에서 검색되는 것은 보통 문서 전체가 아니라 작은 청크입니다. 그런데 청크 본문만 저장하면 문제가 생깁니다. 이 문장이 어느 문서에서 왔는지, 누가 썼는지, 최신 내용인지, 사용자가 볼 수 있는 자료인지 알 수 없습니다.
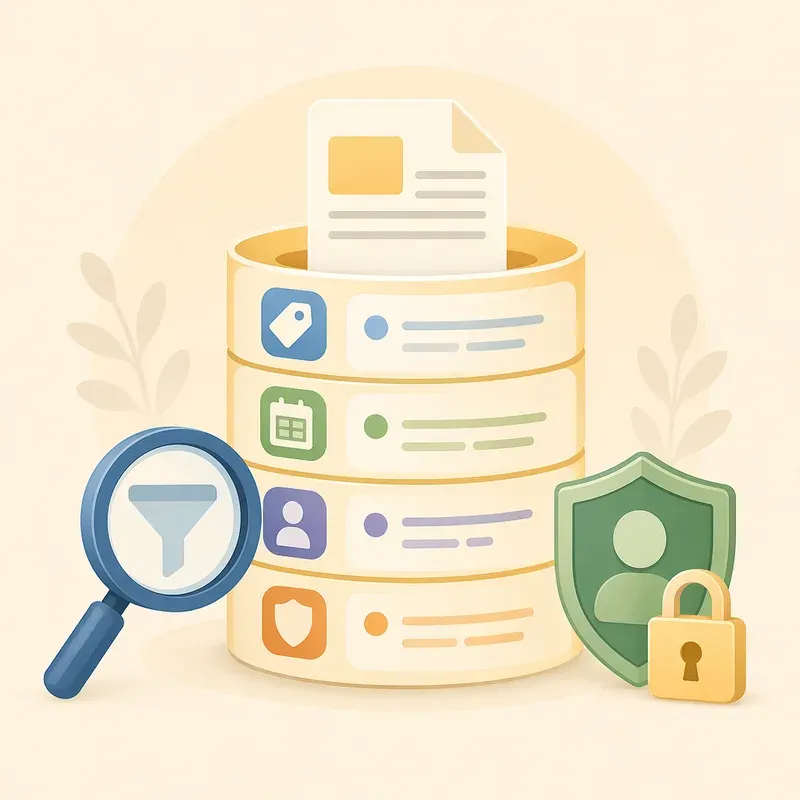
메타데이터는 이 문제를 해결하는 문서의 맥락 정보입니다. 본문이 "무엇을 말하는가"라면, 메타데이터는 "어디에서 온 내용인가", "어떤 조건에서 보여줘도 되는가"를 알려줍니다. 좋은 RAG 시스템은 본문과 메타데이터를 함께 저장합니다.
기본 메타데이터
가장 먼저 저장할 정보는 문서의 기본 속성입니다. 제목, 저자, 작성일, 수정일, 카테고리, 태그, 문서 유형 같은 값입니다.
예를 들어 사용자가 "최근에 쓴 RAG 관련 노트만 찾아줘"라고 묻는다면 본문 검색만으로는 부족합니다. created_at, updated_at, tags 같은 값이 있어야 검색 범위를 좁힐 수 있습니다.
문서 제목은 답변의 출처 표시에 쓰입니다. 저자는 특정 작성자의 문서만 찾을 때 필요합니다. 날짜는 최신성을 판단하는 데 중요합니다. 카테고리와 태그는 검색 결과를 주제별로 정리하는 데 도움을 줍니다.
기본 메타데이터의 예는 다음과 같습니다.
{
  "document_id": "book-rag-001",
  "title": "처음 만나는 RAG와 AI 지식베이스",
  "author": "홍길동",
  "document_type": "book",
  "category": "AI",
  "tags": ["RAG", "LLM", "검색"],
  "created_at": "2026-05-01",
  "updated_at": "2026-05-10"
}
긴 문서의 위치 정보 보존하기
책, 매뉴얼, 논문처럼 긴 문서는 위치 정보가 중요합니다. 사용자는 단순히 답만 원하는 것이 아니라, 그 답이 어디에 근거하는지도 알고 싶어 합니다.
따라서 청크마다 챕터, 섹션, 페이지, 문단 번호를 함께 저장하는 것이 좋습니다. 이렇게 하면 답변 아래에 "임베딩과 벡터 검색 > 벡터 유사도 계산하기", "45쪽", "문단 7"처럼 출처를 표시할 수 있습니다. 독자에게 보이는 출처는 가능하면 번호만 나열하기보다 제목과 위치를 함께 보여주는 편이 이해하기 쉽습니다.
예를 들어 책 한 권을 청킹할 때는 다음 정보를 붙일 수 있습니다.
{
  "chunk_id": "book-rag-001-chunk-032",
  "document_id": "book-rag-001",
  "chapter_index": 5,
  "chapter_title": "메타데이터 설계",
  "section_title": "긴 문서의 위치 정보 보존하기",
  "page": 42,
  "paragraph_index": 3
}
이 정보는 검색 정확도에도 영향을 줍니다. 사용자가 "메타데이터 설계에서 말한 권한 설계가 뭐야?"라고 물으면, chapter_title이나 section_title을 이용해 해당 범위 안에서 먼저 찾을 수 있습니다.
권한 정보도 메타데이터다
개인 노트 앱이나 조직 지식베이스에서는 보안이 매우 중요합니다. 검색 결과에 사용자가 볼 수 없는 문서가 섞이면 안 됩니다. RAG는 답변을 만들기 전에 검색을 하므로, 권한 필터링은 검색 단계에서 먼저 적용해야 합니다.
이를 위해 사용자 ID, 팀 ID, 공개 범위, 접근 권한을 메타데이터에 포함합니다.
{
  "owner_user_id": "user_123",
  "team_id": "team_ai",
  "visibility": "team",
  "allowed_user_ids": ["user_123", "user_456"],
  "allowed_roles": ["admin", "editor"]
}
개인 문서는 소유자만 검색할 수 있어야 합니다. 팀 문서는 같은 팀 구성원에게만 보여야 합니다. 공개 문서는 모든 사용자가 검색할 수 있습니다. 이 규칙이 명확해야 AI가 실수로 내부 문서를 답변에 포함하는 일을 줄일 수 있습니다.
검색 필터링 구조 만들기
메타데이터는 검색 결과를 좁히는 필터로 쓰입니다. 벡터 검색은 의미가 가까운 청크를 찾는 데 강하지만, "어떤 범위 안에서 찾을지"는 메타데이터가 정합니다.
예를 들어 다음과 같은 조건을 만들 수 있습니다.
저자가
홍길동인 문서만 검색2026-01-01이후 수정된 문서만 검색카테고리가
AI인 문서만 검색문서 유형이
book인 자료만 검색현재 사용자가 접근 가능한 문서만 검색
실제 검색 흐름은 보통 이렇게 구성합니다.
사용자의 질문을 임베딩한다.
권한 조건과 날짜, 카테고리 같은 필터를 만든다.
필터를 만족하는 청크 안에서 벡터 검색을 수행한다.
검색된 청크의 본문과 메타데이터를 함께 프롬프트에 넣는다.
답변에 문서 제목, 챕터 제목, 섹션 제목, 페이지를 출처로 표시한다.
이 구조를 사용하면 답변 품질뿐 아니라 신뢰도도 함께 올라갑니다.
실습: 책 기반 메타데이터 스키마
책 한 권을 지식베이스로 만든다고 가정해 봅시다. 청크 본문과 메타데이터를 함께 저장하는 최소 구조는 다음과 같습니다.
{
  "id": "chunk_001",
  "text": "RAG에서 메타데이터는 검색 범위와 출처 표시를 결정한다.",
  "metadata": {
    "document_id": "book_001",
    "title": "처음 만나는 RAG와 AI 지식베이스",
    "author": "홍길동",
    "document_type": "book",
    "category": "AI",
    "tags": ["RAG", "메타데이터"],
    "chapter_index": 5,
    "chapter_title": "메타데이터 설계",
    "section_title": "실습: 책 기반 메타데이터 스키마",
    "page": 51,
    "paragraph_index": 1,
    "visibility": "private",
    "owner_user_id": "user_123",
    "created_at": "2026-05-01",
    "updated_at": "2026-05-15"
  }
}
처음부터 모든 값을 완벽하게 넣을 필요는 없습니다. 하지만 문서 제목, 위치 정보, 권한 정보는 초기에 설계하는 것이 좋습니다. 나중에 추가하려면 이미 저장된 모든 청크를 다시 처리해야 할 수 있기 때문입니다.
메타데이터는 RAG의 보이지 않는 뼈대입니다. 잘 설계된 메타데이터는 검색을 좁히고, 출처를 분명히 하며, 사용자가 볼 수 있는 정보만 안전하게 답변에 사용하도록 도와줍니다.
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.