


왜 스트리밍이 필요한가
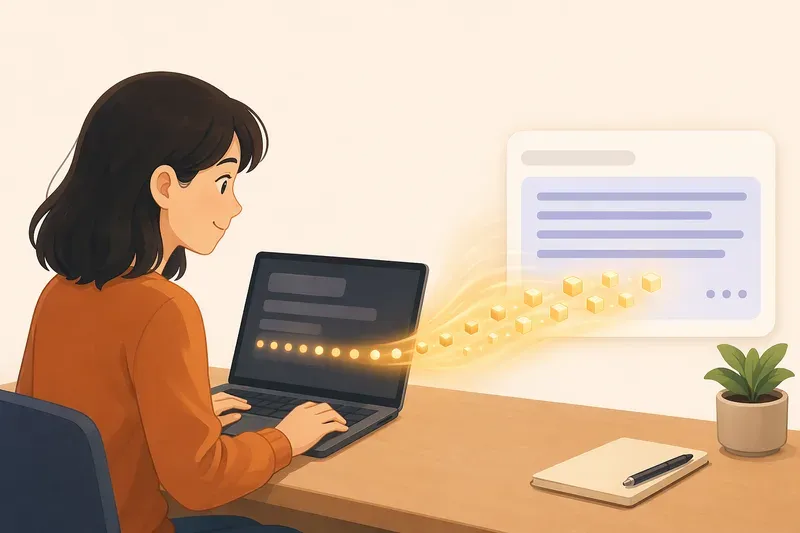
긴 글 생성, 문서 요약, 코드 작성 기능은 응답이 끝날 때까지 몇 초 이상 걸릴 수 있습니다. 이때 화면이 비어 있으면 사용자는 멈춘 것으로 느낍니다. 스트리밍은 최종 답변을 한 번에 보여 주지 않고, 생성되는 텍스트 조각을 즉시 화면에 붙이는 방식입니다. 전체 생성 시간이 크게 줄어드는 것은 아니지만, 첫 문장이 빨리 보이기 때문에 체감 대기 시간이 줄어듭니다.
다만 스트리밍은 비용 절감 기능이 아닙니다. 모델이 같은 양의 토큰을 생성하면 비용은 거의 같습니다. 스트리밍의 목적은 UX 개선입니다. 비용을 줄이려면 최대 출력 길이, 중단 버튼, 짧은 미리보기 생성 같은 별도 설계가 필요합니다.
 AI 생성 이미지
서버는 스트림을 중계한다
Next.js App Router의 Route Handler는 app/api/.../route.ts에서 POST 같은 HTTP 메서드를 처리하며, 표준 Web Request와 Response API를 사용할 수 있습니다.1 그래서 서버는 브라우저 요청을 받은 뒤 OpenAI API를 호출하고, 모델이 보내는 조각을 다시 브라우저가 읽을 수 있는 HTTP 스트림으로 전달할 수 있습니다.
기본 구조는 다음과 같습니다.
// app/api/write/route.ts
export async function POST(req: Request) {
  const { topic } = await req.json();

  const stream = await openai.chat.completions.create({
    model: 'gpt-4.1-mini',
    messages: [{ role: 'user', content: `${topic}에 대한 글을 써 줘.` }],
    stream: true,
  });

  const encoder = new TextEncoder();

  return new Response(
    new ReadableStream({
      async start(controller) {
        for await (const chunk of stream) {
          const text = chunk.choices[0]?.delta?.content ?? '';
          if (text) controller.enqueue(encoder.encode(text));
        }
        controller.close();
      },
    }),
    { headers: { 'Content-Type': 'text/plain; charset=utf-8' } },
  );
}
여기서 중요한 부분은 stream: true입니다. 모델 응답은 완성된 문자열 하나가 아니라 여러 이벤트로 도착합니다. 서버는 각 이벤트에서 choices[0].delta.content 같은 증분 텍스트를 꺼내 일반 텍스트 청크로 바꿔 보냅니다.2
Node.js 스트림으로 바꾸는 방식
환경에 따라 OpenAI 스트림을 Node.js 스트림으로 변환해 다룰 수도 있습니다. 예를 들어 Readable.from(response)로 OpenAI 응답을 읽고, Transform 스트림에서 객체 청크를 문자열 청크로 바꿉니다. 이때 OpenAI 청크는 일반 문자열이 아니라 객체이므로 objectMode: true가 필요합니다.2
핵심은 형식 변환입니다. 모델 전용 스트림은 화면이 바로 이해할 수 없습니다. 서버가 중간에서 "모델 이벤트 → 텍스트 조각 → HTTP 스트림"으로 바꿔 주어야 합니다.
AI SDK를 쓰는 더 짧은 방법
직접 ReadableStream을 만들 수도 있지만, AI SDK를 쓰면 App Router에서 더 간단하게 스트리밍을 구현할 수 있습니다. 서버에서는 streamText()를 호출하고 toUIMessageStreamResponse()를 반환합니다.3
// app/api/chat/route.ts
export async function POST(req: Request) {
  const { messages } = await req.json();
  const result = streamText({ model, messages });
  return result.toUIMessageStreamResponse();
}
클라이언트에서는 useChat 같은 훅이 메시지를 누적해 주므로, 화면은 messages를 렌더링하기만 해도 답변이 실시간으로 나타납니다.3 챗봇처럼 대화 기록이 필요한 기능에는 이 방식이 편합니다. 반대로 글 생성기처럼 단일 결과 문자열만 필요한 기능은 직접 fetch와 ReadableStream을 읽는 방식이 단순할 수 있습니다.
클라이언트에서 청크 누적하기
브라우저에서는 fetch 응답의 body.getReader()로 스트림을 읽습니다. 받은 값은 바이트이므로 TextDecoder로 문자열로 바꾼 뒤 기존 결과에 이어 붙입니다.
const res = await fetch('/api/write', { method: 'POST', body: JSON.stringify({ topic }) });
const reader = res.body!.getReader();
const decoder = new TextDecoder();

while (true) {
  const { done, value } = await reader.read();
  if (done) break;
  setText((prev) => prev + decoder.decode(value));
}
여기에 생성 중 상태, 깜박이는 커서, 자동 스크롤, 완료 처리, 오류 메시지를 함께 붙이면 사용자는 응답이 진행 중임을 분명히 느낍니다. 스트리밍 UI에서 중요한 것은 "빠르게 끝나는 것"보다 "멈추지 않았다는 신호를 계속 주는 것"입니다.
중단과 비용 관리
스트리밍을 시작하면 사용자가 끝까지 읽지 않아도 토큰이 계속 생성될 수 있습니다. 따라서 중단 버튼을 두고 AbortController로 요청을 끊어야 합니다. 또한 max_tokens 또는 max_output_tokens로 출력 길이를 제한하고, 재생성 버튼은 같은 요청을 무제한 반복하지 않도록 처리합니다.
긴 본문을 바로 생성하기보다 먼저 개요나 미리보기를 짧게 만들고, 사용자가 선택한 뒤 본문을 이어 쓰게 하면 비용과 실패 가능성을 줄일 수 있습니다. 스트리밍은 좋은 AI 서비스의 핵심 인터랙션이지만, 반드시 입력 검증, 출력 길이 제한, 중단 처리와 함께 설계해야 합니다.
참고
1File-system conventions: route.js | Next.js
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.