


성능은 하나의 숫자로 정해지지 않는다
컴퓨터를 살 때 흔히 클럭 속도, 코어 수, 메모리 용량, SSD 종류를 본다. 모두 중요한 정보다. 그러나 성능은 어느 한 부품의 숫자로 결정되지 않는다. 빠른 컴퓨터란 모든 부품이 항상 빠르다는 뜻이 아니라, 사용자가 하는 작업에서 가장 느린 지점이 충분히 빠르다는 뜻에 가깝다.
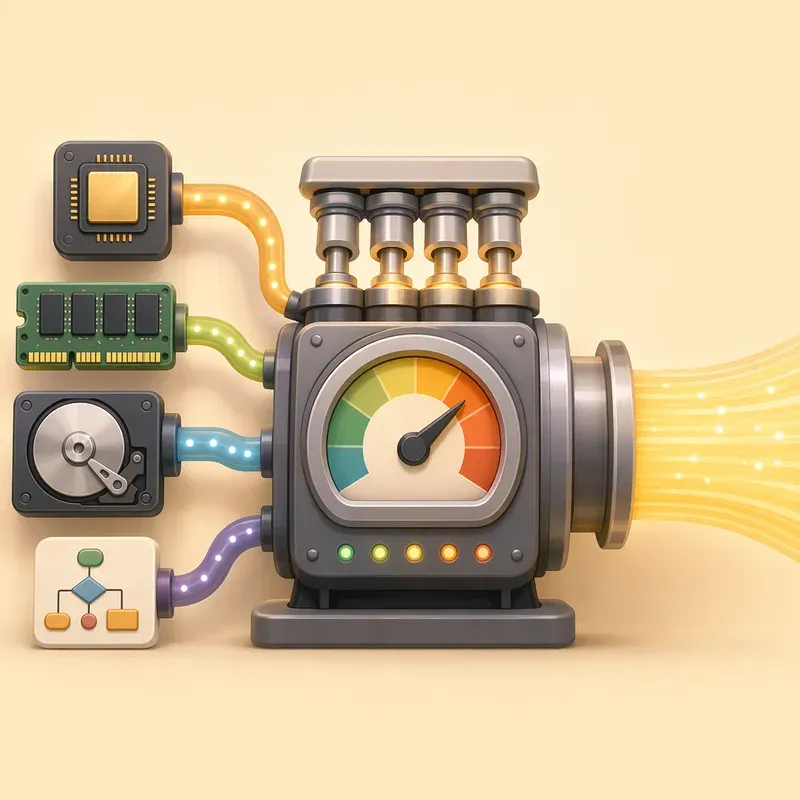
이 가장 느린 지점을 병목이라고 한다. 병의 목이 좁으면 안에 물이 많아도 한 번에 조금씩밖에 나오지 않는다. 컴퓨터도 같다. CPU가 아무리 빨라도 메모리에서 데이터를 늦게 가져오면 기다려야 한다. SSD가 빠르더라도 프로그램이 비효율적으로 만들어졌다면 전체 작업은 느릴 수 있다.
CPU 성능: 클럭, 코어, 캐시
CPU 성능을 볼 때 가장 먼저 떠올리는 것은 클럭 속도다. 클럭은 CPU가 일을 진행하는 박자다. 보통 클럭이 높으면 같은 시간에 더 많은 단계를 진행할 수 있다. 하지만 클럭만 높다고 항상 빠른 것은 아니다. 한 박자에 얼마나 많은 일을 처리하는지도 중요하다.
코어 수는 동시에 일을 맡을 수 있는 작업자의 수에 비유할 수 있다. 코어가 많으면 여러 프로그램을 동시에 실행하거나, 하나의 작업을 여러 부분으로 나누어 처리할 때 유리하다. 영상 인코딩, 3D 렌더링, 대규모 계산처럼 나누기 쉬운 작업은 코어 수의 도움을 크게 받는다.
캐시는 CPU 가까이에 있는 작고 빠른 메모리다. CPU가 자주 쓰는 데이터를 캐시에 두면 멀리 있는 RAM까지 가지 않아도 된다. 캐시가 크고 잘 맞으면 CPU는 쉬지 않고 계산할 가능성이 커진다. 반대로 필요한 데이터가 캐시에 없으면, CPU는 다음 데이터를 기다리며 멈춘다.
빠른 CPU도 메모리를 기다린다
CPU 내부 계산은 매우 빠르지만 RAM 접근은 상대적으로 느리다. 이 차이 때문에 현대 컴퓨터에서는 "계산하는 시간"보다 "데이터를 기다리는 시간"이 더 문제가 되는 경우가 많다.
CPU가 필요한 데이터를 캐시에서 찾지 못하는 일을 캐시 미스라고 한다. 캐시 미스가 나면 CPU는 더 느린 단계인 RAM에서 데이터를 가져와야 한다. 이때 CPU는 할 일이 있어도 재료가 없어서 기다리는 상태가 된다.
그래서 프로그램이 데이터를 어떤 순서로 읽는지도 중요하다. 연속된 배열을 차례로 읽으면 캐시에 잘 들어맞는다. 반대로 여기저기 흩어진 데이터를 불규칙하게 따라가면 캐시 미스가 늘어난다. 같은 양의 계산을 해도 데이터 배치에 따라 속도가 크게 달라질 수 있다.
저장장치는 시작 속도와 파일 작업을 좌우한다
RAM보다 더 느린 곳은 저장장치다. 프로그램을 실행할 때 실행 파일과 필요한 데이터는 저장장치에서 RAM으로 올라온다. 운영체제 부팅, 프로그램 실행, 대용량 파일 열기 속도는 저장장치의 영향을 많이 받는다.
HDD는 회전하는 원판과 움직이는 헤드를 사용한다. 원하는 데이터를 읽으려면 물리적으로 위치를 찾아가야 하므로 작은 파일을 여러 곳에서 읽을 때 시간이 많이 걸린다. SSD는 반도체 메모리를 사용하므로 기계적으로 움직이는 시간이 없다. 그래서 무작위 접근에 강하고, 부팅이나 프로그램 실행에서 체감 차이가 크다.
다만 SSD를 쓴다고 모든 작업이 빨라지는 것은 아니다. 이미 필요한 데이터가 RAM에 올라와 있고 CPU 계산이 병목이라면 저장장치 속도는 큰 영향을 주지 않는다.
병렬 처리는 마법이 아니다
멀티코어 CPU는 여러 일을 동시에 처리할 수 있다. 그러나 모든 작업이 자동으로 코어 수만큼 빨라지지는 않는다. 어떤 일은 순서대로 해야 한다. 예를 들어 앞 단계의 결과가 있어야 다음 단계를 계산할 수 있다면, 여러 코어가 있어도 동시에 처리하기 어렵다.
또한 작업을 나누는 데에도 비용이 든다. 데이터를 나누고, 각 코어가 계산한 결과를 다시 합치고, 동시에 같은 데이터를 고치지 않도록 조정해야 한다. 이 조정 비용이 커지면 코어를 많이 써도 기대만큼 빨라지지 않는다.
그래서 병렬 처리는 "나눌 수 있는 작업"에서 강하다. 사진 여러 장을 각각 변환하거나, 큰 데이터를 여러 조각으로 나누어 분석하는 일은 효과가 좋다. 반면 사용자의 입력을 기다리거나, 순서 의존성이 강한 작업은 코어 수보다 응답 구조와 대기 시간이 더 중요하다.
알고리즘은 하드웨어만큼 중요하다
성능을 말할 때 하드웨어만 보면 절반만 보는 것이다. 같은 컴퓨터에서도 어떤 알고리즘과 데이터 구조를 쓰느냐에 따라 속도는 크게 달라진다.
예를 들어 100만 개의 항목에서 원하는 값을 찾는다고 하자. 처음부터 끝까지 하나씩 비교하면 최악의 경우 100만 번을 확인해야 한다. 하지만 정렬된 데이터에서 이진 탐색을 쓰면 확인 횟수가 크게 줄어든다. 해시 테이블 같은 자료구조를 쓰면 특정 조건에서는 거의 바로 찾을 수도 있다.
비효율적인 프로그램은 빠른 CPU를 낭비한다. 불필요한 반복, 과도한 파일 읽기, 캐시에 맞지 않는 데이터 배치, 너무 많은 메모리 할당은 모두 성능을 떨어뜨린다. 반대로 좋은 알고리즘은 낮은 사양의 컴퓨터에서도 놀라울 만큼 빠른 결과를 낼 수 있다.
성능을 이해하는 핵심은 병목 찾기다
컴퓨터 성능을 제대로 이해하려면 "무엇이 가장 빠른가"보다 "무엇이 가장 오래 걸리는가"를 봐야 한다. 계산이 많으면 CPU가 병목일 수 있다. 데이터 접근이 불규칙하면 캐시와 메모리가 문제일 수 있다. 파일을 자주 읽고 쓰면 저장장치가 중요하다. 동시에 처리할 수 있는 구조라면 코어 수가 힘을 발휘한다. 알고리즘이 나쁘면 어떤 부품을 바꿔도 한계가 있다.
빠른 컴퓨터는 좋은 부품의 단순한 합이 아니다. 작업의 성격, 데이터의 흐름, 프로그램의 구조, 하드웨어의 균형이 맞을 때 성능이 나온다. 성능을 보는 눈은 결국 병목을 찾는 눈이다.
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.