


바운딩 박스만으로는 부족하다
객체 검출은 로봇 비전의 중요한 출발점이다. 이미지 안에서 컵, 병, 상자 같은 물체를 찾고, 그 위치를 바운딩 박스로 알려 준다. 하지만 로봇이 물체를 실제로 집으려면 "어디쯤 있다"만으로는 부족하다.
예를 들어 테이블 위에 컵, 노트북, 케이블이 가까이 놓여 있다고 하자. 객체 검출 모델은 컵을 감싸는 사각형을 반환한다. 이 사각형 안에는 컵만 들어 있지 않다. 컵 주변의 배경, 그림자, 노트북 일부, 케이블 일부가 함께 포함될 수 있다. 로봇이 이 사각형 중심만 보고 그리퍼를 내리면 컵의 손잡이를 누르거나, 옆 물체와 충돌하거나, 빈 공간을 잡을 수 있다.
상자처럼 단순하고 고립된 물체라면 바운딩 박스 중심으로도 어느 정도 동작할 수 있다. 그러나 복잡한 배경, 겹친 물체, 투명하거나 반사되는 물체, 불규칙한 형태의 물체가 등장하면 문제가 커진다. 조작 작업에서는 물체의 대략적 위치가 아니라 "이 픽셀들이 바로 집어야 할 물체의 영역이다"라는 정보가 필요하다.
세그멘테이션은 이 문제를 해결하기 위해 사용된다. 바운딩 박스가 사각형으로 물체를 감싸는 방식이라면, 세그멘테이션은 이미지의 픽셀마다 물체인지 배경인지, 또는 어떤 물체에 속하는지를 구분한다. 로봇 조작에서는 이 차이가 매우 크다. 픽셀 단위 마스크를 얻으면 로봇은 목표 물체에 해당하는 깊이값만 골라 3D 위치를 계산하고, 그 물체 표면 위에서 집기 후보를 만들 수 있다.1
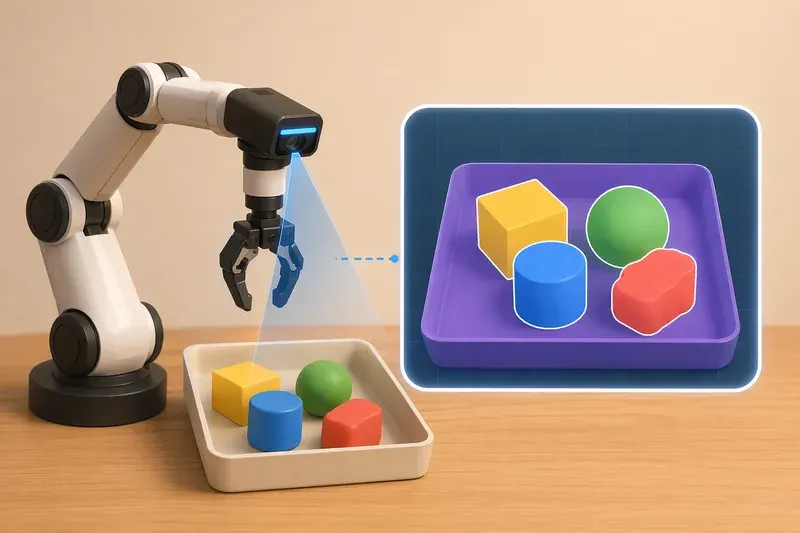 AI 생성 이미지
세그멘테이션의 세 가지 관점
세그멘테이션은 크게 semantic segmentation, instance segmentation, panoptic segmentation으로 나눌 수 있다. 이 책에서는 로봇 조작에 필요한 핵심만 이해하면 된다.
Semantic segmentation은 각 픽셀을 클래스 단위로 분류한다. 예를 들어 이미지 속 모든 컵 픽셀은 cup, 모든 테이블 픽셀은 table, 모든 사람 픽셀은 person으로 표시한다. 장면 전체를 이해하는 데 유용하다. 바닥, 벽, 책상, 사람처럼 영역의 의미를 파악해야 하는 이동 로봇에도 도움이 된다.
하지만 semantic segmentation만으로는 같은 종류의 여러 물체를 구분하기 어렵다. 테이블 위에 컵이 세 개 있다면, 세 컵의 픽셀이 모두 cup으로 묶일 수 있다. 사용자가 "왼쪽 컵을 집어 줘"라고 했을 때 로봇은 세 컵 중 어느 픽셀이 어느 컵에 속하는지 알아야 한다.
이때 필요한 것이 instance segmentation이다. Instance segmentation은 같은 클래스의 물체라도 개별 인스턴스로 나눈다. 컵 A의 마스크, 컵 B의 마스크, 컵 C의 마스크가 따로 나온다. 로봇 조작에서는 이 방식이 특히 중요하다. 로봇은 "컵이라는 영역 전체"를 집는 것이 아니라 "지금 선택된 특정 컵 하나"를 집어야 하기 때문이다.
Panoptic segmentation은 장면 전체의 배경 영역과 개별 객체를 함께 다루는 방식이다. 로봇이 작업대 전체 구조를 이해하거나, 이동 로봇이 바닥과 장애물을 함께 해석해야 할 때 유용하다. 그러나 로봇팔이 특정 물체 하나를 집는 문제에서는 instance segmentation이 가장 직접적으로 쓰인다.
마스크는 로봇에게 무엇을 알려 주는가
세그멘테이션 모델의 출력은 보통 마스크다. 마스크는 원본 이미지와 같은 크기의 2D 배열이다. 목표 물체에 해당하는 픽셀은 1 또는 255, 나머지 배경은 0으로 표시한다. 여러 물체가 있으면 물체마다 별도 마스크를 만들 수 있다.
마스크가 있으면 로봇은 여러 가지 정보를 계산할 수 있다.
첫째, 배경을 제거할 수 있다. 바운딩 박스 안에는 목표 물체가 아닌 픽셀도 많이 포함된다. 마스크를 적용하면 목표 물체에 해당하는 픽셀만 남길 수 있다. RGB-D 카메라를 사용한다면 해당 픽셀들의 깊이값만 골라 물체의 3D 점군을 만들 수 있다. 이렇게 하면 주변 물체나 테이블의 깊이값이 섞이는 문제를 줄일 수 있다.
둘째, 중심점을 더 안정적으로 구할 수 있다. 바운딩 박스 중심은 사각형의 중심일 뿐이다. 물체가 기울어져 있거나, 손잡이가 튀어나와 있거나, 일부가 가려져 있으면 실제 잡기 좋은 위치와 다를 수 있다. 마스크의 픽셀 분포를 이용하면 물체 영역의 무게중심, 가장 큰 내부 영역, 경계에서 떨어진 안전한 지점을 계산할 수 있다.
셋째, 윤곽과 방향을 추정할 수 있다. 마스크에서 윤곽선을 추출하면 물체의 긴 축과 짧은 축을 대략적으로 알 수 있다. 예를 들어 길쭉한 상자는 긴 방향과 수직이 되도록 그리퍼를 정렬해야 안정적으로 잡을 수 있다. 마스크 기반 최소 회전 사각형이나 주성분 방향을 사용하면 물체가 이미지 안에서 어느 방향으로 놓였는지 추정할 수 있다.
넷째, 잡기 어려운 영역을 피할 수 있다. 마스크의 가장자리는 깊이값이 불안정하거나 배경과 섞이기 쉽다. 로봇은 가장자리 바로 위가 아니라 마스크 내부의 충분히 넓고 안정적인 영역을 후보로 삼는 것이 좋다. 특히 흡착 그리퍼는 평평한 표면이 필요하므로, 마스크 내부에서 깊이 변화가 작고 주변이 비어 있는 영역을 찾는 과정이 중요하다.
2D 마스크를 3D 집기 후보로 바꾸기
세그멘테이션은 2D 이미지에서 끝나지 않는다. 로봇팔은 3D 공간에서 움직인다. 따라서 마스크는 깊이 이미지, 카메라 내부 파라미터, 카메라-로봇 좌표 변환과 연결되어야 한다.
기본 흐름은 다음과 같다.
RGB 이미지에서 목표 물체의 마스크를 얻는다.
같은 픽셀 위치의 깊이값을 읽는다.
유효한 깊이값만 골라 카메라 좌표계의 3D 점으로 변환한다.
마스크에 해당하는 점들만 모아 목표 물체의 포인트 클라우드를 만든다.
포인트 클라우드에서 중심, 표면 높이, 방향, 평평한 영역을 계산한다.
카메라 좌표의 후보점을 로봇 베이스 좌표로 변환한다.
로봇팔의 접근 자세와 그리퍼 방향을 만든다.
중요한 점은 마스크의 중심이 곧바로 집기점은 아니라는 것이다. 마스크 중심은 물체 대표 위치일 뿐이다. 실제 집기점은 그리퍼 종류, 물체 형태, 접근 방향, 장애물, 깊이 안정성에 따라 달라진다.
예를 들어 평평한 상자를 위에서 집는다면 마스크 중심 근처가 좋은 후보가 될 수 있다. 그러나 컵은 다르다. 위에서 누르면 컵 안으로 그리퍼가 들어가거나 미끄러질 수 있다. 컵의 옆면을 잡아야 한다면 마스크의 좌우 경계, 물체 높이, 그리퍼 폭을 함께 고려해야 한다.
또한 마스크가 정확해도 깊이값이 나쁘면 집기점은 틀릴 수 있다. 투명한 컵, 반짝이는 금속 물체, 검은색 고무 물체는 깊이 카메라가 안정적인 값을 주지 못할 수 있다. 따라서 마스크 기반 후보는 항상 깊이 유효 비율, 깊이 분산, 주변 장애물, MoveIt2 계획 가능성 같은 후속 검증을 거쳐야 한다.
SAM 계열 모델을 로봇에 연결하기
최근에는 Segment Anything Model, 줄여서 SAM 계열 모델이 세그멘테이션 도구로 널리 사용된다. 핵심 아이디어는 간단하다. 모델에게 이미지와 함께 힌트를 주면, 그 힌트에 해당하는 물체 영역을 마스크로 반환한다.
힌트는 여러 형태가 될 수 있다. 사용자가 물체 위의 한 점을 찍을 수도 있고, 객체 검출 모델이 만든 바운딩 박스를 넣을 수도 있다. 텍스트 질의를 사용해 "red cup" 같은 표현으로 목표를 찾는 방식도 가능하다. 로봇 시스템에서는 대개 객체 검출과 SAM을 함께 쓴다. 먼저 YOLO 같은 검출 모델이 "컵이 이 근처에 있다"는 박스를 만들고, 그 박스를 SAM에 넣어 컵의 더 정확한 픽셀 마스크를 얻는 식이다.
실전 워크플로에서는 점 프롬프트와 텍스트 프롬프트의 성격도 구분해야 한다. 점 프롬프트는 사용자가 물체 내부의 정확한 점을 찍는 방식이므로 비교적 정밀한 마스크를 얻기 쉽다. 텍스트 프롬프트는 더 편하지만 결과가 거칠거나 여러 후보가 나올 수 있다. 일부 시스템에서는 먼저 텍스트로 대략적인 마스크를 만들고, 그 마스크의 중심점을 다시 점 프롬프트로 넣어 마스크를 정제하는 흐름을 사용한다.2
이 방식은 자연어 명령 로봇과 잘 맞는다. 사용자가 "빨간 컵을 집어 줘"라고 말하면 LLM은 대상이 red cup이라는 것을 파악한다. 비전 모듈은 이미지에서 컵 후보를 찾고, 색상 조건으로 빨간 컵을 고른 뒤, 해당 박스나 점을 세그멘테이션 모델에 넣어 정확한 마스크를 만든다. 이후 로봇은 그 마스크를 깊이 정보와 결합해 집기 후보를 계산한다.
마스크만으로는 아직 집을 수 없다
세그멘테이션은 집기 성능을 크게 높이지만, 마스크 자체가 로봇 행동은 아니다. 마스크는 "어느 픽셀이 목표 물체인가"를 알려 준다. 로봇이 실제로 필요한 것은 "그리퍼를 어디에, 어떤 각도로, 얼마나 벌리고 접근할 것인가"이다.
그래서 세그멘테이션은 grasp detection과 결합되어야 한다. Grasp detection은 이미지나 포인트 클라우드에서 집기 가능한 위치와 방향을 찾는 기술이다. 최신 연구에서는 마스크와 함께 집기 신뢰도, 그리퍼 각도, 그리퍼 폭 같은 grasp map을 예측하기도 한다. 예를 들어 GraspSAM 계열 접근은 프롬프트로 목표 물체를 선택하고, 물체 마스크와 함께 집기 신뢰도 맵, 그리퍼 회전 각도, 그리퍼 폭을 출력하는 구조를 제안한다.3
이런 결과는 로봇 조작에서 매우 유용하다. 픽셀마다 "여기를 잡으면 성공할 가능성이 높다"는 점수가 있고, 각 픽셀에 필요한 그리퍼 방향과 폭까지 있다면, 로봇은 마스크 내부에서 가장 좋은 후보를 선택할 수 있다. 이후 이 후보 픽셀을 깊이값으로 3D 좌표로 바꾸고, 로봇 좌표계로 변환한 뒤, MoveIt2 같은 경로 계획기에 전달하면 된다.
다만 이 과정에서도 안전 검사는 필요하다. grasp map의 점수가 높아도 실제 로봇팔이 그 자세에 도달하지 못할 수 있다. 주변 장애물 때문에 접근 경로가 막혀 있을 수도 있다. 그리퍼 폭이 물체 크기와 맞지 않거나, 물체가 너무 무겁거나, 잡는 순간 미끄러질 수도 있다. 따라서 좋은 로봇 시스템은 세그멘테이션, grasp detection, 좌표 변환, 경로 계획, 실행 후 검증을 하나의 폐루프로 연결한다.
실전 파이프라인 예시
세그멘테이션을 로봇팔 조작에 사용하는 기본 파이프라인은 다음처럼 구성할 수 있다.
camera image
  → object detection or user/text prompt
  → segmentation mask
  → mask filtering and selection
  → RGB-D depth fusion
  → 3D object points
  → grasp candidate generation
  → robot coordinate transform
  → motion planning
  → pick execution
  → success verification
처음에는 너무 복잡한 장면을 선택하지 않는 것이 좋다. 색이 뚜렷하고 형태가 단순한 블록이나 컵 하나로 시작한다. 먼저 마스크가 안정적으로 나오는지 확인한다. 그다음 마스크 중심에 시각화 마커를 찍고, 깊이값으로 계산한 3D 위치가 실제 물체 위에 놓이는지 RViz에서 확인한다. 그 뒤에야 로봇팔을 움직인다.
마스크 후처리도 중요하다. 세그멘테이션 모델의 출력에는 작은 구멍, 잘못 붙은 배경, 떨어진 잡음 영역이 포함될 수 있다. OpenCV의 모폴로지 연산으로 구멍을 메우고, 연결 요소 분석으로 가장 큰 영역만 남기고, 너무 작은 마스크는 버리는 식의 처리가 필요하다. 물체가 일부 가려진 경우에는 마스크가 실제보다 작아질 수 있으므로, 집기 후보를 만들 때 신뢰도를 낮게 주거나 재관찰을 요청하는 편이 안전하다.
최종적으로 로봇 에이전트에서는 세그멘테이션이 고수준 명령과 저수준 제어를 잇는 다리 역할을 한다. 언어 모델은 "빨간 컵"이라는 목표를 정하고, 객체 검출은 후보 위치를 찾고, 세그멘테이션은 실제 픽셀 영역을 분리한다. 그리고 깊이 추정과 좌표 변환은 그 영역을 로봇팔이 움직일 수 있는 3D 목표로 바꾼다. 실제 범용 pick-and-place 시스템에서도 언어와 비전으로 대상을 정한 뒤, 검출 박스를 SAM 기반 마스크로 정제하고, 이 마스크를 정책이나 조작 모듈의 입력으로 사용하는 흐름이 사용된다.4
실패를 줄이는 확인 질문
세그멘테이션을 사용할 때는 다음 질문을 항상 확인해야 한다.
마스크가 목표 물체 하나만 포함하는가?
배경이나 옆 물체가 마스크에 섞이지 않았는가?
마스크 영역의 깊이값이 충분히 유효한가?
마스크 중심이 실제 집기점으로 적절한가?
그리퍼가 접근할 공간이 있는가?
같은 종류의 물체가 여러 개라면 올바른 인스턴스를 골랐는가?
실행 후 물체가 실제로 함께 움직였는가?
이 질문들은 단순한 체크리스트가 아니다. 로봇이 실패를 줄이기 위한 폐루프의 일부다. 마스크가 불확실하면 다시 촬영한다. 여러 컵이 헷갈리면 사용자에게 확인한다. 깊이값이 불안정하면 다른 각도에서 본다. 집기 후보가 충돌한다면 다른 후보를 선택한다.
세그멘테이션의 목표는 예쁜 마스크 이미지를 만드는 것이 아니다. 로봇이 실제 물체를 더 안전하고 정확하게 집도록 돕는 것이다. 바운딩 박스가 로봇에게 "저 근처를 보라"고 말한다면, 세그멘테이션은 "이 영역이 바로 네가 다뤄야 할 물체다"라고 알려 준다. 그리고 다음 단계에서는 이 픽셀 영역을 깊이 정보와 결합해 실제 3D 위치로 바꾸게 된다.
참고
1Ch. 9 - Object Detection and Segmentation
2Image Segmentation using Machine Learning
3GraspSAM: When Segment Anything Model Meets Grasp Detection
4Pave the Way to Grasp Anything: Transferring Foundation Models for Universal Pick-Place Robots
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.