


Q-table이 작동하지 않는 순간
Q-learning은 꽤 매력적인 아이디어였다. 에이전트가 어떤 상태에서 어떤 행동을 했는지 기록하고, 그 행동이 장기적으로 얼마나 좋았는지를 Q(s, a)라는 값으로 조금씩 고쳐 나간다. 격자 세계처럼 상태와 행동의 수가 작을 때는 이 방식이 아주 잘 어울린다.
예를 들어 5×5 Grid World가 있다고 하자. 상태는 25개다. 행동이 위, 아래, 왼쪽, 오른쪽 네 가지라면 Q-table에는 25×4, 즉 100개의 값만 있으면 된다. 처음에는 전부 0으로 채워 두고, 에이전트가 움직일 때마다 값을 갱신하면 된다. 표를 들고 다니는 작은 탐험가를 상상하면 충분하다.
하지만 현실에 가까운 문제로 넘어가는 순간, 이 표는 갑자기 감당하기 어려워진다.
CartPole을 떠올려 보자. 막대가 넘어지지 않도록 카트를 왼쪽이나 오른쪽으로 움직이는 문제다. 얼핏 보면 단순해 보인다. 행동은 왼쪽, 오른쪽 두 가지뿐이다. 그런데 상태는 단순하지 않다. 카트의 위치, 카트의 속도, 막대의 각도, 막대 끝의 속도 같은 연속적인 값들이 상태를 이룬다.
여기서 문제가 생긴다. Q-table은 상태를 칸으로 나누어 저장해야 한다. 그런데 카트 위치가 0.13일 때와 0.14일 때를 완전히 다른 상태로 볼 것인가? 막대 각도가 2.01도일 때와 2.02도일 때도 다른 칸에 넣을 것인가? 세상을 너무 촘촘하게 나누면 표가 끝없이 커지고, 너무 듬성듬성 나누면 중요한 차이를 놓친다.
Atari 게임은 더 극단적이다. 에이전트가 보는 상태가 게임 화면 이미지라면 어떨까? 화면은 픽셀로 이루어져 있다. 각 픽셀은 색을 가진다. 픽셀 조합은 사실상 셀 수 없을 만큼 많다. Q-table에 "이 화면에서는 오른쪽으로 가는 게 좋다"를 하나하나 저장하려고 하면, 표는 우주만큼 커질지도 모른다.
이때 필요한 생각의 전환이 바로 이것이다.
Q값을 전부 외우지 말고, 비슷한 상태에서 비슷한 값을 예측하게 만들 수는 없을까?
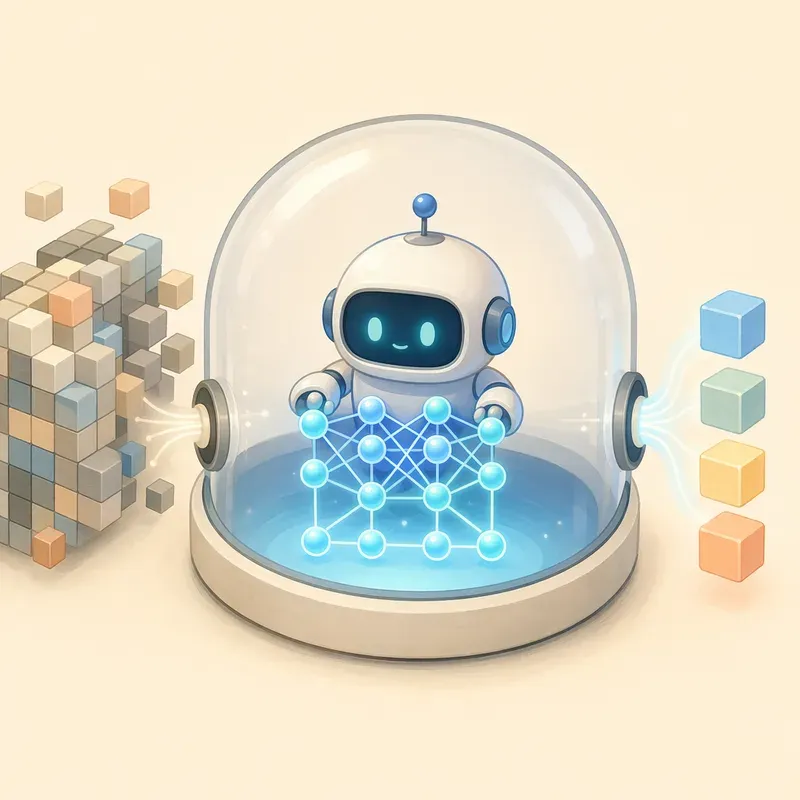
외우는 표에서 예측하는 신경망으로
DQN, 즉 Deep Q-Network는 이름 그대로 Q-learning에 깊은 신경망을 결합한 방법이다. 핵심은 간단하다. Q-table이 하던 일을 신경망에게 맡긴다.
Q-table은 이렇게 물었다.
"상태 s에서 행동 a를 하면 Q값이 얼마지?"
DQN은 이렇게 바꿔 묻는다.
"이 상태를 신경망에 넣으면, 가능한 행동들의 Q값을 예측해 줄 수 있을까?"
격자 세계에서는 Q값을 표에 저장했다. 하지만 DQN에서는 Q값을 신경망의 출력으로 얻는다. 상태가 입력으로 들어가면, 신경망은 각 행동에 대한 Q값을 한 번에 출력한다.
예를 들어 행동이 세 가지인 게임이 있다고 하자. 왼쪽, 점프, 오른쪽을 선택할 수 있다. 어떤 상태를 신경망에 넣었더니 다음과 같은 값이 나왔다.
왼쪽:   1.2
점프:   3.7
오른쪽: 2.4
이 값들은 "당장 받는 보상"만 뜻하지 않는다. Q값은 지금 이 행동을 선택한 뒤 앞으로 받을 보상까지 고려한 장기적인 기대값이다. 따라서 에이전트가 활용을 선택한다면 가장 큰 값인 점프를 고를 것이다.
물론 처음부터 신경망이 똑똑한 것은 아니다. 처음에는 거의 엉뚱한 값을 내놓는다. 하지만 경험을 반복하면서 "아, 이 상황에서는 점프가 생각보다 좋았구나", "이 화면에서 오른쪽으로 가면 위험하구나" 같은 방향으로 예측을 고쳐 간다.
즉 DQN은 Q값을 저장하는 방식이 아니라 Q값을 근사하는 방식이다. 여기서 근사한다는 말은 정확한 정답표를 갖고 있지는 않지만, 입력과 출력 사이의 패턴을 배워 그럴듯한 값을 예측한다는 뜻이다.
DQN의 기본 구조
DQN의 구조를 아주 단순하게 그리면 다음과 같다.
상태 s ──> 신경망 ──> Q(s, a1), Q(s, a2), Q(s, a3), ...상태가 CartPole의 네 개 숫자라면 입력은 숫자 벡터가 된다. 신경망은 그 숫자를 받아 왼쪽으로 미는 행동의 Q값과 오른쪽으로 미는 행동의 Q값을 출력한다.
상태가 Atari 게임 화면이라면 입력은 이미지가 된다. 이때는 이미지에서 공의 위치, 적의 움직임, 벽의 모양 같은 정보를 뽑아내야 한다. 그래서 이미지 처리에 강한 합성곱 신경망, 즉 CNN을 사용할 수 있다. CNN은 이미지 안에서 중요한 패턴을 찾는 신경망 구조다. 사람이라면 화면을 보고 "공이 아래로 떨어지고 있네"라고 판단하지만, 신경망은 픽셀의 패턴을 통해 비슷한 정보를 배운다.
DQN이 출력하는 것은 행동 하나가 아니다. 가능한 행동마다 하나씩 Q값을 출력한다. 이 점이 중요하다. 정책 기반 방법은 나중에 다룰 내용이지만, 정책 기반 방법은 주로 "어떤 행동을 할 확률"을 직접 출력한다. 반면 DQN은 "각 행동이 얼마나 좋은지"를 출력하고, 그중 가장 좋아 보이는 행동을 선택한다.
정리하면 DQN의 흐름은 다음과 같다.
상태를 신경망에 입력한다.
신경망이 가능한 행동들의 Q값을 출력한다.
에이전트는 보통 가장 큰 Q값을 가진 행동을 선택한다.
실제 보상을 받고 다음 상태로 이동한 뒤, 예측이 얼마나 틀렸는지 계산해 신경망을 수정한다.
이 구조 덕분에 DQN은 작은 표에 갇히지 않는다. 상태가 숫자 몇 개든, 이미지든, 복잡한 센서 데이터든 신경망이 처리할 수 있는 형태라면 Q값을 예측할 수 있다.
Bellman Equation은 사라지지 않는다
DQN은 딥러닝을 사용하지만, 강화학습의 심장은 그대로 남아 있다. Q-learning에서 배운 업데이트 목표를 기억해 보자.
목표값 = 현재 보상 + 할인율 × 다음 상태에서 가능한 최대 Q값수식으로 쓰면 다음과 비슷하다.
y = r + γ max Q(s', a')여기서 s'는 다음 상태, a'는 다음 상태에서 가능한 행동, γ는 할인율이다. 이 목표값은 "지금 받은 보상에, 다음 상태에서 기대할 수 있는 최고의 미래 가치를 더한 값"이다.
Q-table에서는 이 목표값을 이용해 표 안의 숫자 하나를 직접 고쳤다. DQN에서는 표의 숫자를 고치는 대신, 신경망의 예측값이 이 목표값에 가까워지도록 학습한다.
예를 들어 신경망이 어떤 상태에서 오른쪽 행동의 Q값을 2.0이라고 예측했다고 하자. 그런데 실제 경험을 바탕으로 계산한 목표값이 5.0이라면, 신경망은 오른쪽 행동의 가치를 너무 낮게 본 것이다. 그래서 그 예측을 조금 올리는 방향으로 가중치를 수정한다.
반대로 신경망이 8.0이라고 예측했는데 목표값이 3.0이라면, 지나치게 낙관한 것이다. 이때는 예측값을 낮추는 방향으로 학습한다.
딥러닝에서 이런 차이를 손실, 또는 loss라고 부른다. 손실은 "모델의 예측이 목표와 얼마나 다른가"를 나타내는 값이다. DQN은 Q값 예측과 Bellman 목표값 사이의 차이를 줄이는 방향으로 신경망을 훈련한다.
여기서 재미있는 점은 목표값 자체도 완벽한 정답이 아니라는 것이다. 지도학습에서는 보통 고양이 사진에 "고양이"라는 정답 라벨이 붙어 있다. 하지만 DQN에는 그런 정답표가 없다. 에이전트가 직접 움직이며 얻은 경험을 바탕으로, 현재의 추정값을 조금씩 더 나은 추정값으로 바꾼다. 그래서 강화학습은 늘 조금 흔들린다. 정답을 외우는 공부가 아니라, 모험을 하며 지도를 그리는 공부에 가깝다.
CartPole에서 Q-table이 곤란한 이유
CartPole은 DQN을 이해하기 좋은 예다. 게임의 목표는 단순하다. 카트를 왼쪽이나 오른쪽으로 움직여 막대가 넘어지지 않게 하면 된다. 막대가 오래 서 있을수록 좋은 보상을 받는다.
행동은 두 개뿐이다.
0: 왼쪽으로 밀기
1: 오른쪽으로 밀기
문제는 상태다. CartPole의 상태는 보통 네 개의 연속값으로 표현된다.
카트의 위치
카트의 속도
막대의 각도
막대의 각속도
Q-table을 쓰려면 이 연속값들을 여러 구간으로 잘라야 한다. 예를 들어 각 값을 10개 구간으로 나누면 상태 수는 10 × 10 × 10 × 10 = 10,000개가 된다. 행동이 두 개라면 Q값은 20,000개가 필요하다. 이 정도는 아직 버틸 수 있어 보인다.
하지만 각 값을 100개 구간으로 나누면 상태 수는 100 × 100 × 100 × 100 = 100,000,000개가 된다. 행동까지 고려하면 2억 개의 Q값이 필요하다. 게다가 실제로 에이전트가 모든 상태를 충분히 방문하기도 어렵다. 표 안에는 거의 한 번도 업데이트되지 않은 칸들이 잔뜩 남게 된다.
DQN은 이 문제를 다른 방식으로 푼다. "각 상태를 별도의 칸으로 외우자"가 아니라 "상태의 숫자 패턴을 보고 Q값을 예측하자"라고 생각한다. 막대가 살짝 오른쪽으로 기울고 오른쪽으로 더 넘어가는 중이라면, 신경망은 오른쪽으로 밀어 균형을 맞추는 것이 좋다는 패턴을 배울 수 있다. 완전히 같은 상태를 본 적이 없어도, 비슷한 상태에서 배운 지식을 활용할 수 있다.
이것이 함수 근사의 힘이다. 함수 근사란 입력 상태를 받아 Q값을 출력하는 함수를 학습한다는 뜻이다. 표는 본 적 있는 칸에 강하지만, 신경망은 비슷한 상황으로 일반화할 수 있다. 일반화는 배운 내용을 새로운 상황에 적용하는 능력이다.
Atari 화면을 본다는 것
Atari 게임으로 가면 DQN의 필요성은 더 분명해진다. 사람은 게임 화면을 보면 중요한 정보를 빠르게 골라낸다. 공이 어디 있는지, 내 캐릭터가 어디 있는지, 적이 어떤 방향으로 움직이는지, 점수가 올라가는 행동이 무엇인지 대략 이해한다.
하지만 컴퓨터에게 화면은 숫자 덩어리다. 가로와 세로로 늘어선 픽셀, 그리고 각 픽셀의 색상값이 있을 뿐이다. 화면 하나만 해도 수천 개, 수만 개의 숫자로 이루어질 수 있다. 여기에 시간까지 고려해야 한다. 공이 어디에 있는지만으로는 부족하고, 공이 어디로 움직이는지도 알아야 한다.
Q-table은 이런 상태를 거의 다룰 수 없다. 화면의 픽셀 조합 하나하나를 상태로 보면 가능한 상태 수가 폭발한다. 같은 게임 장면이라도 공이 한 픽셀만 옆으로 이동하면 다른 상태가 된다. 배경 색이 조금 달라져도 다른 상태가 된다. 표로는 감당하기 어렵다.
DQN은 여기서 딥러닝의 장점을 가져온다. 신경망은 이미지에서 패턴을 뽑아낼 수 있다. 공의 위치, 막대의 위치, 적의 모양 같은 유용한 정보를 사람이 직접 규칙으로 알려 주지 않아도 학습할 수 있다. 물론 마법처럼 한 번에 되는 것은 아니다. 많은 경험과 안정적인 학습 장치가 필요하다. 그래도 방향은 분명하다. DQN은 복잡한 입력을 받아 행동 가치로 연결하는 길을 열었다.
이 점 때문에 DQN은 딥 강화학습의 상징적인 출발점처럼 여겨진다. 강화학습의 Bellman 아이디어와 딥러닝의 표현 학습이 만났기 때문이다. 표현 학습이란 원본 데이터에서 중요한 특징을 모델이 스스로 찾아내는 것을 말한다. 사람이 "이 픽셀은 공이고, 저 픽셀은 벽이야"라고 일일이 알려 주지 않아도, 모델이 보상을 통해 유용한 특징을 발견하도록 하는 것이다.
DQN은 정책을 직접 배우지 않는다
DQN을 이해할 때 자주 헷갈리는 지점이 있다. DQN은 행동을 선택하므로 정책을 배우는 것처럼 보인다. 실제로 DQN 에이전트는 어떤 상태에서 행동을 고른다. 하지만 엄밀히 말하면 DQN이 직접 학습하는 것은 정책이 아니라 Q함수다.
정책은 "상태에서 어떤 행동을 할 것인가"를 정하는 규칙이다. DQN에서는 Q값을 이용해 정책을 만든다. 가장 단순한 방식은 Q값이 가장 큰 행동을 고르는 것이다.
정책: 현재 상태에서 Q값이 가장 큰 행동을 선택한다.하지만 늘 가장 큰 Q값만 고르면 탐험이 사라진다. 그래서 Q-learning에서 배운 ε-greedy를 그대로 사용할 수 있다. 대부분의 경우에는 Q값이 가장 큰 행동을 고르지만, 가끔은 무작위 행동을 해 본다. 아직 모르는 길을 시험해 보기 위해서다.
처음에는 신경망의 Q값이 믿을 만하지 않다. 이때 너무 빨리 한 행동만 고집하면 잘못된 습관에 빠질 수 있다. 에이전트가 우연히 오른쪽으로 가다 작은 보상을 받았다고 해서 영원히 오른쪽만 고르면, 왼쪽에 더 큰 기회가 있는지 알 수 없다. 그래서 DQN에서도 탐험과 활용의 균형은 여전히 중요하다.
표보다 강하지만, 더 까다롭다
DQN은 Q-table보다 강력하다. 큰 상태 공간을 다룰 수 있고, 이미지 같은 고차원 입력도 처리할 수 있다. 비슷한 상태에서 배운 내용을 새로운 상태에 적용할 수도 있다. 하지만 강력해진 만큼 학습은 더 까다로워진다.
Q-table에서는 특정 칸 하나만 고치면 됐다. Q(s, a) 하나를 업데이트해도 다른 상태의 값은 직접 바뀌지 않는다. 하지만 신경망은 다르다. 하나의 경험으로 가중치를 수정하면, 그 신경망이 예측하는 여러 상태의 Q값이 함께 바뀔 수 있다. 좋은 일반화가 일어나면 큰 장점이지만, 잘못 움직이면 이미 괜찮았던 예측까지 흔들릴 수 있다.
또 다른 문제는 목표값이 계속 변한다는 점이다. 지도학습의 정답 라벨은 보통 고정되어 있다. 강아지 사진은 오늘도 강아지고 내일도 강아지다. 하지만 DQN의 목표값에는 max Q(s', a')가 들어간다. 이 Q값 역시 신경망이 예측한다. 즉 신경망은 자기가 만든 추정값을 바탕으로 다시 자기를 학습한다.
마치 아직 완성되지 않은 지도를 보며 길을 찾고, 그 길 찾기 결과로 다시 지도를 고치는 일과 비슷하다. 잘 굴러가면 점점 정확한 지도가 만들어지지만, 조금만 불안정해지면 엉뚱한 방향으로 확신이 커질 수 있다.
그래서 실제 DQN에는 학습을 안정시키기 위한 중요한 장치들이 들어간다. 대표적인 것이 경험 재생과 타깃 네트워크다. 경험 재생은 과거 경험을 모아 두었다가 섞어서 다시 학습하는 방법이고, 타깃 네트워크는 목표값 계산에 사용하는 신경망을 잠시 고정해 학습이 너무 흔들리지 않게 만드는 방법이다. 이 둘은 DQN을 단순한 아이디어에서 실제로 작동하는 알고리즘으로 끌어올리는 핵심 장치다.
DQN이 열어 준 문
DQN의 핵심은 한 문장으로 요약할 수 있다.
Q-table에 저장하던 Q값을 신경망이 예측하게 만든다.
이 문장은 단순하지만, 강화학습의 세계에서는 큰 의미를 가진다. 작은 격자 세계에서만 움직이던 Q-learning이 훨씬 복잡한 문제로 나아갈 수 있게 되었기 때문이다. 상태가 연속값이어도, 이미지여도, 사람이 직접 모든 특징을 설계하기 어려운 문제여도 신경망을 통해 Q값을 근사할 수 있다.
물론 DQN이 모든 문제를 해결하는 만능 열쇠는 아니다. 행동 공간이 너무 크거나 연속적이면 Q값을 행동마다 출력하는 방식이 부담스러워진다. 학습도 불안정할 수 있다. 나중에 다룰 정책 기반 방법과 Actor-Critic 계열은 이런 한계를 넘기 위해 등장한다.
그래도 DQN은 강화학습을 이해하는 데 매우 중요한 다리다. 한쪽에는 Bellman Equation과 Q-learning이 있다. 다른 한쪽에는 딥러닝이 있다. DQN은 이 둘을 연결한다. 그래서 DQN을 이해하면 "딥 강화학습"이라는 말이 갑자기 덜 낯설어진다.
에이전트는 여전히 같은 일을 한다. 상태를 본다. 행동을 선택한다. 보상을 받는다. 다음 상태로 이동한다. 그리고 장기 보상을 높이는 방향으로 자신을 고친다.
달라진 것은 기억 방식이다. 이제 에이전트는 거대한 표를 들고 다니지 않는다. 대신 신경망이라는 예측기를 품고 세상을 바라본다. 표에 없는 상태를 만나도 멈추지 않는다. 비슷한 경험에서 배운 감각으로 "이 행동이 더 나을 것 같다"고 추정한다.
그 순간, 강화학습은 작은 장난감 문제를 넘어 복잡한 화면과 연속적인 세계로 발을 내딛는다.
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.