


지금까지 우리는 딥러닝을 이루는 부품을 하나씩 살펴보았다. 텐서는 데이터를 담는 그릇이고, 모델은 입력을 받아 예측을 만든다. 손실 함수는 예측이 얼마나 틀렸는지 알려 주고, 역전파는 어느 가중치를 어떻게 고쳐야 하는지 계산한다. 옵티마이저는 그 계산 결과를 바탕으로 파라미터를 조금씩 움직인다.
이제 이 부품들을 한곳에 모아 첫 번째 완성된 딥러닝 분류기를 만들어 보자. 목표는 손글씨 숫자 이미지를 보고 0부터 9까지의 숫자 중 무엇인지 맞히는 것이다. 이번 장에서 만들 모델은 MLP, 즉 다층 퍼셉트론이다. 이미지를 아주 단순한 숫자 배열로 펼친 뒤, 여러 개의 선형층과 ReLU를 통과시켜 숫자를 분류한다.
처음에는 신기하게 느껴질 수 있다. 사람에게는 삐뚤삐뚤한 손글씨가 그림처럼 보이지만, 모델에게는 단지 0과 1 사이의 숫자가 빽빽하게 들어 있는 표일 뿐이다. 그런데 그 숫자 표를 충분히 많이 보고, 틀릴 때마다 조금씩 고치면 모델은 어느새 "이건 3일 가능성이 높고, 저건 8일 가능성이 높다"라고 말하게 된다.
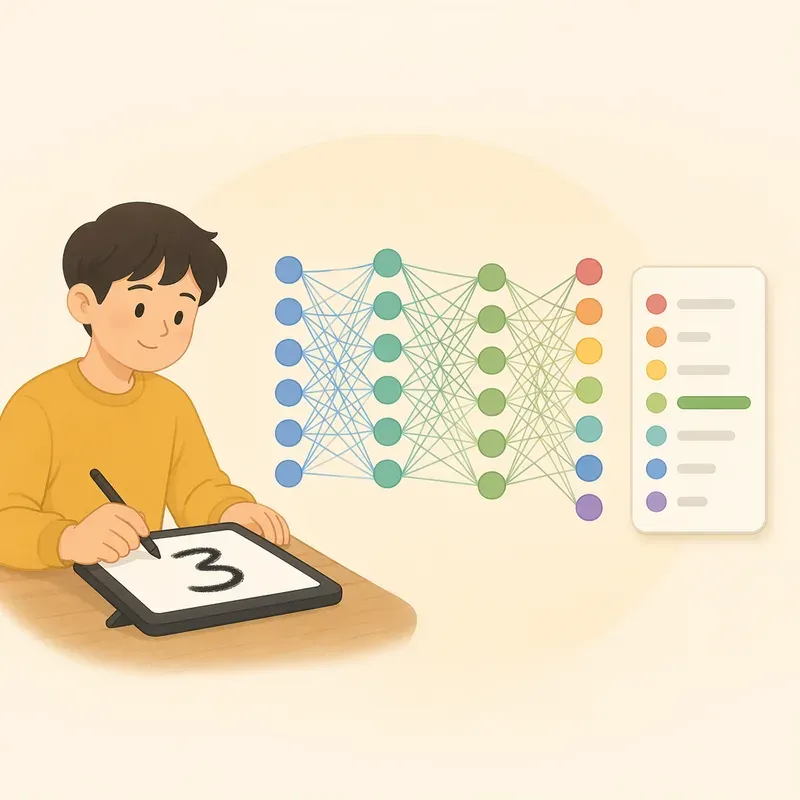
손글씨 이미지는 숫자들의 격자다
우리가 사용할 데이터는 손글씨 숫자 이미지다. 각 이미지는 보통 28×28 크기의 흑백 이미지로 다룬다. 가로 28칸, 세로 28칸짜리 작은 종이에 숫자가 적혀 있다고 생각하면 된다. 흑백 이미지이므로 각 칸에는 색상 정보가 하나만 들어간다. 검은색에 가까우면 값이 크고, 배경처럼 하얀 부분이면 값이 작다.
PyTorch에서 이미지를 텐서로 불러오면 보통 다음과 같은 모양을 가진다.
[배치 크기, 채널 수, 높이, 너비]손글씨 숫자 이미지 한 장은 흑백이므로 채널 수가 1이다. 배치 크기가 64라면 입력 텐서의 모양은 다음과 같다.
[64, 1, 28, 28]여기서 64는 한 번에 모델에 넣을 이미지 개수다. 1은 흑백 채널이고, 28과 28은 이미지의 높이와 너비다.
하지만 이번 장에서 사용할 MLP는 이미지를 이미지답게 바라보지 않는다. MLP는 입력을 한 줄짜리 숫자 목록으로 받는다. 그래서 28×28 이미지를 다음처럼 길이 784짜리 벡터로 펼쳐야 한다.
28 * 28 = 784즉, 이미지 한 장은 다음과 같이 바뀐다.
[1, 28, 28] → [784]책상 위에 놓인 28×28 격자 종이를 가위로 한 줄씩 잘라 길게 이어 붙인다고 생각하면 된다. 그림의 모양은 사라진 것 같지만, 각 픽셀의 밝기 정보는 그대로 남아 있다. MLP는 이 784개의 숫자를 보고 어떤 숫자인지 맞힌다.
데이터 준비하기
먼저 필요한 라이브러리를 불러오자. 이번 실습에서는 torchvision을 사용해 손글씨 숫자 데이터를 내려받는다.
import torch
from torch import nn
from torch.utils.data import DataLoader
from torchvision import datasets, transforms
import matplotlib.pyplot as plt
실행 장치도 정해 둔다. GPU를 사용할 수 있으면 GPU를 쓰고, 그렇지 않으면 CPU를 사용한다.
device = "cuda" if torch.cuda.is_available() else "cpu"
print(device)
결과가 cuda라면 GPU에서 학습한다. cpu가 나오더라도 괜찮다. 이번 MLP 모델은 비교적 작기 때문에 CPU에서도 충분히 실습할 수 있다.
이제 데이터셋을 준비하자.
transform = transforms.ToTensor()

train_dataset = datasets.MNIST(
    root="data",
    train=True,
    download=True,
    transform=transform
)

test_dataset = datasets.MNIST(
    root="data",
    train=False,
    download=True,
    transform=transform
)transforms.ToTensor()는 이미지를 PyTorch 텐서로 바꿔 준다. 동시에 픽셀 값을 0부터 1 사이의 숫자로 바꿔 준다. 원래 이미지는 0부터 255 사이의 정수 값으로 표현되는 경우가 많은데, 신경망은 보통 너무 큰 입력값보다 적당히 작은 범위의 입력값을 더 다루기 쉽다.
학습용 데이터와 테스트용 데이터를 나누어 불러왔다. 학습용 데이터는 모델이 가중치를 조정하는 데 사용하고, 테스트용 데이터는 학습이 끝난 뒤 모델이 처음 보는 데이터에 얼마나 잘 맞히는지 확인하는 데 사용한다.
데이터로더도 만든다.
batch_size = 64

train_loader = DataLoader(
    train_dataset,
    batch_size=batch_size,
    shuffle=True
)

test_loader = DataLoader(
    test_dataset,
    batch_size=batch_size,
    shuffle=False
)shuffle=True는 학습 데이터를 매 에폭마다 섞겠다는 뜻이다. 모델이 늘 같은 순서로만 데이터를 보면 특정 순서에 익숙해질 수 있다. 카드를 섞고 문제를 푸는 편이 더 공정한 연습이 되는 것과 비슷하다.
데이터 하나를 확인해 보자.
image, label = train_dataset[0]

print(image.shape)
print(label)
출력은 대략 다음과 비슷하다.
torch.Size([1, 28, 28])
5
이미지는 [1, 28, 28] 모양의 텐서이고, 라벨은 정답 숫자다. 실제 그림도 확인해 보자.
plt.imshow(image.squeeze(), cmap="gray")
plt.title(f"label: {label}")
plt.axis("off")
plt.show()image.squeeze()는 크기가 1인 차원을 제거한다. [1, 28, 28]에서 앞의 채널 차원을 잠시 없애 [28, 28]로 만든다. 그래야 matplotlib이 흑백 이미지로 보기 좋게 그릴 수 있다.
MLP는 이미지를 한 줄로 펼쳐서 본다
이제 모델을 만들 차례다. 이번 모델의 구조는 단순하다.
이미지 입력
→ 784개 숫자로 펼치기
→ 선형층
→ ReLU
→ 선형층
→ ReLU
→ 선형층
→ 10개 점수 출력
마지막에 10개 점수를 출력하는 이유는 분류할 숫자가 0부터 9까지 총 10개이기 때문이다. 모델은 "이 이미지는 0일 점수, 1일 점수, 2일 점수…"를 각각 계산한다. 그중 가장 큰 점수를 가진 숫자를 최종 예측으로 선택한다.
코드로 작성하면 다음과 같다.
class DigitMLP(nn.Module):
    def __init__(self):
        super().__init__()

        self.net = nn.Sequential(
            nn.Flatten(),
            nn.Linear(28 * 28, 128),
            nn.ReLU(),
            nn.Linear(128, 64),
            nn.ReLU(),
            nn.Linear(64, 10)
        )

    def forward(self, x):
        return self.net(x)
여기서 nn.Flatten()이 바로 이미지를 한 줄로 펼치는 역할을 한다. 입력이 [64, 1, 28, 28]이라면 nn.Flatten()을 지난 뒤에는 [64, 784]가 된다. 배치 크기 64는 그대로 유지되고, 이미지 한 장의 픽셀 정보만 길게 펼쳐진다.
첫 번째 선형층은 784개의 입력을 받아 128개의 값으로 바꾼다.
nn.Linear(28 * 28, 128)이 128개의 값은 사람이 직접 정한 특징이 아니다. 모델이 학습을 통해 스스로 만들어 내는 중간 표현이다. 어떤 뉴런은 숫자의 왼쪽 위에 진한 획이 있는지를 민감하게 볼 수 있고, 어떤 뉴런은 아래쪽 곡선이나 가운데 세로선 같은 패턴에 반응할 수 있다. 물론 우리가 그 뉴런 하나하나에 이름을 붙여 준 것은 아니다. 손실을 줄이는 과정에서 그런 역할이 자연스럽게 생기는 것이다.
ReLU는 음수 값을 0으로 만들고 양수 값은 그대로 통과시키는 활성화 함수다.
nn.ReLU()ReLU가 없다면 선형층을 여러 개 쌓아도 결국 하나의 큰 선형 계산과 비슷해진다. ReLU는 층과 층 사이에 꺾임을 만들어 준다. 이 꺾임 덕분에 모델은 단순한 직선 경계가 아니라 더 복잡한 패턴을 표현할 수 있다.
마지막 선형층은 64개의 값을 10개의 점수로 바꾼다.
nn.Linear(64, 10)여기서 출력되는 10개 값은 확률이 아니다. 흔히 로짓이라고 부르는 원시 점수다. 예를 들어 어떤 이미지에 대해 모델이 다음과 같은 값을 출력할 수 있다.
[ -2.1, 0.3, 1.2, 5.7, -1.0, 2.4, -3.2, 0.8, 1.9, 0.1 ]이 경우 가장 큰 값은 네 번째 위치의 5.7이다. 위치는 0부터 세므로 네 번째 위치는 숫자 3에 해당한다. 따라서 모델의 예측은 3이다.
모델 객체를 만들고 장치로 보낸다.
model = DigitMLP().to(device)
print(model)
교차 엔트로피 손실: 정답 숫자의 점수를 높여라
분류 문제에서는 손실 함수로 교차 엔트로피를 자주 사용한다. PyTorch에서는 nn.CrossEntropyLoss()로 사용할 수 있다.
criterion = nn.CrossEntropyLoss()교차 엔트로피 손실은 모델이 정답 클래스에 높은 점수를 주도록 유도한다. 손글씨 이미지의 정답이 7이라면, 모델은 7번 위치의 점수를 다른 숫자보다 높게 만들어야 한다. 반대로 정답이 7인데 모델이 1이나 9에 더 높은 점수를 주면 손실이 커진다.
중요한 점이 하나 있다. nn.CrossEntropyLoss()를 사용할 때는 모델 마지막에 Softmax를 직접 붙이지 않는다. PyTorch의 교차 엔트로피 손실 함수는 내부적으로 점수를 확률처럼 다루는 계산을 포함한다. 그래서 모델은 확률이 아니라 로짓을 그대로 출력하면 된다.
옵티마이저는 Adam을 사용하자.
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)Adam은 각 파라미터의 이동 방향과 보폭을 조금 더 영리하게 조절하는 최적화 알고리즘이다. 기본 경사하강법보다 실습에서 안정적으로 좋은 결과를 보여 주는 경우가 많다.
정확도: 몇 개나 맞혔는가
손실은 학습을 위한 신호다. 하지만 사람이 모델 성능을 볼 때는 "그래서 몇 퍼센트나 맞혔어?"가 더 직관적이다. 그래서 분류 문제에서는 정확도를 함께 확인한다.
정확도는 전체 예측 중 정답과 일치한 비율이다.
정확도 = 맞힌 개수 / 전체 개수예를 들어 100개 중 92개를 맞혔다면 정확도는 92%다.
모델의 출력 로짓에서 가장 큰 값을 가진 인덱스를 찾으면 예측 숫자가 된다.
def calculate_accuracy(logits, y):
    preds = torch.argmax(logits, dim=1)
    correct = (preds == y).sum().item()
return correcttorch.argmax(logits, dim=1)은 각 이미지마다 10개 점수 중 가장 큰 점수의 위치를 찾는다. dim=1인 이유는 로짓의 모양이 보통 [배치 크기, 클래스 수]이기 때문이다. 즉, 각 행마다 가장 큰 클래스를 고른다.
학습 루프 만들기
이제 이전에 배운 학습 루프를 실제 숫자 분류 모델에 적용해 보자.
def train_one_epoch(model, data_loader, criterion, optimizer, device):
    model.train()

    total_loss = 0.0
    total_correct = 0
    total_count = 0

    for X, y in data_loader:
        X = X.to(device)
        y = y.to(device)

        logits = model(X)
        loss = criterion(logits, y)

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        batch_size = X.size(0)
        total_loss += loss.item() * batch_size
        total_correct += calculate_accuracy(logits, y)
        total_count += batch_size

    avg_loss = total_loss / total_count
    avg_acc = total_correct / total_count

    return avg_loss, avg_acc
이 코드는 지금까지 배운 흐름을 거의 그대로 담고 있다.
모델이 예측한다. 손실을 계산한다. 이전 기울기를 지운다. 역전파로 새 기울기를 계산한다. 옵티마이저가 파라미터를 수정한다. 그리고 이 과정을 배치마다 반복한다.
검증 또는 테스트에서는 가중치를 수정하지 않는다. 모델이 현재 실력으로 얼마나 잘 맞히는지만 확인한다. 따라서 loss.backward()와 optimizer.step()이 필요 없다. 또한 torch.no_grad()를 사용해 기울기 계산을 끈다.
def evaluate(model, data_loader, criterion, device):
    model.eval()

    total_loss = 0.0
    total_correct = 0
    total_count = 0

    with torch.no_grad():
        for X, y in data_loader:
            X = X.to(device)
            y = y.to(device)

            logits = model(X)
            loss = criterion(logits, y)

            batch_size = X.size(0)
            total_loss += loss.item() * batch_size
            total_correct += calculate_accuracy(logits, y)
            total_count += batch_size

    avg_loss = total_loss / total_count
    avg_acc = total_correct / total_count

return avg_loss, avg_accmodel.train()과 model.eval()은 모델의 모드를 바꾼다. 지금 만든 MLP에는 드롭아웃이나 배치 정규화가 없어서 차이가 크게 드러나지 않을 수 있다. 하지만 좋은 습관을 들이는 것이 중요하다. 나중에 드롭아웃이나 배치 정규화가 들어간 모델에서는 이 모드 전환이 매우 중요해진다.
드디어 학습시키기
이제 모든 준비가 끝났다. 몇 번의 에폭 동안 모델을 학습시켜 보자.
epochs = 5

for epoch in range(1, epochs + 1):
    train_loss, train_acc = train_one_epoch(
        model,
        train_loader,
        criterion,
        optimizer,
        device
    )

    test_loss, test_acc = evaluate(
        model,
        test_loader,
        criterion,
        device
    )

    print(
        f"Epoch {epoch:02d} | "
        f"Train Loss: {train_loss:.4f} | "
        f"Train Acc: {train_acc:.4f} | "
        f"Test Loss: {test_loss:.4f} | "
        f"Test Acc: {test_acc:.4f}"
    )
실행하면 에폭이 지날수록 손실은 대체로 줄어들고 정확도는 올라간다. 출력은 환경에 따라 다르지만 보통 다음과 비슷한 흐름을 볼 수 있다.
Epoch 01 | Train Loss: 0.3200 | Train Acc: 0.9070 | Test Loss: 0.1700 | Test Acc: 0.9480
Epoch 02 | Train Loss: 0.1400 | Train Acc: 0.9580 | Test Loss: 0.1200 | Test Acc: 0.9630
Epoch 03 | Train Loss: 0.0950 | Train Acc: 0.9710 | Test Loss: 0.1000 | Test Acc: 0.9690
Epoch 04 | Train Loss: 0.0700 | Train Acc: 0.9780 | Test Loss: 0.0900 | Test Acc: 0.9720
Epoch 05 | Train Loss: 0.0550 | Train Acc: 0.9830 | Test Loss: 0.0850 | Test Acc: 0.9740
숫자가 정확히 같지 않아도 괜찮다. 초기 가중치, 실행 환경, 라이브러리 버전 등에 따라 결과는 조금씩 달라진다. 중요한 것은 방향이다. 모델이 학습할수록 손실이 줄고, 정확도가 올라간다면 학습이 제대로 진행되고 있다는 뜻이다.
여기서 우리가 만든 모델이 실제로 한 일을 다시 떠올려 보자.
입력 이미지는 784개의 픽셀 값으로 펼쳐졌다. 첫 번째 은닉층은 이 픽셀 조합에서 유용한 신호를 찾았다. ReLU는 단순한 선형 계산에 꺾임을 넣어 더 복잡한 표현을 가능하게 했다. 두 번째 은닉층은 앞 층의 표현을 다시 조합했다. 마지막 층은 10개의 숫자 점수를 만들었다. 교차 엔트로피 손실은 정답 숫자의 점수를 높이고 오답 숫자의 점수를 낮추는 방향으로 모델을 밀었다. 역전파는 그 방향을 각 가중치에 전달했다.
이것이 딥러닝 학습의 전체 과정이다. 거창해 보이지만, 결국 같은 리듬이 반복된다.
예측한다
→ 얼마나 틀렸는지 계산한다
→ 어느 가중치가 오차에 영향을 줬는지 본다
→ 조금 수정한다
→ 다시 예측한다
예측 결과 직접 보기
정확도 숫자만 보면 모델이 잘하는 것 같지만, 실제 이미지를 함께 보면 훨씬 감각이 살아난다. 테스트 데이터에서 몇 장을 꺼내 모델의 예측을 확인해 보자.
model.eval()

images, labels = next(iter(test_loader))
images = images.to(device)
labels = labels.to(device)

with torch.no_grad():
    logits = model(images)
    preds = torch.argmax(logits, dim=1)
이제 앞의 16개 이미지를 그려 보자.
plt.figure(figsize=(10, 10))

for i in range(16):
    plt.subplot(4, 4, i + 1)
    plt.imshow(images[i].cpu().squeeze(), cmap="gray")
    plt.title(f"pred: {preds[i].item()} / true: {labels[i].item()}")
    plt.axis("off")

plt.tight_layout()
plt.show()
대부분의 이미지는 모델이 잘 맞힐 것이다. 처음 보는 손글씨인데도 꽤 정확히 맞힌다. 이것이 학습된 표현의 힘이다. 모델은 특정 이미지를 외운 것이 아니라, 여러 손글씨에 공통적으로 나타나는 숫자별 패턴을 익힌 것이다.
물론 모든 숫자를 완벽하게 맞히지는 못한다. 사람도 가끔 헷갈리는 글씨가 있다. 4처럼 보이는 9, 1처럼 보이는 7, 3처럼 보이는 5가 있을 수 있다. 모델도 비슷하게 헷갈린다.
오분류된 숫자 살펴보기
모델이 틀린 사례는 아주 좋은 선생님이다. 정확도는 모델의 전체 성적표라면, 오분류 이미지는 틀린 문제의 풀이 흔적이다. 어떤 문제를 왜 틀렸는지 보면 모델의 한계를 더 잘 이해할 수 있다.
테스트 데이터에서 틀린 이미지를 모아 보자.
wrong_images = []
wrong_labels = []
wrong_preds = []

model.eval()

with torch.no_grad():
    for X, y in test_loader:
        X = X.to(device)
        y = y.to(device)

        logits = model(X)
        preds = torch.argmax(logits, dim=1)

        wrong_mask = preds != y

        for image, label, pred in zip(
            X[wrong_mask].cpu(),
            y[wrong_mask].cpu(),
            preds[wrong_mask].cpu()
        ):
            wrong_images.append(image)
            wrong_labels.append(label)
            wrong_preds.append(pred)

            if len(wrong_images) >= 16:
                break

        if len(wrong_images) >= 16:
            break
이제 틀린 이미지를 그려 보자.
plt.figure(figsize=(10, 10))

for i in range(len(wrong_images)):
    plt.subplot(4, 4, i + 1)
    plt.imshow(wrong_images[i].squeeze(), cmap="gray")
    plt.title(
        f"pred: {wrong_preds[i].item()} / true: {wrong_labels[i].item()}",
        color="red"
    )
    plt.axis("off")

plt.tight_layout()
plt.show()
오분류 이미지를 보면 흥미로운 사실을 발견할 수 있다. 모델이 틀린 숫자는 대개 사람에게도 조금 애매하다. 어떤 9는 윗부분이 닫히지 않아 4처럼 보이고, 어떤 5는 아래쪽 곡선이 흐릿해 3처럼 보인다. 어떤 7은 가운데 획이 약해서 1처럼 보일 수도 있다.
이때 중요한 질문이 생긴다.
"모델은 이미지를 정말 이미지처럼 보고 있을까?"
이번 장의 MLP는 이미지를 한 줄로 펼쳐서 본다. 28×28 격자에서 서로 가까이 있던 픽셀도, 펼쳐진 뒤에는 단순히 긴 숫자 목록의 일부가 된다. 물론 MLP도 가중치를 통해 픽셀 조합을 학습할 수 있다. 하지만 이미지에서 중요한 정보인 "가까운 픽셀끼리 만드는 선, 모서리, 곡선"을 처음부터 특별하게 다루지는 않는다.
예를 들어 숫자 8을 생각해 보자. 8은 위쪽 동그라미와 아래쪽 동그라미가 이어진 모양이다. 사람은 이 구조를 한눈에 본다. 하지만 MLP는 모든 픽셀을 펼쳐 놓고 "이 위치의 값과 저 위치의 값이 함께 크면 8일 가능성이 있다"라는 식으로 배워야 한다. 이미지의 공간 구조를 직접 활용하지 못하는 셈이다.
그래도 MLP는 놀라울 만큼 잘한다. 하지만 이미지 문제에는 이미지를 이미지답게 보는 모델이 더 어울린다. 다음 장에서 만날 CNN은 바로 이 지점에서 등장한다. CNN은 가까운 픽셀들의 관계를 활용해 선, 모서리, 질감 같은 지역적 패턴을 더 효과적으로 학습한다.
모델 저장하기
학습이 끝난 모델은 저장해 두는 것이 좋다. 매번 처음부터 다시 학습할 필요가 없기 때문이다. 이전 장에서 살펴본 것처럼 PyTorch 모델은 state_dict를 저장하면 된다.
torch.save(model.state_dict(), "digit_mlp.pt")나중에 다시 불러올 때는 같은 구조의 모델을 만든 뒤 파라미터를 넣어 준다.
loaded_model = DigitMLP().to(device)
loaded_model.load_state_dict(torch.load("digit_mlp.pt", map_location=device))
loaded_model.eval()
모델 구조와 저장된 파라미터는 짝이 맞아야 한다. DigitMLP의 층 구성이 달라지면 저장된 가중치의 모양도 맞지 않게 된다. 그래서 실무에서는 모델 코드와 체크포인트 파일을 함께 관리하는 습관이 중요하다.
작은 실험으로 감각 키우기
이번 모델은 작지만, 바꿔 볼 수 있는 지점이 많다. 딥러닝 실력은 코드를 한 번 실행하는 것보다 "무엇을 바꾸면 어떤 일이 생기는지" 관찰할 때 빠르게 자란다.
다음 실험을 직접 해 보자.
은닉층의 크기를
128 → 64로 줄이거나128 → 256으로 키워 보기에폭 수를 5에서 10으로 늘렸을 때 학습 정확도와 테스트 정확도가 어떻게 달라지는지 보기
학습률을
0.001,0.01,0.0001로 바꿔 손실 변화 비교하기은닉층을 하나만 쓰거나 세 개로 늘려 성능 차이 확인하기
틀린 이미지를 더 많이 모아 어떤 숫자 쌍을 자주 헷갈리는지 관찰하기
실험할 때는 한 번에 하나씩만 바꾸는 것이 좋다. 학습률과 모델 크기와 에폭 수를 동시에 바꾸면 무엇 때문에 결과가 달라졌는지 알기 어렵다. 좋은 실험은 복잡한 실험이 아니라 이유를 추적할 수 있는 실험이다.
이번 실습이 연결한 것들
이번 장에서 우리는 처음으로 완성된 딥러닝 분류기를 만들었다. 단지 모델 코드 몇 줄을 작성한 것이 아니다. 앞에서 배운 거의 모든 개념이 하나의 흐름으로 연결되었다.
이미지는 텐서가 되었다. 데이터로더는 이미지를 배치 단위로 공급했다. MLP는 이미지를 펼쳐 은닉층과 ReLU를 통과시켰다. 마지막 층은 10개의 로짓을 만들었다. 교차 엔트로피 손실은 예측이 정답에서 얼마나 벗어났는지 계산했다. 역전파는 각 파라미터가 손실에 준 영향을 따라 기울기를 계산했다. Adam 옵티마이저는 그 기울기를 이용해 가중치를 수정했다. 테스트 루프는 모델이 처음 보는 데이터에 얼마나 잘 일반화되는지 확인했다. 마지막으로 오분류 이미지를 보며 모델이 어떤 패턴을 헷갈리는지도 살펴보았다.
이 과정은 앞으로 만날 더 큰 모델에서도 계속 반복된다. CNN도, RNN도, Transformer도 기본 리듬은 같다. 입력을 받고, 표현을 만들고, 예측하고, 손실을 계산하고, 역전파로 고친다.
다만 모델마다 데이터를 바라보는 방식이 다르다. 이번 장의 MLP는 이미지를 한 줄로 펼쳐서 보았다. 다음 장의 CNN은 이미지를 격자 구조 그대로 바라본다. 숫자 하나를 맞히는 작은 실습에서 시작했지만, 우리는 이미 더 큰 질문 앞에 서 있다.
컴퓨터가 이미지를 정말 이미지처럼 이해하려면 어떤 구조가 필요할까?
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.