


신경망이 스스로 고치는 방식
앞 장에서 우리는 미분을 '작은 변화가 결과를 얼마나 바꾸는지 보는 도구'로 바라보았습니다. 이제 그 도구를 신경망 안으로 들여보낼 차례입니다. 신경망은 예측을 하고, 틀린 정도를 손실로 계산한 뒤, 자기 안의 가중치를 조금씩 바꿉니다. 그런데 여기서 중요한 질문이 생깁니다.
모델이 틀렸을 때, 수많은 가중치 중에서 무엇을 얼마나 고쳐야 할까요?
역전파는 바로 이 질문에 답하는 방법입니다. 이름은 조금 딱딱하지만, 핵심은 단순합니다. 모델의 마지막에서 손실이 계산되면, 그 오차가 앞쪽의 가중치들에게 얼마나 책임이 있는지 거꾸로 추적합니다. 마치 팀 프로젝트 결과가 좋지 않았을 때, 마지막 발표만 탓하는 것이 아니라 자료 조사, 분석, 디자인, 발표 준비가 각각 결과에 어떤 영향을 주었는지 되짚어 보는 과정과 비슷합니다.
딥러닝의 학습 흐름은 다음과 같이 정리할 수 있습니다.
모델이 입력을 받아 예측한다.
예측과 정답의 차이를 손실로 계산한다.
손실이 각 가중치에 얼마나 영향을 받는지 계산한다.
그 영향도를 바탕으로 가중치를 조금 수정한다.
이 과정을 여러 번 반복한다.
여기서 세 번째 단계, 즉 '손실이 각 가중치에 얼마나 영향을 받았는지 계산하는 과정'이 역전파입니다.
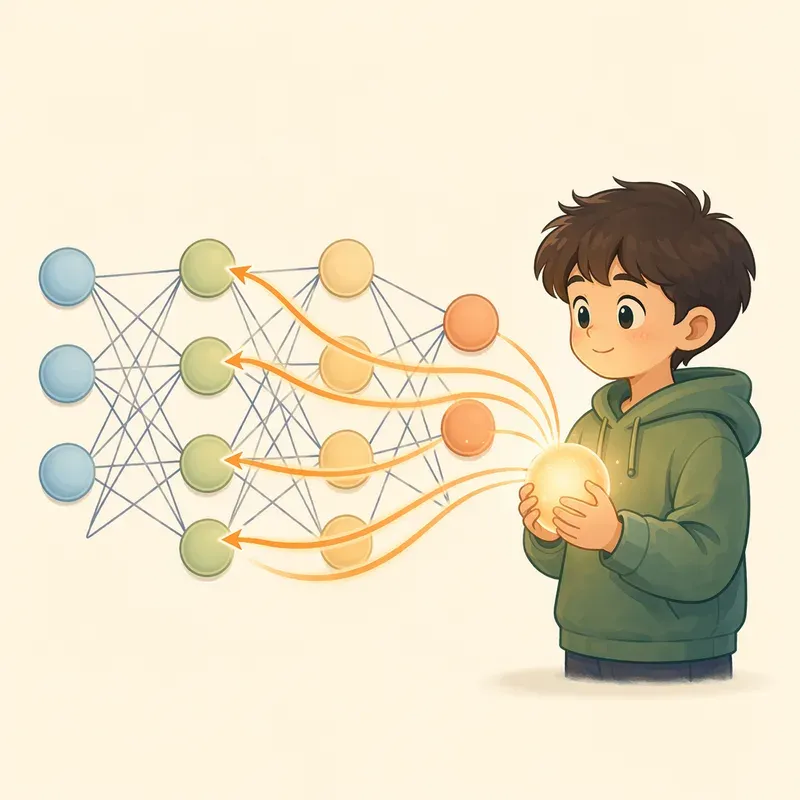
순전파가 길을 만들고, 역전파가 책임을 되짚는다
신경망의 계산은 보통 입력에서 출력 방향으로 흘러갑니다. 입력 데이터가 들어오고, 첫 번째 층을 지나고, 활성화 함수를 지나고, 다음 층을 지나며, 마지막에 예측값이 나옵니다. 이 흐름을 순전파라고 합니다.
예를 들어 아주 작은 신경망이 있다고 해 봅시다.
입력 x가 들어옵니다. 첫 번째 가중치 w1을 만나 중간값 h를 만듭니다. h는 활성화 함수를 지나 a가 됩니다. a는 다시 두 번째 가중치 w2를 만나 예측값 y_hat을 만듭니다. 그리고 y_hat과 정답 y를 비교해 손실 loss를 계산합니다.
흐름을 글로 쓰면 이렇습니다.
x → h → a → y_hat → loss
순전파는 이 길을 따라 값을 계산합니다. 그런데 학습을 하려면 반대 방향의 질문을 해야 합니다.
손실 loss가 커졌다면, y_hat은 손실에 얼마나 영향을 주었을까요? y_hat에 영향을 준 w2는 얼마나 책임이 있을까요? w2보다 앞에 있는 a는 얼마나 영향을 주었을까요? a를 만든 h와 w1은 또 얼마나 책임이 있을까요?
이때 역전파의 흐름은 다음처럼 거꾸로 진행됩니다.
loss → y_hat → w2와 a → h → w1
그래서 이름이 역전파입니다. 오차가 실제로 물리적인 신호처럼 뒤로 흘러간다는 뜻이라기보다는, 손실에서 출발해 각 계산 요소의 영향도를 뒤쪽부터 차례대로 계산한다는 뜻에 가깝습니다.
가까운 가중치부터 계산하는 이유
역전파는 출력층에 가까운 가중치부터 계산합니다. 이유는 간단합니다. 손실은 마지막 예측값에서 바로 계산되기 때문입니다.
예측값이 손실에 어떤 영향을 주는지는 비교적 바로 알 수 있습니다. 예측값이 정답보다 크면 손실이 커지고, 정답보다 작아도 손실이 커집니다. 이 관계는 손실 함수가 알려 줍니다.
그다음에는 예측값을 만든 마지막 층의 가중치를 봅니다. 마지막 층의 가중치가 조금 커지면 예측값이 어떻게 변하는지 알 수 있고, 예측값이 변하면 손실이 어떻게 변하는지도 이미 알고 있습니다. 그러면 마지막 층의 가중치가 손실에 미치는 영향을 계산할 수 있습니다.
조금 더 앞쪽 층으로 가면 한 단계가 추가됩니다. 앞쪽 가중치는 손실에 직접 닿아 있지 않습니다. 앞쪽 가중치는 중간 표현을 바꾸고, 중간 표현은 다음 층의 출력을 바꾸고, 그 출력은 다시 예측값을 바꾸고, 예측값은 손실을 바꿉니다. 즉 앞쪽 가중치의 책임은 여러 계산 단계를 거쳐 나타납니다.
그래서 역전파는 마지막에서 시작합니다. 가까운 곳의 영향도를 먼저 계산하고, 그 값을 이용해 더 앞쪽의 영향도를 계산합니다. 뒤쪽에서 구한 정보가 앞쪽 계산의 재료가 됩니다.
이 점이 매우 중요합니다. 역전파는 모든 가중치의 책임을 처음부터 따로따로 새로 계산하지 않습니다. 이미 계산한 기울기를 재사용하면서 앞쪽으로 전달합니다. 덕분에 층이 많은 신경망도 효율적으로 학습할 수 있습니다.
체인 룰: 책임을 연결하는 규칙
역전파의 수학적 기반은 체인 룰입니다. 체인 룰은 합성 함수의 미분 규칙입니다. 이름은 어렵지만 의미는 직관적입니다.
어떤 일이 여러 단계를 거쳐 결과에 영향을 준다면, 전체 영향도는 각 단계의 영향도를 곱해서 구할 수 있습니다.
예를 들어 이런 흐름이 있다고 해 봅시다.
w → h → y_hat → loss
가중치 w가 h를 바꿉니다. h가 y_hat을 바꿉니다. y_hat이 loss를 바꿉니다. 그러면 w가 loss에 미치는 전체 영향은 다음과 같이 생각할 수 있습니다.
w가 loss에 미치는 영향 = w가 h에 미치는 영향 × h가 y_hat에 미치는 영향 × y_hat이 loss에 미치는 영향
이것이 체인 룰의 감각입니다. '내가 직접 손실을 바꾸지는 않았지만, 내가 중간값을 바꾸고 그 중간값이 다음 값을 바꾸고 결국 손실이 바뀐다면, 나에게도 책임이 있다'는 뜻입니다.
회사에서 매출이 떨어졌다고 생각해 봅시다. 매출은 최종 결과입니다. 매출에는 광고 클릭률이 영향을 주고, 클릭률에는 광고 문구가 영향을 주며, 광고 문구에는 고객 분석이 영향을 줍니다. 고객 분석은 매출과 직접 연결되어 있지 않지만, 중간 단계를 통해 매출에 영향을 줍니다. 체인 룰은 이런 연결된 영향도를 숫자로 추적하는 방식입니다.
신경망에서도 마찬가지입니다. 앞쪽 가중치는 손실과 멀리 떨어져 있지만, 중간 표현을 통해 손실에 영향을 줍니다. 역전파는 체인 룰을 이용해 이 연결된 영향도를 뒤에서 앞으로 차근차근 계산합니다.
아주 작은 신경망으로 보는 역전파
이제 숫자가 들어간 작은 예로 역전파를 느껴 보겠습니다. 복잡한 신경망 대신 가중치가 두 개뿐인 단순한 모델을 생각해 보겠습니다.
입력 x가 있고, 첫 번째 가중치 w1을 곱해 중간값 h를 만듭니다. 여기서는 설명을 단순하게 하기 위해 활성화 함수는 잠시 빼겠습니다. 그다음 h에 두 번째 가중치 w2를 곱해 예측값 y_hat을 만듭니다. 손실은 평균제곱오차와 비슷하게 0.5 × (y_hat - y)^2로 계산하겠습니다. 앞의 0.5는 미분했을 때 식을 깔끔하게 만들기 위해 붙이는 숫자입니다.
계산 흐름은 다음과 같습니다.
h = x × w1
y_hat = h × w2
loss = 0.5 × (y_hat - y)^2
여기서 우리가 알고 싶은 것은 두 가지입니다. 손실을 줄이려면 w2를 어떻게 바꿔야 할까요? 그리고 w1은 어떻게 바꿔야 할까요?
먼저 w2를 보겠습니다. w2는 y_hat을 직접 만듭니다. y_hat이 손실을 만들기 때문에, w2의 책임은 비교적 가까이 있습니다.
w2 → y_hat → loss
손실이 y_hat에 얼마나 민감한지 보고, y_hat이 w2에 얼마나 민감한지 보면 됩니다. 두 값을 곱하면 w2가 손실에 미친 영향이 됩니다.
이번에는 w1을 보겠습니다. w1은 y_hat을 직접 만들지 않습니다. w1은 h를 만들고, h가 y_hat을 만들고, y_hat이 loss를 만듭니다.
w1 → h → y_hat → loss
따라서 w1의 책임을 구하려면 한 단계가 더 필요합니다. 손실이 y_hat에 얼마나 민감한지, y_hat이 h에 얼마나 민감한지, h가 w1에 얼마나 민감한지를 모두 연결해야 합니다.
여기서 중요한 직관은 이것입니다. 출력에 가까운 w2의 영향도를 계산하면, 그 정보 일부를 이용해 w1의 영향도도 계산할 수 있습니다. 역전파는 이처럼 뒤쪽에서 얻은 기울기를 앞쪽으로 넘겨 주며 계산량을 줄입니다.
가중치는 왜 조금씩만 바꿀까
기울기를 알면 가중치를 어느 방향으로 바꿔야 하는지 알 수 있습니다. 기울기가 양수라면 가중치를 줄이는 쪽이 손실을 낮출 가능성이 큽니다. 기울기가 음수라면 가중치를 키우는 쪽이 손실을 낮출 가능성이 큽니다. 그래서 경사하강법은 보통 다음처럼 가중치를 업데이트합니다.
새 가중치 = 현재 가중치 - 학습률 × 기울기
여기서 학습률은 한 번에 얼마나 움직일지를 정하는 값입니다. 기울기가 방향을 알려 준다면, 학습률은 보폭을 정합니다.
그런데 왜 가중치를 한 번에 크게 바꾸지 않을까요? 손실을 줄이는 방향을 알았다면 과감하게 움직이면 더 빨리 좋아질 것 같기도 합니다. 하지만 신경망의 손실 지형은 대체로 울퉁불퉁합니다. 산책로처럼 완만한 곳도 있지만, 갑자기 꺾이는 곳도 있고, 좁은 골짜기도 있습니다.
너무 크게 움직이면 좋은 지점을 지나쳐 버릴 수 있습니다. 골짜기 아래로 내려가야 하는데 반대편 언덕까지 훌쩍 뛰어넘는 식입니다. 반대로 너무 작게 움직이면 안전하긴 하지만 학습이 지나치게 느립니다. 그래서 딥러닝에서는 '방향'만큼이나 '얼마나 움직일 것인가'가 중요합니다. 다음 장에서 다룰 학습률, 배치, 에폭은 바로 이 움직임의 리듬을 정하는 개념입니다.
NumPy로 작은 신경망 구현하기
이제 직접 손으로 역전파를 구현해 보겠습니다. 아직 PyTorch의 자동 미분을 사용하지 않습니다. NumPy만으로 순전파와 역전파를 작성해 보면, 나중에 loss.backward()가 무엇을 대신해 주는지 훨씬 선명하게 보입니다.
이번 실습에서는 입력 하나, 은닉층 하나, 출력 하나를 가진 아주 작은 신경망을 만들겠습니다. 구조는 다음과 같습니다.
x → Linear → ReLU → Linear → y_hat → loss
첫 번째 Linear 층은 입력을 받아 은닉값을 만듭니다. ReLU는 0보다 작은 값을 0으로 만들고, 0보다 큰 값은 그대로 통과시키는 활성화 함수입니다. 두 번째 Linear 층은 은닉값을 받아 최종 예측값을 만듭니다.
import numpy as np

# 입력과 정답
x = np.array([[2.0]])
y = np.array([[1.0]])

# 가중치와 편향 초기화
w1 = np.array([[0.5]])
b1 = np.array([[0.0]])
w2 = np.array([[0.3]])
b2 = np.array([[0.0]])

learning_rate = 0.1

for step in range(10):
    # 1. 순전파
    z1 = x @ w1 + b1
    a1 = np.maximum(0, z1)  # ReLU
    y_hat = a1 @ w2 + b2

    loss = 0.5 * np.mean((y_hat - y) ** 2)

    # 2. 역전파
    # loss = 0.5 * (y_hat - y)^2
    d_y_hat = y_hat - y

    # y_hat = a1 @ w2 + b2
    d_w2 = a1.T @ d_y_hat
    d_b2 = d_y_hat
    d_a1 = d_y_hat @ w2.T

    # a1 = ReLU(z1)
    d_z1 = d_a1 * (z1 > 0)

    # z1 = x @ w1 + b1
    d_w1 = x.T @ d_z1
    d_b1 = d_z1

    # 3. 가중치 업데이트
    w1 = w1 - learning_rate * d_w1
    b1 = b1 - learning_rate * d_b1
    w2 = w2 - learning_rate * d_w2
    b2 = b2 - learning_rate * d_b2

    print(step, 'loss:', loss, 'prediction:', y_hat[0, 0])
이 코드는 작지만 딥러닝 학습의 거의 모든 핵심을 품고 있습니다. 먼저 입력 x가 w1, b1을 만나 z1이 됩니다. z1은 ReLU를 지나 a1이 됩니다. a1은 w2, b2를 만나 y_hat이 됩니다. 여기까지가 순전파입니다.
그다음 손실을 계산합니다. 예측값 y_hat이 정답 y에서 멀수록 손실이 커집니다. 이제 역전파가 시작됩니다. d_y_hat = y_hat - y는 예측값이 손실에 미치는 영향을 뜻합니다. 예측이 정답보다 작으면 음수가 나오고, 정답보다 크면 양수가 나옵니다. 즉 예측값을 어느 방향으로 움직여야 손실이 줄어드는지 알려 줍니다.
이어서 d_w2, d_b2, d_a1을 계산합니다. 여기서 d_w2는 두 번째 가중치 w2가 손실에 얼마나 영향을 주었는지를 나타냅니다. d_a1은 손실의 책임을 은닉층 출력 a1 쪽으로 넘기는 값입니다. 다시 말해, 뒤쪽 층의 오차 정보를 앞쪽 층으로 전달하는 다리입니다.
그다음 ReLU를 거꾸로 통과합니다. ReLU는 순전파 때 0보다 작은 값을 0으로 막습니다. 따라서 역전파 때도 z1이 0보다 작거나 같았던 위치는 기울기를 통과시키지 않습니다. 코드의 (z1 > 0)이 바로 이 역할을 합니다.
마지막으로 d_w1, d_b1을 계산합니다. 이제 첫 번째 가중치가 손실에 얼마나 책임이 있는지도 알게 되었습니다. 그런 다음 모든 가중치와 편향을 현재 값 - 학습률 × 기울기 방식으로 조금씩 수정합니다.
처음에는 예측이 정답에서 멀 수 있습니다. 하지만 반복이 진행되면 손실이 줄고 예측값이 정답에 가까워지는 모습을 볼 수 있습니다. 이 작은 반복이 거대한 신경망에서도 똑같이 일어납니다. 차이는 숫자의 개수와 층의 깊이뿐입니다.
코드 속 d_는 무엇을 뜻할까
역전파 코드를 처음 보면 d_w1, d_z1, d_a1 같은 이름이 낯설게 느껴질 수 있습니다. 여기서 d_는 보통 '손실에 대한 기울기'를 뜻합니다. 정확히 말하면 d_w1은 w1이 변할 때 손실이 얼마나 변하는지를 나타내는 값입니다.
예를 들어 d_w1이 크다는 것은 w1을 조금만 바꿔도 손실이 크게 변할 수 있다는 뜻입니다. 책임이 큰 가중치라고 볼 수 있습니다. 반대로 d_w1이 0에 가깝다면, 지금 이 데이터와 현재 상태에서는 w1을 조금 바꿔도 손실에 별 영향이 없다는 뜻입니다.
하지만 이 책임은 도덕적인 책임이 아닙니다. '이 가중치가 나쁘다'는 뜻도 아닙니다. 단지 현재 손실이 이 가중치 변화에 얼마나 민감한지를 나타내는 수치입니다. 딥러닝은 이 민감도를 이용해 손실이 낮아질 가능성이 큰 방향으로 파라미터를 움직입니다.
역전파는 정답을 알려 주지 않는다
여기서 한 가지 오해를 조심해야 합니다. 역전파는 가중치의 정답을 한 번에 알려 주는 알고리즘이 아닙니다. 역전파가 알려 주는 것은 '지금 위치에서 손실을 줄이려면 어느 방향으로 움직이는 것이 좋을지'입니다.
산속에서 안개가 자욱하다고 상상해 봅시다. 멀리 있는 목적지는 보이지 않습니다. 다만 발밑의 경사를 느낄 수 있습니다. 왼쪽으로 가면 오르막인지, 오른쪽으로 가면 내리막인지 정도는 알 수 있습니다. 경사하강법은 이 발밑의 경사를 따라 조금씩 내려가는 방법입니다. 역전파는 신경망 안의 모든 가중치에 대해 그 발밑의 경사를 계산해 주는 과정입니다.
그래서 학습은 한 번에 끝나지 않습니다. 예측하고, 손실을 계산하고, 역전파로 기울기를 구하고, 가중치를 조금 바꿉니다. 그리고 다시 예측합니다. 새 위치에서는 기울기도 달라집니다. 다시 계산하고 다시 조금 움직입니다. 딥러닝의 학습은 이 반복 속에서 점점 더 나은 표현을 찾아가는 과정입니다.
깊은 신경망에서도 원리는 같다
실제 신경망은 방금 본 예제보다 훨씬 큽니다. 이미지 분류 모델은 수많은 픽셀을 입력으로 받고, 텍스트 모델은 단어 또는 토큰의 임베딩을 입력으로 받습니다. Transformer 같은 모델에는 Self-Attention, 피드포워드 네트워크, 정규화 층 등 여러 구성 요소가 들어갑니다.
하지만 학습의 기본 원리는 같습니다. 입력이 여러 층을 지나 예측을 만들고, 손실이 계산됩니다. 그런 다음 역전파가 손실에서 출발해 출력층, 중간층, 입력에 가까운 층으로 기울기를 전달합니다. 각 층은 자신이 순전파 때 어떤 계산을 했는지 기억하고 있다가, 역전파 때 그 계산의 미분을 이용해 앞쪽으로 기울기를 넘깁니다.
나중에 PyTorch를 사용하면 우리는 보통 이 과정을 직접 모두 작성하지 않습니다. 텐서에 연산을 쌓고 손실을 계산한 뒤 loss.backward()를 호출하면 PyTorch가 계산 그래프를 따라 기울기를 자동으로 구해 줍니다. 하지만 자동으로 해 준다고 해서 마법은 아닙니다. 지금 본 것처럼 순전파 때 만들어진 계산의 연결을 거꾸로 따라가며 체인 룰을 적용하는 것입니다.
이 감각을 갖고 있으면 딥러닝 코드를 읽을 때 훨씬 덜 막막합니다. 손실이 줄지 않을 때도 어디를 봐야 할지 감이 생깁니다. 기울기가 너무 크면 학습이 불안정할 수 있고, 기울기가 너무 작으면 앞쪽 층이 거의 배우지 못할 수 있습니다. 이런 문제들은 뒤에서 모델 디버깅과 최적화를 다룰 때 다시 만나게 됩니다.
역전파를 한 문장으로 말하면
역전파는 손실에서 출발해 각 가중치가 오차에 얼마나 영향을 주었는지 거꾸로 계산하는 방법입니다.
조금 더 풀어 말하면, 순전파가 '입력으로 예측을 만드는 길'이라면 역전파는 '예측의 오차가 각 가중치와 중간 계산에 얼마나 연결되어 있는지 되짚는 길'입니다. 그리고 체인 룰은 그 길 위의 영향도를 이어 붙이는 규칙입니다.
이제 딥러닝 학습의 핵심 고리가 거의 완성되었습니다. 모델이 예측합니다. 손실이 틀린 정도를 숫자로 말해 줍니다. 역전파가 각 가중치의 책임을 계산합니다. 경사하강법이 그 책임을 바탕으로 가중치를 조금씩 수정합니다. 이 반복이 쌓이면 모델은 단순한 숫자 조합에서 출발해 이미지의 모양을 알아보고, 문장의 의미를 담는 표현을 만들고, 나아가 Transformer와 LLM의 거대한 구조를 학습할 수 있게 됩니다.
다음 장에서는 이 반복을 더 현실적인 학습 과정으로 확장합니다. 가중치를 얼마나 크게 움직일지 정하는 학습률, 데이터를 몇 개씩 묶어 볼지 정하는 배치, 전체 데이터를 몇 번 반복해서 볼지 나타내는 에폭을 살펴보겠습니다. 역전파가 가중치마다 방향을 알려 주었다면, 이제는 모델이 어떤 리듬으로 걸어가야 하는지 배울 차례입니다.
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.