


Self-Attention 직접 구현하기

MLP의 다음 질문: 토큰들은 서로를 어떻게 볼까
이전 장에서 우리는 작은 MLP 언어 모델을 만들었습니다. 그 모델은 block_size만큼의 문맥을 입력으로 받아 다음 토큰을 예측했습니다. Bigram 모델이 바로 앞 글자 하나만 보던 것과 비교하면 큰 발전이었습니다.
하지만 MLP 방식에는 아쉬운 점이 있었습니다. 여러 토큰의 임베딩을 한 줄로 쭉 펼친 뒤 신경망에 넣었기 때문에, 토큰끼리 서로를 직접 비교하지는 않았습니다. 첫 번째 토큰과 일곱 번째 토큰이 서로 관련 있는지, 방금 나온 조사와 앞 단어가 이어지는지, 문장 끝의 어미가 앞의 표현과 맞는지 같은 관계를 명시적으로 계산하지 않았습니다.
Self-Attention은 바로 이 질문에서 출발합니다.
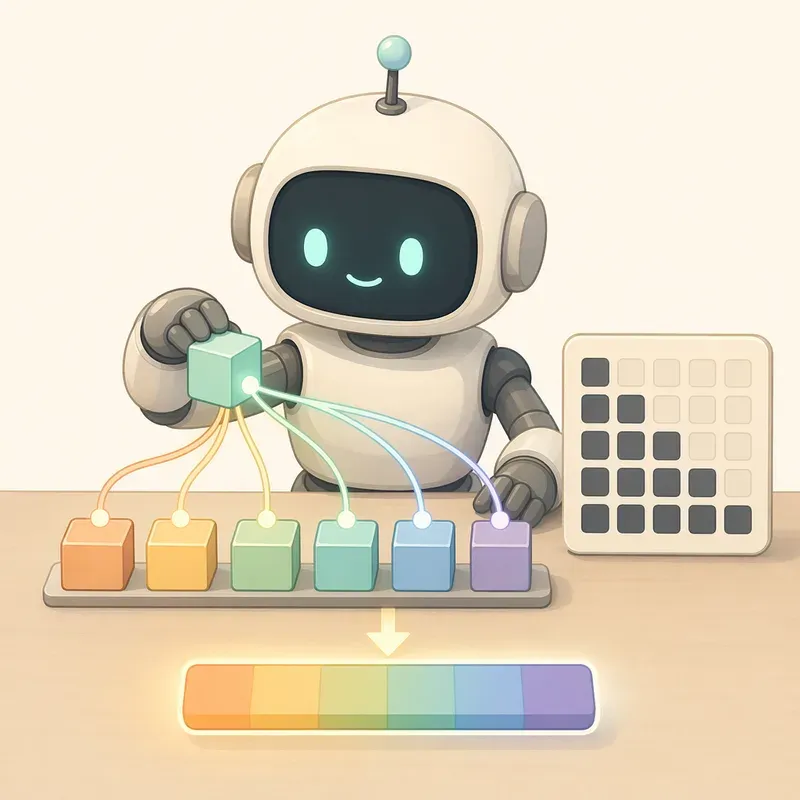
지금 위치의 토큰은, 앞에 있는 어떤 토큰들을 참고해야 할까?이 질문은 언어 모델에서 매우 중요합니다. 다음 글자를 예측하려면 현재 위치의 토큰 하나만 보면 부족합니다. 앞에서 어떤 말이 나왔는지, 어떤 단어 조각이 이어지고 있는지, 문장이 어디로 흘러가고 있는지를 함께 봐야 합니다.
이번 장에서는 수식으로만 보던 Self-Attention을 PyTorch 코드로 직접 구현합니다. 아직 Multi-Head Attention도 아니고, Transformer Block도 아닙니다. 딱 하나의 head만 가진 causal Self-Attention입니다.
여기서 causal은 미래를 보지 못하게 막는다는 뜻입니다. 언어 모델은 왼쪽에서 오른쪽으로 다음 토큰을 예측합니다. 따라서 어떤 위치에서 다음 토큰을 맞힐 때, 그 위치보다 뒤에 있는 토큰을 미리 보면 안 됩니다. 시험 문제를 풀면서 정답지를 몰래 보는 것과 같기 때문입니다.
이번 장의 목표는 단순합니다. Attention이 마법 같은 개념이 아니라, 몇 줄의 행렬 연산으로 작동한다는 것을 직접 확인하는 것입니다.
입력 텐서의 세 차원: B, T, C
Self-Attention 코드를 읽을 때 가장 먼저 익숙해져야 할 것은 텐서의 모양입니다. 앞으로 우리는 계속 (B, T, C)라는 모양을 보게 됩니다.
B = batch, 한 번에 처리하는 샘플 개수
T = time, 문맥 안의 토큰 위치 개수
C = channel, 각 토큰을 표현하는 벡터 차원
예를 들어 batch_size = 4, block_size = 8, n_embd = 32라면 임베딩을 거친 입력 x의 모양은 다음과 같습니다.
x.shape
# torch.Size([4, 8, 32])
이 말은 다음과 같습니다. 한 번에 4개의 문맥 묶음을 처리하고, 각 문맥은 8개의 토큰으로 이루어져 있으며, 각 토큰은 32차원 벡터로 표현된다는 뜻입니다.
조금 더 구체적으로 보면 이런 느낌입니다.
x[0]        = 첫 번째 샘플 전체
x[0, 0]     = 첫 번째 샘플의 0번째 토큰 벡터
x[0, 0, :]  = 그 토큰 벡터의 모든 차원
x[:, 3, :]  = 배치 안의 모든 샘플에서 3번째 위치의 토큰 벡터
Self-Attention은 이 (B, T, C) 텐서를 입력으로 받아, 같은 모양 또는 비슷한 모양의 텐서를 출력합니다. 중요한 점은 각 위치의 벡터가 문맥 속 다른 토큰들의 정보를 섞어 새롭게 갱신된다는 것입니다.
MLP 모델에서는 문맥 전체를 펼쳐 하나의 벡터로 만들었습니다. 반면 Self-Attention에서는 각 위치가 살아 있습니다. 0번째 위치, 1번째 위치, 2번째 위치가 각자 자기 자리에서 앞 토큰들을 참고하고, 자기 표현을 업데이트합니다.
이 차이가 앞으로 GPT 구조를 만드는 핵심 발판이 됩니다.
Query, Key, Value를 코드로 만들기
Self-Attention에서는 각 토큰 벡터에서 세 가지 벡터를 만듭니다.
Query: 내가 찾고 싶은 정보
Key: 내가 가진 정보의 표지
Value: 실제로 전달할 내용
말로만 들으면 조금 추상적입니다. 코드로 보면 훨씬 단순합니다. 입력 벡터 x에 서로 다른 선형층을 통과시키면 됩니다.
self.key = nn.Linear(n_embd, head_size, bias=False)
self.query = nn.Linear(n_embd, head_size, bias=False)
self.value = nn.Linear(n_embd, head_size, bias=False)nn.Linear는 입력 벡터에 행렬을 곱해 다른 벡터로 바꾸는 계층입니다. 여기서는 같은 입력 x에서 k, q, v를 각각 만듭니다.
k = self.key(x)
q = self.query(x)
v = self.value(x)
입력 x의 모양이 (B, T, C)이고, head_size가 32라면 결과는 다음과 같습니다.
x: (B, T, C)
k: (B, T, head_size)
q: (B, T, head_size)
v: (B, T, head_size)
여기서 중요한 점은 T가 유지된다는 것입니다. 즉 문맥 안의 각 토큰마다 Query, Key, Value가 하나씩 만들어집니다.
한 토큰이 다른 토큰을 얼마나 참고할지는 Query와 Key를 비교해서 결정합니다. 그리고 실제로 가져오는 정보는 Value에서 가져옵니다.
scaled dot-product attention
이제 Attention 점수를 계산해 보겠습니다. 현재 위치의 Query와 모든 위치의 Key를 비교해야 합니다. 비교는 점곱, 즉 dot product로 합니다.
wei = q @ k.transpose(-2, -1)여기서 @는 행렬 곱입니다. k.transpose(-2, -1)는 마지막 두 차원을 서로 바꿉니다.
모양을 따라가 보면 이렇습니다.
q:                  (B, T, head_size)
k.transpose(-2,-1): (B, head_size, T)
wei:                (B, T, T)
결과 wei의 모양은 (B, T, T)입니다. 이 행렬은 각 샘플마다 하나씩 생깁니다. wei[b, i, j]는 b번째 샘플에서 i번째 위치의 토큰이 j번째 위치의 토큰을 얼마나 참고하려 하는지를 나타내는 점수입니다.
그런데 실제 구현에서는 여기에 스케일링을 추가합니다.
wei = q @ k.transpose(-2, -1) * head_size-0.5head_size-0.5는 1 / sqrt(head_size)와 같습니다. 왜 이런 값을 곱할까요?
벡터 차원이 커질수록 점곱 결과의 크기도 커지기 쉽습니다. 점수가 너무 커지면 softmax를 통과했을 때 확률이 한두 위치에 지나치게 몰릴 수 있습니다. 예를 들어 어떤 점수는 30이고 다른 점수는 2라면, softmax 결과는 거의 30인 위치 하나에만 집중됩니다. 그러면 학습 초반부터 Attention이 너무 날카로워지고, 기울기 흐름도 불안정해질 수 있습니다.
그래서 Query와 Key의 점곱을 sqrt(head_size)로 나누어 점수의 크기를 적당히 눌러 줍니다. 이것이 scaled dot-product attention입니다.
Attention score = QKᵀ / sqrt(head_size)수식으로 보면 어렵지만, 코드로는 한 줄입니다.
wei = q @ k.transpose(-2, -1) * head_size**-0.5이 한 줄이 각 토큰 사이의 관계 점수를 계산합니다.
미래 토큰을 막는 causal mask
언어 모델에서는 현재 위치가 미래 위치를 보면 안 됩니다. 예를 들어 입력이 다음과 같다고 해 봅시다.
처 음 만 나 는0번째 위치의 처는 자기 자신만 볼 수 있어야 합니다. 1번째 위치의 음은 처와 음을 볼 수 있습니다. 2번째 위치의 공백은 처, 음, 공백까지 볼 수 있습니다. 하지만 2번째 위치가 뒤에 나오는 만, 나, 는을 보면 안 됩니다.
이 규칙을 행렬로 표현하면 하삼각 행렬이 됩니다.
1 0 0 0
1 1 0 0
1 1 1 0
1 1 1 1
행 번호는 현재 위치이고, 열 번호는 참고할 위치입니다. 값이 1인 곳은 볼 수 있고, 0인 곳은 볼 수 없습니다. 위쪽 삼각형이 0으로 막혀 있습니다. 이것이 causal mask입니다.
PyTorch에서는 이렇게 만들 수 있습니다.
tril = torch.tril(torch.ones(block_size, block_size))torch.tril은 lower triangle, 즉 하삼각 부분만 남기는 함수입니다.
Attention 점수 wei에 마스크를 적용할 때는 볼 수 없는 위치를 -inf로 바꿉니다.
wei = wei.masked_fill(tril[:T, :T] == 0, float('-inf'))그다음 softmax를 적용합니다.
wei = F.softmax(wei, dim=-1)왜 하필 -inf일까요? softmax에서 아주 작은 값은 거의 0의 확률이 됩니다. -inf는 확실하게 0이 됩니다. 따라서 미래 위치의 Attention weight는 0이 되고, 모델은 그 정보를 가져올 수 없습니다.
이제 wei는 단순한 점수가 아니라 확률처럼 해석할 수 있는 가중치가 됩니다. 각 위치에서 참고할 수 있는 토큰들의 가중치 합은 1입니다.
마지막으로 이 가중치를 Value에 곱합니다.
out = wei @ v모양은 다음과 같습니다.
wei: (B, T, T)
v:   (B, T, head_size)
out: (B, T, head_size)
즉 각 위치의 출력 벡터는 앞 토큰들의 Value를 가중합한 결과입니다. 어떤 토큰을 많이 참고할수록 그 토큰의 Value가 더 많이 섞입니다.
단일 Head 구현하기
이제 지금까지 설명한 내용을 하나의 클래스로 만들겠습니다. 이 클래스는 입력 x를 받아 causal Self-Attention 결과를 반환합니다.
import torch
import torch.nn as nn
from torch.nn import functional as F

class Head(nn.Module):
    """단일 head causal self-attention"""

    def __init__(self, n_embd, head_size, block_size):
        super().__init__()
        self.key = nn.Linear(n_embd, head_size, bias=False)
        self.query = nn.Linear(n_embd, head_size, bias=False)
        self.value = nn.Linear(n_embd, head_size, bias=False)

        self.register_buffer(
            'tril',
            torch.tril(torch.ones(block_size, block_size))
        )

    def forward(self, x, return_weights=False):
        B, T, C = x.shape

        k = self.key(x)      # (B, T, head_size)
        q = self.query(x)    # (B, T, head_size)
        v = self.value(x)    # (B, T, head_size)

        head_size = k.shape[-1]

        wei = q @ k.transpose(-2, -1) * head_size**-0.5  # (B, T, T)
        wei = wei.masked_fill(self.tril[:T, :T] == 0, float('-inf'))
        wei = F.softmax(wei, dim=-1)                     # (B, T, T)

        out = wei @ v                                    # (B, T, head_size)

        if return_weights:
            return out, wei

        return out
몇 줄 안 되지만, Transformer의 가장 중요한 계산이 들어 있습니다.
register_buffer는 조금 낯설 수 있습니다. tril은 학습되는 파라미터가 아닙니다. 즉 optimizer가 업데이트할 값이 아닙니다. 하지만 모델과 같은 장치, 예를 들어 CPU나 GPU로 함께 이동해야 합니다. register_buffer로 등록하면 model.to(device)를 호출했을 때 이 마스크도 함께 이동합니다.
self.register_buffer('tril', torch.tril(torch.ones(block_size, block_size)))이 한 줄 덕분에 나중에 GPU에서 학습할 때도 마스크 장치 오류를 피할 수 있습니다.
Head만 따로 실행해 보기
먼저 Self-Attention head가 원하는 모양으로 동작하는지 확인해 보겠습니다.
torch.manual_seed(1337)

B = 4
T = 8
C = 32
head_size = 32
block_size = 8

x = torch.randn(B, T, C)
head = Head(n_embd=C, head_size=head_size, block_size=block_size)

out = head(x)
print(out.shape)
출력은 다음과 같아야 합니다.
torch.Size([4, 8, 32])입력도 (4, 8, 32)이고 출력도 (4, 8, 32)입니다. 하지만 내용은 달라졌습니다. 출력의 각 위치는 자기 자신과 과거 위치의 Value를 섞은 결과입니다.
Attention weight도 확인해 봅시다.
out, weights = head(x, return_weights=True)

print(weights.shape)
print(weights[0])weights의 모양은 (B, T, T)입니다.
torch.Size([4, 8, 8])weights[0]은 첫 번째 샘플의 Attention 행렬입니다. 이 행렬에서 각 행은 현재 위치를 뜻하고, 각 열은 참고하는 위치를 뜻합니다. causal mask가 적용되었으므로, 오른쪽 위 영역은 0에 가까운 값으로 채워져 있어야 합니다.
예를 들어 0번째 위치는 0번째 위치만 볼 수 있습니다. 그래서 첫 번째 행은 보통 이런 모양입니다.
[1.0000, 0.0000, 0.0000, 0.0000, ...]1번째 위치는 0번째와 1번째를 볼 수 있습니다.
[0.4213, 0.5787, 0.0000, 0.0000, ...]숫자는 실행할 때마다 달라질 수 있습니다. 중요한 것은 미래 위치의 값이 0이라는 점입니다.
Attention 언어 모델 만들기
이제 단일 Head를 언어 모델 안에 넣어 보겠습니다. 이전 장의 MLP 모델은 X 전체를 보고 마지막 정답 Y[:, -1]만 예측했습니다. 이번에는 더 GPT다운 방식으로 바꾸겠습니다.
입력 X의 각 위치에서 다음 토큰을 예측합니다.
X: 처 음   만 나 는
Y: 음   만 나 는
0번째 위치의 처는 다음 토큰 음을 예측합니다. 1번째 위치의 음은 다음 토큰 공백을 예측합니다. 2번째 위치의 공백은 다음 토큰 만을 예측합니다.
Self-Attention에 causal mask가 있기 때문에 각 위치는 자기보다 미래의 토큰을 보지 못합니다. 따라서 한 번의 forward로 모든 위치의 다음 토큰을 안전하게 예측할 수 있습니다.
전체 모델 코드는 다음과 같습니다.
class SingleHeadAttentionLanguageModel(nn.Module):
    def __init__(self, vocab_size, block_size, n_embd):
        super().__init__()
        self.block_size = block_size

        self.token_embedding_table = nn.Embedding(vocab_size, n_embd)
        self.position_embedding_table = nn.Embedding(block_size, n_embd)
        self.sa_head = Head(n_embd=n_embd, head_size=n_embd, block_size=block_size)
        self.lm_head = nn.Linear(n_embd, vocab_size)

    def forward(self, idx, targets=None):
        B, T = idx.shape

        tok_emb = self.token_embedding_table(idx)  # (B, T, C)
        pos = torch.arange(T, device=idx.device)
        pos_emb = self.position_embedding_table(pos)  # (T, C)

        x = tok_emb + pos_emb  # (B, T, C)
        x = self.sa_head(x)    # (B, T, C)
        logits = self.lm_head(x)  # (B, T, vocab_size)

        loss = None
        if targets is not None:
            B, T, V = logits.shape
            logits_flat = logits.view(B * T, V)
            targets_flat = targets.view(B * T)
            loss = F.cross_entropy(logits_flat, targets_flat)

        return logits, loss

    def generate(self, idx, max_new_tokens):
        for _ in range(max_new_tokens):
            idx_cond = idx[:, -self.block_size:]
            logits, loss = self(idx_cond)
            logits = logits[:, -1, :]
            probs = F.softmax(logits, dim=-1)
            idx_next = torch.multinomial(probs, num_samples=1)
            idx = torch.cat((idx, idx_next), dim=1)

return idxforward에서 가장 중요한 변화는 logits의 모양입니다.
이전 MLP 모델: logits = (B, vocab_size)
이번 Attention 모델: logits = (B, T, vocab_size)
이번 모델은 각 위치마다 다음 토큰 후보에 대한 점수를 출력합니다. 그래서 손실을 계산할 때는 B와 T를 하나로 펼칩니다.
logits_flat = logits.view(B * T, V)
targets_flat = targets.view(B * T)
loss = F.cross_entropy(logits_flat, targets_flat)
이렇게 하면 (B * T)개의 예측 문제를 한꺼번에 학습합니다. 이전 장의 MLP 모델보다 학습 신호를 더 풍부하게 사용하는 셈입니다.
학습 코드 바꾸기
이제 모델을 만들고 학습해 보겠습니다. 이전 장에서 만든 데이터 준비 코드와 get_batch 함수는 그대로 사용합니다.
torch.manual_seed(1337)

device = 'cuda' if torch.cuda.is_available() else 'cpu'

batch_size = 64
block_size = 16
max_iters = 3000
eval_interval = 300
eval_iters = 200
learning_rate = 1e-3
n_embd = 64

model = SingleHeadAttentionLanguageModel(vocab_size, block_size, n_embd)
model = model.to(device)

num_params = sum(p.numel() for p in model.parameters())
print(f'{num_params / 1e6:.3f}M parameters')
평가 함수는 이전 장과 거의 같지만, 이제 targets = Y[:, -1]를 만들지 않습니다. 전체 Y를 그대로 정답으로 사용합니다.
@torch.no_grad()
def estimate_loss():
    out = {}
    model.eval()

    for split in ['train', 'val']:
        losses = torch.zeros(eval_iters)

        for k in range(eval_iters):
            X, Y = get_batch(split)
            X = X.to(device)
            Y = Y.to(device)

            logits, loss = model(X, Y)
            losses[k] = loss.item()

        out[split] = losses.mean().item()

    model.train()
    return out
학습 루프도 단순합니다.
optimizer = torch.optim.AdamW(model.parameters(), lr=learning_rate)
history = []

for step in range(max_iters):
    if step % eval_interval == 0 or step == max_iters - 1:
        losses = estimate_loss()
        train_loss = losses['train']
        val_loss = losses['val']
        history.append((step, train_loss, val_loss))
        print(f'step {step}: train loss {train_loss:.4f}, val loss {val_loss:.4f}')

    X, Y = get_batch('train')
    X = X.to(device)
    Y = Y.to(device)

    logits, loss = model(X, Y)

    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()
실행하면 손실이 조금씩 내려가는 것을 볼 수 있습니다. 숫자는 데이터셋과 실행 환경에 따라 달라집니다.
step 0: train loss 4.2401, val loss 4.2389
step 300: train loss 2.7325, val loss 2.7694
step 600: train loss 2.5148, val loss 2.5812
step 900: train loss 2.4097, val loss 2.4920
이번 모델이 이전 MLP 모델보다 항상 더 좋은 결과를 낸다고 단정할 수는 없습니다. 아직 head가 하나뿐이고, Feed Forward Network도 없고, LayerNorm이나 Residual Connection도 없습니다. 하지만 중요한 구조적 변화가 생겼습니다. 이제 각 위치의 토큰이 앞 토큰들을 직접 바라보며 정보를 가져옵니다.
이것이 GPT의 심장부로 들어가는 첫 번째 문입니다.
생성해 보기
학습이 끝났다면 텍스트를 생성해 봅시다.
context = torch.zeros((1, 1), dtype=torch.long, device=device)
generated = model.generate(context, max_new_tokens=500)[0].tolist()

print(tokenizer.decode(generated))
만약 0번 토큰이 어색한 시작점이라면, 실제 학습 데이터의 앞부분을 시작 문맥으로 써도 좋습니다.
context = train_data[:block_size].unsqueeze(0).to(device)
generated = model.generate(context, max_new_tokens=500)[0].tolist()

print(tokenizer.decode(generated))
generate 함수에서 주목할 줄은 이것입니다.
idx_cond = idx[:, -self.block_size:]생성된 텍스트가 아무리 길어져도 모델은 한 번에 최대 block_size개의 토큰만 봅니다. 이것이 지금 우리가 만드는 작은 모델의 컨텍스트 윈도우입니다.
그리고 다음 줄도 중요합니다.
logits = logits[:, -1, :]모델은 모든 위치의 다음 토큰 점수를 출력합니다. 하지만 생성할 때 필요한 것은 가장 마지막 위치에서의 다음 토큰 점수입니다. 그래서 마지막 위치의 logits만 꺼내 softmax를 적용합니다.
probs = F.softmax(logits, dim=-1)
idx_next = torch.multinomial(probs, num_samples=1)
그다음 확률 분포에서 다음 토큰을 하나 샘플링합니다. 이 과정을 반복하면 텍스트가 한 토큰씩 이어집니다.
결과는 아직 엉성할 수 있습니다. 단어가 깨지고, 반복이 생기고, 문장이 이상하게 끝날 수 있습니다. 하지만 이제 모델 내부에서는 각 위치가 앞 토큰들을 참고하고 있습니다. 단순히 문맥을 펼쳐서 보는 것이 아니라, 위치마다 다른 방식으로 과거를 바라봅니다.
Attention weights 시각화하기
Self-Attention을 구현했다면 꼭 한 번은 Attention weight를 눈으로 확인해 보는 것이 좋습니다. 코드가 제대로 동작하는지 확인할 수 있고, 모델이 어떤 위치를 참고하는지도 어렴풋이 볼 수 있습니다.
먼저 검증 데이터에서 샘플 하나를 가져옵니다.
X, Y = get_batch('val')
idx = X[:1].to(device)  # 샘플 하나만 사용

print(idx.shape)
print(tokenizer.decode(idx[0].tolist()))
이제 모델 내부의 임베딩과 Attention head를 직접 통과시켜 weights를 얻습니다.
model.eval()

with torch.no_grad():
    B, T = idx.shape

    tok_emb = model.token_embedding_table(idx)
    pos = torch.arange(T, device=device)
    pos_emb = model.position_embedding_table(pos)
    x = tok_emb + pos_emb

    out, weights = model.sa_head(x, return_weights=True)

print(weights.shape)
출력은 다음과 같아야 합니다.
torch.Size([1, 16, 16])block_size가 16이라면 (1, 16, 16)입니다. 첫 번째 차원은 배치입니다. 지금 샘플 하나만 사용했으므로 1입니다. 뒤의 두 차원은 Attention 행렬입니다.
이제 matplotlib으로 그림을 그려 보겠습니다.
import matplotlib.pyplot as plt

att = weights[0].detach().cpu()
labels = [tokenizer.decode([int(i)]) for i in idx[0].detach().cpu().tolist()]

plt.figure(figsize=(7, 6))
plt.imshow(att, cmap='viridis')
plt.colorbar()

plt.xticks(range(T), labels, rotation=90)
plt.yticks(range(T), labels)
plt.xlabel('참고되는 토큰 위치')
plt.ylabel('현재 토큰 위치')
plt.title('Single Head Causal Self-Attention Weights')
plt.tight_layout()
plt.show()
그림에서 행은 현재 토큰 위치이고, 열은 참고되는 토큰 위치입니다. 어떤 행에서 특정 열이 밝다면, 그 현재 위치의 토큰이 해당 과거 위치를 비교적 많이 참고했다는 뜻입니다.
오른쪽 위 삼각형 영역은 어둡게 나와야 합니다. causal mask 때문에 미래 토큰을 볼 수 없기 때문입니다. 만약 오른쪽 위 영역에 값이 보인다면 마스크가 제대로 적용되지 않았을 가능성이 있습니다.
하삼각 마스크 자체도 그려 보면 이해가 더 쉽습니다.
mask = model.sa_head.tril[:T, :T].detach().cpu()

plt.figure(figsize=(5, 5))
plt.imshow(mask, cmap='gray')
plt.title('Causal Mask')
plt.xlabel('참고되는 토큰 위치')
plt.ylabel('현재 토큰 위치')
plt.show()
하얀 부분은 볼 수 있는 위치이고, 검은 부분은 볼 수 없는 위치입니다. Attention weight 그림도 이 구조를 따라야 합니다.
Attention 그림을 해석할 때 조심할 점
Attention weight를 보면 모델의 마음을 들여다보는 것 같은 느낌이 듭니다. 어떤 토큰이 어떤 토큰을 보는지 그림으로 나타나기 때문입니다. 하지만 너무 성급하게 해석하면 안 됩니다.
Attention weight는 모델이 정보를 섞는 한 과정입니다. 값이 높다고 해서 반드시 사람이 생각하는 의미에서 "중요하다"고 단정할 수는 없습니다. 특히 지금처럼 작은 문자 단위 모델에서는 더 그렇습니다. 모델이 단어 의미를 깊게 이해해서 특정 토큰을 보는 것이 아니라, 학습된 벡터 계산 결과로 어떤 위치에 가중치가 더 실린 것입니다.
그래도 Attention 시각화는 유용합니다. 다음을 확인할 수 있기 때문입니다.
causal mask가 제대로 적용되어 미래 토큰을 보지 않는지 확인할 수 있습니다.
특정 위치가 자기 자신만 보는지, 여러 과거 위치를 나누어 보는지 관찰할 수 있습니다.
학습 전후의 Attention 패턴이 어떻게 달라지는지 비교할 수 있습니다.
실험을 하나 해 보세요. 학습하기 전 모델의 Attention weight를 저장하고, 학습이 끝난 뒤 같은 입력에 대한 Attention weight를 다시 그려 보는 것입니다. 학습 전에는 거의 무작위에 가까운 패턴이 보일 수 있습니다. 학습 후에는 특정 위치나 가까운 과거 토큰에 조금 더 뚜렷한 패턴이 생길 수 있습니다.
물론 작은 모델과 작은 데이터에서는 결과가 극적으로 달라지지 않을 수도 있습니다. 괜찮습니다. 지금 중요한 것은 거대한 모델의 화려한 성능이 아니라, Attention이 실제로 어떤 계산을 하는지 손으로 만져 보는 경험입니다.
평균 내기와 Attention의 관계
Self-Attention을 처음 구현하면 wei @ v가 조금 낯설 수 있습니다. 이것을 아주 단순하게 말하면 가중 평균입니다.
예를 들어 어떤 위치의 Attention weight가 다음과 같다고 해 봅시다.
[0.1, 0.2, 0.7, 0.0]그러면 이 위치의 출력 벡터는 다음처럼 만들어집니다.
0.1 * 첫 번째 Value
+ 0.2 * 두 번째 Value
+ 0.7 * 세 번째 Value
+ 0.0 * 네 번째 Value
마지막 Value는 미래 토큰이라서 causal mask에 의해 0이 되었을 수 있습니다. 즉 현재 위치는 볼 수 있는 과거 토큰들의 Value를 비율에 따라 섞습니다.
이 관점에서 보면 Attention은 어려운 마법이 아닙니다.
1. 각 토큰에서 Query, Key, Value를 만든다.
2. Query와 Key를 비교해 참고 점수를 만든다.
3. 미래 위치를 마스크로 막는다.
4. softmax로 가중치를 만든다.
5. 그 가중치로 Value를 섞는다.
이 다섯 단계가 Self-Attention의 핵심입니다.
작은 모델이 얻은 것과 아직 없는 것
이번 장에서 만든 모델은 이전 장의 MLP 모델보다 GPT에 더 가까워졌습니다. 특히 다음 변화가 중요합니다.
첫째, 각 위치가 자기보다 앞에 있는 토큰들을 직접 참고합니다. MLP처럼 문맥 전체를 납작하게 펼쳐 넣는 대신, 위치마다 다른 Attention 분포를 계산합니다.
둘째, 한 번의 forward로 모든 위치의 다음 토큰을 예측합니다. logits의 모양이 (B, T, vocab_size)가 되었고, targets 전체를 사용해 손실을 계산합니다. 이것은 실제 GPT식 언어 모델 학습 흐름과 가까운 방식입니다.
셋째, causal mask를 통해 미래 정보 누수를 막았습니다. 이 부분은 언어 모델에서 매우 중요합니다. 마스크가 없다면 모델은 정답에 해당하는 미래 토큰을 훔쳐볼 수 있고, 학습 손실은 낮아져도 실제 생성에서는 제대로 작동하지 않을 수 있습니다.
하지만 아직 부족한 점도 많습니다.
지금 모델에는 head가 하나뿐입니다. 하나의 Attention head는 한 가지 관점으로만 토큰 관계를 봅니다. 어떤 head는 가까운 글자 연결을 보고, 어떤 head는 문장 부호를 보고, 어떤 head는 더 먼 참조를 보는 식의 다양한 관점은 아직 없습니다.
또 Feed Forward Network가 없습니다. Attention이 토큰 사이의 정보를 섞는 역할을 한다면, Feed Forward Network는 각 위치의 표현을 더 풍부하게 변환하는 역할을 합니다. 실제 Transformer Block에는 Attention과 Feed Forward Network가 함께 들어갑니다.
LayerNorm과 Residual Connection도 아직 없습니다. 이 둘은 깊은 모델을 안정적으로 학습시키는 데 중요합니다. 지금처럼 작은 모델에서는 없어도 어느 정도 실행되지만, 여러 층을 쌓기 시작하면 반드시 필요해집니다.
그래도 괜찮습니다. 우리는 가장 중요한 부품 하나를 직접 만들었습니다. 이제 이 부품을 여러 개의 head로 확장하고, 다시 Transformer Block으로 감싸면 Mini GPT의 모습이 점점 드러납니다.
디버깅 체크리스트
Self-Attention 구현에서 오류가 나면 대부분 텐서 모양이나 장치 문제입니다. 다음 항목을 차례대로 확인해 보세요.
x의 모양이(B, T, C)인지 확인합니다.q @ k.transpose(-2, -1)의 결과가(B, T, T)인지 확인합니다.self.tril[:T, :T]의 모양이(T, T)인지 확인합니다.wei @ v의 결과가(B, T, head_size)인지 확인합니다.model.to(device)를 호출했는지, 입력X,Y도 같은device로 옮겼는지 확인합니다.
특히 view를 사용할 때 오류가 난다면 텐서가 메모리상 연속적이지 않아서일 수 있습니다. 이 경우에는 reshape를 사용해도 됩니다.
logits_flat = logits.reshape(B * T, V)
targets_flat = targets.reshape(B * T)view와 reshape는 비슷하지만, reshape가 조금 더 유연합니다. 실습 중 모양 변경에서 문제가 생기면 reshape로 바꿔 보세요.
정리
이번 장에서는 단일 head causal Self-Attention을 PyTorch로 직접 구현했습니다. 입력 텐서의 (B, T, C) 차원을 해석하고, 선형층으로 Query, Key, Value를 만들었습니다. 그런 다음 Query와 Key의 점곱으로 Attention score를 계산하고, sqrt(head_size)로 나누어 스케일을 조절했습니다.
또 하삼각 causal mask를 적용해 미래 토큰을 보지 못하게 막았습니다. softmax로 Attention weight를 만든 뒤, 그 가중치로 Value를 섞어 각 위치의 새로운 표현을 만들었습니다.
마지막으로 이 Head를 작은 언어 모델에 넣어 학습하고, Attention weight를 시각화했습니다. 이제 Attention은 더 이상 추상적인 수식이 아닙니다. 우리가 직접 작성한 몇 줄의 행렬 연산입니다.
다음 장에서는 이 단일 head를 여러 개로 늘립니다. 하나의 관점으로 문맥을 보는 대신, 여러 관점이 동시에 토큰 관계를 바라보게 만들 것입니다. 그것이 Multi-Head Attention입니다.
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.