


Bigram에서 작은 신경망으로
이전 장에서 만든 Bigram 모델은 놀랄 만큼 단순했습니다. 현재 글자 하나를 보고 다음 글자를 예측했습니다. 예를 들어 현재 글자가 합이면 다음에 어떤 글자가 올지, 현재 글자가 니이면 다음에 어떤 글자가 올지 확률표를 하나씩 배운 셈입니다.
그런데 여기에는 중요한 한계가 있었습니다. block_size를 8이나 16으로 늘려도 Bigram 모델은 긴 문맥을 제대로 활용하지 못했습니다. 입력 x의 모양이 (batch_size, block_size)가 되더라도, 모델 내부에서는 각 위치의 토큰을 거의 독립적으로 처리했기 때문입니다. 말하자면 책상 위에 여덟 글자를 올려놓았지만, 모델은 여전히 그중 마지막 글자 하나만 흘끗 보는 학생과 비슷했습니다.
이번 장에서는 그 한계를 한 걸음 넘어섭니다. 이제 모델은 글자 하나가 아니라 block_size만큼의 이전 토큰을 한꺼번에 입력으로 받습니다. 그리고 그 전체 문맥을 이용해 다음 토큰 하나를 예측합니다.
여기서 만드는 모델은 아직 GPT가 아닙니다. Attention도 없고 Transformer Block도 없습니다. 대신 아주 작은 신경망, 즉 MLP를 사용합니다. MLP는 Multi-Layer Perceptron의 줄임말로, 여러 개의 선형 계층과 비선형 함수를 쌓은 기본적인 신경망입니다. 이름은 조금 낯설지만 원리는 단순합니다. 입력 숫자들을 섞고, 눌렀다 펴고, 다시 섞어서 원하는 출력 점수를 만드는 장치입니다.
하지만 이 작은 변화만으로도 모델은 Bigram보다 훨씬 흥미로운 일을 하기 시작합니다. 한 글자만 보던 모델이 이제 몇 글자의 흐름을 보기 시작하기 때문입니다.
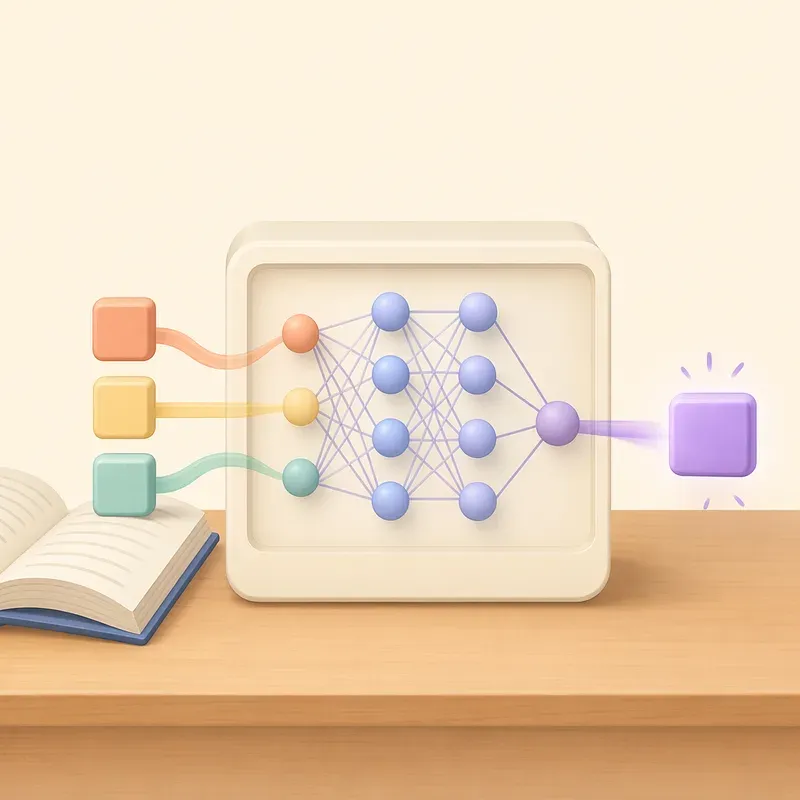
이번 장에서 만들 모델의 전체 흐름
이번 장의 모델은 다음 순서로 동작합니다.
block_size길이의 토큰 ID 묶음을 입력으로 받습니다.각 토큰 ID를 토큰 임베딩 벡터로 바꿉니다.
각 위치에 해당하는 위치 임베딩을 더합니다.
모든 위치의 벡터를 하나로 펼쳐 MLP에 넣습니다.
MLP가 다음 토큰에 대한
logits를 출력합니다.
logits는 softmax를 거치기 전의 원점수입니다. 예를 들어 어휘 사전에 50개의 글자가 있다면, 모델은 다음 글자로 올 수 있는 50개 후보 각각에 점수를 매깁니다. 그 점수를 확률로 바꾸면 다음 글자를 샘플링할 수 있습니다.
Bigram 모델과 가장 큰 차이는 입력입니다. Bigram은 현재 토큰 하나에서 바로 다음 토큰 점수를 만들었습니다. 이번 모델은 여러 토큰의 임베딩을 한꺼번에 보고 다음 토큰 점수를 만듭니다.
간단히 말하면 Bigram은 이렇게 묻습니다.
지금 글자가 무엇인가?
이번 장의 MLP 모델은 이렇게 묻습니다.
방금 지나온 몇 글자의 흐름이 무엇인가?
질문이 바뀌면 모델이 배울 수 있는 것도 바뀝니다.
학습 데이터 다시 보기: 정답은 마지막 y
이전 장에서 만든 get_batch 함수를 떠올려 봅시다. 이 함수는 입력 x와 정답 y를 함께 반환했습니다.
X, Y = get_batch('train')

print(X.shape)
print(Y.shape)
print(X[0])
print(Y[0])block_size가 8이라면 X[0]에는 연속된 8개의 토큰이 들어 있습니다. Y[0]에는 그보다 한 칸씩 밀린 정답 토큰들이 들어 있습니다.
예를 들어 데이터가 다음과 같이 이어진다고 해 봅시다.
처음 만나는 LLM문자 단위 토큰화에서는 각 글자가 하나의 토큰이 됩니다. 어떤 위치에서 block_size만큼 잘라 입력을 만들면 다음과 같은 관계가 됩니다.
입력 X:  처 음   만 나 는
정답 Y:  음   만 나 는
실제 데이터에서는 공백도 하나의 문자 토큰이므로 함께 포함됩니다. 핵심은 Y가 X보다 한 칸 앞선 미래라는 점입니다.
Bigram 모델에서는 X의 각 위치마다 다음 토큰을 예측했습니다. 그래서 X[:, 0]은 Y[:, 0]을, X[:, 1]은 Y[:, 1]을 예측했습니다.
이번 장의 MLP 모델은 조금 다르게 사용하겠습니다. X 전체를 보고 마지막 정답만 예측합니다.
X, Y = get_batch('train')
targets = Y[:, -1]

print(X.shape)
print(targets.shape)
print('target for this chapter:', targets[0])
여기서 targets = Y[:, -1]이 중요합니다. X가 길이 8짜리 문맥이라면, Y[:, -1]은 그 문맥 바로 다음에 오는 토큰입니다. 즉 모델은 8개의 이전 글자를 보고 9번째 글자를 맞히는 문제를 푸는 것입니다.
이 방식은 나중에 만들 GPT보다 계산 효율이 떨어집니다. GPT는 한 번의 forward 과정에서 각 위치의 다음 토큰을 모두 예측할 수 있습니다. 반면 이번 MLP 모델은 전체 문맥을 보고 마지막 다음 토큰 하나만 맞힙니다. 하지만 원리를 이해하기에는 이 방식이 훨씬 직관적입니다.
먼저 문맥을 실제로 사용한다는 감각을 잡고, 다음 장에서 Self-Attention으로 더 강력한 방식으로 넘어가면 됩니다.
토큰 임베딩과 위치 임베딩을 더한다는 것
이전 장의 Bigram 모델에서는 토큰 ID를 바로 다음 토큰 점수표로 바꾸었습니다. 이번에는 중간에 임베딩을 둡니다.
토큰 임베딩은 토큰 ID를 벡터로 바꾸는 표입니다. 예를 들어 니라는 글자의 ID가 17이라면, 임베딩 테이블의 17번째 줄에서 그 글자에 해당하는 벡터를 꺼냅니다.
하지만 토큰만으로는 부족합니다. 같은 글자라도 어디에 놓였는지가 중요하기 때문입니다. 다라는 글자가 문장 중간에 있을 때와 문장 끝에 있을 때는 역할이 다를 수 있습니다. 그래서 위치 임베딩을 함께 사용합니다.
위치 임베딩은 다음과 같은 정보를 담습니다.
0번째 위치의 벡터
1번째 위치의 벡터
2번째 위치의 벡터
...
block_size - 1번째 위치의 벡터
각 토큰 표현은 다음처럼 만들어집니다.
최종 입력 벡터 = 토큰 임베딩 + 위치 임베딩왜 더할까요? 두 벡터의 차원이 같기 때문입니다. 토큰 임베딩이 무엇에 대한 정보라면, 위치 임베딩은 어디에 대한 정보입니다. 둘을 더하면 모델은 각 위치에서 어떤 토큰이 등장했는지 함께 볼 수 있습니다.
사실 이번 장의 MLP는 모든 위치의 임베딩을 펼쳐서 넣기 때문에, 어느 정도는 위치 정보가 암묵적으로 들어갑니다. 첫 번째 슬롯에 들어간 벡터와 두 번째 슬롯에 들어간 벡터는 서로 다른 입력 자리로 들어가기 때문입니다. 그럼에도 위치 임베딩을 명시적으로 더하는 이유가 있습니다. 곧 만들 GPT 구조에서도 토큰 임베딩과 위치 임베딩을 더하는 방식이 기본 흐름이기 때문입니다.
이번 장은 단순한 MLP 실습이면서 동시에 GPT의 입력부를 미리 연습하는 장입니다.
작은 MLP 언어 모델 구현하기
이제 코드를 작성해 보겠습니다. 이전 장에서 만든 데이터 준비 코드, CharTokenizer, train_data, val_data, get_batch, vocab_size를 그대로 사용한다고 가정합니다.
먼저 필요한 설정값을 정합니다.
import torch
import torch.nn as nn
from torch.nn import functional as F

torch.manual_seed(1337)

device = 'cuda' if torch.cuda.is_available() else 'cpu'

batch_size = 64
block_size = 16
max_iters = 3000
eval_interval = 300
eval_iters = 200
learning_rate = 1e-3

n_embd = 64
hidden_size = 256
여기서 block_size는 모델이 볼 문맥 길이입니다. Bigram에서는 이 값을 늘려도 모델 구조상 큰 의미가 없었습니다. 하지만 이번 모델에서는 다릅니다. block_size가 16이면 모델은 이전 16개의 토큰을 보고 다음 토큰을 예측합니다.
n_embd는 토큰 하나를 몇 차원 벡터로 표현할지 정하는 값입니다. hidden_size는 MLP 내부의 은닉층 크기입니다. 두 값이 커질수록 모델의 표현력은 좋아질 수 있지만, 계산량과 과적합 가능성도 함께 커집니다.
이제 모델 클래스를 만듭니다.
class MLPCharLanguageModel(nn.Module):
    def __init__(self, vocab_size, block_size, n_embd, hidden_size):
        super().__init__()
        self.block_size = block_size

        self.token_embedding_table = nn.Embedding(vocab_size, n_embd)
        self.position_embedding_table = nn.Embedding(block_size, n_embd)

        self.net = nn.Sequential(
            nn.Linear(block_size * n_embd, hidden_size),
            nn.GELU(),
            nn.Linear(hidden_size, vocab_size),
        )

    def forward(self, idx, targets=None):
        B, T = idx.shape

        if T != self.block_size:
            raise ValueError(f'idx must have shape (B, {self.block_size})')

        tok_emb = self.token_embedding_table(idx)
        pos = torch.arange(T, device=idx.device)
        pos_emb = self.position_embedding_table(pos)

        x = tok_emb + pos_emb

        B, T, C = x.shape
        x = x.reshape(B, T * C)

        logits = self.net(x)

        loss = None
        if targets is not None:
            loss = F.cross_entropy(logits, targets)

        return logits, loss

    def generate(self, idx, max_new_tokens):
        for _ in range(max_new_tokens):
            idx_cond = idx[:, -self.block_size:]
            logits, loss = self(idx_cond)
            probs = F.softmax(logits, dim=-1)
            idx_next = torch.multinomial(probs, num_samples=1)
            idx = torch.cat((idx, idx_next), dim=1)

        return idx
코드를 천천히 보겠습니다.
self.token_embedding_table = nn.Embedding(vocab_size, n_embd)이 줄은 토큰 ID를 임베딩 벡터로 바꿉니다. 입력 idx의 모양이 (B, T)라면, 토큰 임베딩 결과 tok_emb의 모양은 (B, T, C)가 됩니다. 여기서 B는 배치 크기, T는 문맥 길이, C는 임베딩 차원입니다.
self.position_embedding_table = nn.Embedding(block_size, n_embd)이 줄은 위치 번호를 임베딩 벡터로 바꿉니다. 위치는 0부터 block_size - 1까지입니다.
x = tok_emb + pos_emb토큰 정보와 위치 정보를 더합니다. 이때 tok_emb는 (B, T, C)이고 pos_emb는 (T, C)입니다. PyTorch는 pos_emb를 배치 차원으로 자동 확장해 더해 줍니다.
x = x.reshape(B, T * C)이 줄은 여러 위치의 벡터를 한 줄로 펼칩니다. 예를 들어 block_size가 16이고 n_embd가 64라면, 한 샘플은 16 * 64 = 1024차원짜리 벡터가 됩니다.
그 벡터가 MLP를 통과합니다.
logits = self.net(x)최종 출력 logits의 모양은 (B, vocab_size)입니다. 각 샘플마다 다음 토큰 후보 전체에 대한 점수가 하나씩 나옵니다.
모델을 만들고 파라미터 수 확인하기
모델을 생성해 봅시다.
model = MLPCharLanguageModel(vocab_size, block_size, n_embd, hidden_size)
model = model.to(device)

num_params = sum(p.numel() for p in model.parameters())
print(f'{num_params / 1e6:.3f}M parameters')
이 모델은 여전히 매우 작습니다. 하지만 Bigram보다 훨씬 많은 파라미터를 가집니다. Bigram 모델이 토큰 하나에서 다음 토큰 점수로 바로 가는 단순한 표였다면, 이번 모델은 여러 토큰의 임베딩을 조합해 다음 토큰을 예측합니다.
파라미터 수는 대략 다음 요소에 의해 결정됩니다.
어휘 사전 크기와 임베딩 차원
문맥 길이와 임베딩 차원
MLP 은닉층 크기
최종 출력으로 예측해야 하는 어휘 사전 크기
문맥 길이를 늘리면 입력 벡터가 길어집니다. 입력 벡터가 길어지면 첫 번째 선형 계층의 파라미터도 늘어납니다. 따라서 block_size를 늘리는 일은 공짜가 아닙니다.
학습 손실과 검증 손실 기록하기
이제 학습 루프를 작성하겠습니다. 이번에는 학습 손실뿐 아니라 검증 손실도 함께 기록해 보겠습니다. 학습 손실은 모델이 훈련 데이터에 얼마나 잘 맞는지 보여 줍니다. 검증 손실은 처음 보는 데이터에도 잘 맞는지 보여 줍니다.
@torch.no_grad()
def estimate_loss():
    out = {}
    model.eval()

    for split in ['train', 'val']:
        losses = torch.zeros(eval_iters)

        for k in range(eval_iters):
            X, Y = get_batch(split)
            X = X.to(device)
            Y = Y.to(device)

            targets = Y[:, -1]
            logits, loss = model(X, targets)
            losses[k] = loss.item()

        out[split] = losses.mean().item()

    model.train()
return out@torch.no_grad()는 평가할 때 기울기를 계산하지 않겠다는 뜻입니다. 학습이 아니라 손실을 재는 과정이므로 불필요한 계산을 줄일 수 있습니다.
여기서 다시 한 번 중요한 줄을 봅시다.
targets = Y[:, -1]모델은 X 전체를 보고 그 다음 토큰 하나를 예측합니다. 그래서 정답도 각 샘플의 마지막 정답 토큰만 사용합니다.
이제 실제 학습 루프입니다.
optimizer = torch.optim.AdamW(model.parameters(), lr=learning_rate)
history = []

for step in range(max_iters):
    if step % eval_interval == 0 or step == max_iters - 1:
        losses = estimate_loss()
        train_loss = losses['train']
        val_loss = losses['val']
        history.append((step, train_loss, val_loss))
        print(f'step {step}: train loss {train_loss:.4f}, val loss {val_loss:.4f}')

    X, Y = get_batch('train')
    X = X.to(device)
    Y = Y.to(device)

    targets = Y[:, -1]
    logits, loss = model(X, targets)

    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()
이전 장의 학습 루프와 거의 비슷하지만, 이번에는 targets = Y[:, -1]만 사용한다는 점이 다릅니다.
학습을 실행하면 대략 다음과 같은 로그가 나올 수 있습니다. 숫자는 데이터셋, 어휘 크기, 하이퍼파라미터에 따라 달라집니다.
step 0: train loss 4.1842, val loss 4.1899
step 300: train loss 2.6210, val loss 2.6847
step 600: train loss 2.3275, val loss 2.4568
step 900: train loss 2.1372, val loss 2.3821
step 1200: train loss 1.9844, val loss 2.3650
step 1500: train loss 1.8502, val loss 2.3895
처음에는 학습 손실과 검증 손실이 함께 내려갑니다. 모델이 데이터의 기본 패턴을 배우고 있다는 뜻입니다. 그런데 어느 순간부터 학습 손실은 계속 내려가는데 검증 손실은 멈추거나 올라갈 수 있습니다. 이것이 과적합의 신호입니다.
과적합은 모델이 훈련 데이터를 너무 잘 외워서, 처음 보는 데이터에는 오히려 약해지는 현상입니다. 작은 데이터셋에 비해 모델이 너무 크거나, 너무 오래 학습하거나, 문맥 길이를 지나치게 늘리면 쉽게 나타납니다.
생성 결과 확인하기
학습이 끝났다면 텍스트를 생성해 봅시다. 이번 모델은 block_size 길이의 문맥을 필요로 합니다. 따라서 시작 입력도 최소한 block_size 길이로 준비하는 편이 좋습니다.
context = train_data[:block_size].unsqueeze(0).to(device)
generated = model.generate(context, max_new_tokens=500)[0].tolist()

print(tokenizer.decode(generated))
Bigram 모델은 시작 토큰 하나만 있어도 다음 토큰을 생성할 수 있었습니다. 하지만 이번 MLP 모델은 고정된 길이의 문맥을 입력으로 받습니다. 그래서 생성할 때도 매번 마지막 block_size개의 토큰을 잘라 모델에 넣습니다.
idx_cond = idx[:, -self.block_size:]이 한 줄이 생성 과정의 핵심입니다. 지금까지 생성된 전체 텍스트 중에서 가장 최근 block_size개만 보고 다음 토큰을 예측합니다.
생성 결과는 아직 자연스럽지 않을 수 있습니다. 단어가 깨지거나, 문장 구조가 이상하거나, 같은 패턴이 반복될 수 있습니다. 그래도 Bigram과 비교하면 차이를 느낄 수 있습니다. 특히 문자 단위 데이터에서는 몇 글자짜리 조각이 더 그럴듯하게 이어지는 경우가 늘어납니다.
예를 들어 한국어 데이터라면 모델은 다음과 같은 짧은 흐름을 조금씩 배울 수 있습니다.
습니다음에는다가 자주 온다.문장 끝의
다다음에는 줄바꿈이나 공백이 올 수 있다.특정 조사나 어미 앞뒤에는 자주 함께 등장하는 글자가 있다.
물론 이것은 진짜 의미 이해가 아닙니다. 모델은 여전히 문자 패턴을 통계적으로 배우고 있습니다. 하지만 한 글자만 보던 Bigram보다 더 긴 조각을 보기 때문에, 더 긴 리듬과 반복 구조를 흉내 낼 수 있습니다.
손실 숫자를 어떻게 해석할까
언어 모델의 학습 로그를 처음 보면 손실 값이 조금 추상적으로 느껴집니다. 손실이 2.3이라는 말은 정확히 무엇일까요?
우리가 사용하는 cross_entropy 손실은 모델이 정답 토큰에 얼마나 높은 확률을 주었는지를 측정합니다. 정답에 높은 확률을 줄수록 손실은 낮아집니다. 정답에 낮은 확률을 주면 손실은 높아집니다.
무작위로 찍는 모델을 생각해 봅시다. 어휘 사전에 50개의 토큰이 있고, 모델이 모든 토큰에 같은 확률을 준다면 정답 확률은 1/50입니다. 이때 손실은 꽤 큽니다. 학습이 진행되면서 모델이 자주 나오는 패턴을 배우면 정답 토큰에 더 높은 확률을 주게 되고, 손실은 내려갑니다.
하지만 학습 손실 하나만 보면 안 됩니다. 반드시 검증 손실을 함께 봐야 합니다.
학습 손실 감소 + 검증 손실 감소 = 일반적인 학습 진행
학습 손실 감소 + 검증 손실 정체 = 슬슬 과적합 가능성
학습 손실 감소 + 검증 손실 증가 = 과적합 신호가 강함
실전에서는 손실 로그를 history에 저장해 두고 그래프로 그려 보면 더 잘 보입니다. 그래프에서 두 선이 함께 내려가다가 검증 손실이 먼저 멈추는 지점이 보일 것입니다. 그 지점 이후로는 모델이 훈련 데이터의 세부 패턴을 외우기 시작했을 가능성이 큽니다.
세 개의 손잡이: 모델 크기, 문맥 길이, 데이터 크기
이번 모델에서 생성 품질에 큰 영향을 주는 손잡이는 크게 세 가지입니다.
block_size: 모델이 한 번에 볼 수 있는 문맥 길이입니다. 너무 짧으면 긴 패턴을 볼 수 없고, 너무 길면 계산량이 커지며 작은 데이터에서는 오히려 학습이 어려워질 수 있습니다.n_embd와hidden_size: 모델의 표현력을 결정합니다. 값을 키우면 더 복잡한 패턴을 배울 수 있지만, 데이터가 부족하면 과적합되기 쉽습니다.학습 데이터 크기: 언어 모델은 데이터에서 패턴을 배웁니다. 데이터가 적으면 모델이 배울 수 있는 문장 리듬과 표현이 제한됩니다.
이 세 가지는 서로 연결되어 있습니다. 문맥 길이를 늘리면 모델 입력이 커집니다. 입력이 커지면 더 큰 MLP가 필요할 수 있습니다. 모델이 커지면 더 많은 데이터가 필요합니다. 데이터가 부족한데 모델만 키우면 훈련 데이터는 잘 맞추지만 새로운 문장은 어색하게 생성할 가능성이 큽니다.
그래서 좋은 실험 순서는 무작정 크게 만드는 것이 아닙니다. 먼저 작은 설정으로 학습이 제대로 되는지 확인합니다. 그다음 하나씩 바꿔 봅니다.
예를 들어 다음 순서로 실험할 수 있습니다.
# 실험 1
block_size = 8
n_embd = 32
hidden_size = 128

# 실험 2
block_size = 16
n_embd = 64
hidden_size = 256

# 실험 3
block_size = 32
n_embd = 64
hidden_size = 512
각 실험에서 학습 손실, 검증 손실, 생성 결과를 함께 비교해 보세요. 손실이 낮다고 항상 사람이 보기에 좋은 문장이 나오는 것은 아닙니다. 반대로 생성 결과가 조금 재미있어 보여도 검증 손실이 나쁘면 일반화가 잘 안 되고 있을 수 있습니다.
언어 모델 실험에서는 숫자와 샘플을 함께 보는 습관이 중요합니다.
Bigram보다 무엇이 나아졌을까
Bigram 모델은 바로 앞 글자 하나만 보았습니다. 그래서 니 다음에 다가 자주 온다는 정도는 배울 수 있지만, 더 긴 조건은 배우기 어렵습니다.
이번 MLP 모델은 block_size 길이의 문맥을 봅니다. 그래서 다음과 같은 패턴을 더 잘 배울 수 있습니다.
몇 글자에 걸친 자주 나오는 어미나 표현
공백, 쉼표, 마침표, 줄바꿈의 반복 리듬
특정 글자 조합 뒤에 자주 등장하는 다음 글자
짧은 단어 조각이나 문장 조각의 흐름
문자 단위 모델에서 이것은 꽤 큰 차이입니다. 한글은 음절 단위 글자가 모여 단어를 만들고, 단어가 모여 문장을 만듭니다. Bigram이 음절 하나 사이의 연결만 본다면, MLP 모델은 짧은 단어 조각에 가까운 흐름을 볼 수 있습니다.
물론 아직 갈 길은 멉니다. 이 모델은 문장의 의미를 깊게 파악하지 못합니다. 등장인물을 기억하거나, 앞에서 말한 내용을 뒤에서 일관되게 이어 가기도 어렵습니다. 문맥을 본다고는 하지만, 그 문맥을 아주 단순한 방식으로 펼쳐서 MLP에 넣을 뿐입니다.
그래도 중요한 문턱을 넘었습니다. 이제 우리는 단순한 확률표가 아니라, 임베딩과 신경망을 이용해 문맥에서 다음 토큰을 예측하는 모델을 만들었습니다.
이 모델의 한계
이번 장의 MLP 모델은 Bigram보다 강력하지만 구조적인 한계가 분명합니다.
첫째, 문맥 길이가 고정되어 있습니다. block_size가 16이면 항상 16개 토큰을 입력으로 받아야 합니다. 더 짧은 문맥이나 더 긴 문맥을 유연하게 다루기 어렵습니다.
둘째, 입력을 단순히 펼칩니다. 16개 위치의 임베딩을 하나의 긴 벡터로 만든 뒤 MLP에 넣습니다. 이 방식은 각 토큰이 서로 어떤 관계를 맺는지 직접 계산하지 않습니다. 첫 번째 토큰과 열다섯 번째 토큰이 중요한 관계인지, 세 번째 토큰과 네 번째 토큰이 붙어 봐야 하는 관계인지 모델이 명시적으로 비교하지 않습니다.
셋째, 문맥이 길어질수록 첫 번째 선형 계층이 빠르게 커집니다. block_size * n_embd가 입력 크기이므로, 문맥을 두 배로 늘리면 MLP 입력도 두 배로 늘어납니다. 긴 문맥을 다루기에는 비효율적입니다.
넷째, 이번 모델은 입력 문맥 전체로 마지막 다음 토큰 하나만 예측합니다. 학습 데이터 안에는 각 위치마다 다음 토큰을 예측할 수 있는 정보가 들어 있지만, 우리는 그중 마지막 하나만 사용했습니다. 원리를 이해하기에는 좋지만, 학습 효율은 좋지 않습니다.
이 한계를 해결하기 위해 다음 장부터 Self-Attention을 직접 구현합니다. Self-Attention은 각 토큰이 같은 문장 안의 다른 토큰을 바라보며, 어떤 정보를 가져올지 계산하는 방법입니다.
MLP 모델이 문맥을 통째로 눌러서 보는 방식이라면, Self-Attention은 문맥 안의 토큰들이 서로 대화하게 만드는 방식입니다.
정리
이번 장에서는 Bigram 모델을 넘어 작은 신경망 언어 모델을 만들었습니다. 핵심은 block_size만큼의 이전 토큰을 실제 입력으로 사용했다는 점입니다. 토큰 ID를 임베딩 벡터로 바꾸고, 위치 임베딩을 더한 뒤, 모든 위치의 벡터를 펼쳐 MLP에 넣었습니다. 모델은 그 결과로 다음 토큰의 logits를 출력했습니다.
또 학습 손실과 검증 손실을 함께 기록하면서 과적합을 관찰하는 방법도 살펴보았습니다. 학습 손실만 내려가는 것은 충분하지 않습니다. 검증 손실이 함께 좋아져야 모델이 새로운 텍스트에도 쓸 만한 패턴을 배웠다고 볼 수 있습니다.
이제 모델은 한 글자만 보는 수준을 벗어났습니다. 작은 문맥의 흐름을 보고 다음 글자를 예측합니다. 하지만 아직 토큰 사이의 관계를 정교하게 계산하지는 못합니다.
다음 장에서는 이 문제를 해결하는 핵심 아이디어, Self-Attention을 직접 구현합니다. 그때부터 우리가 만드는 모델은 점점 GPT의 모습에 가까워지기 시작합니다.
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.