


LangGraph로 상태ful 워크플로와 멀티 에이전트 설계하기
체인이 길어질 때 생기는 문제
앞 장에서 우리는 LangChain 에이전트를 만들었습니다. 모델은 질문을 읽고, 필요한 도구를 고르고, 도구 결과를 다시 읽은 뒤 답을 만들었습니다. 단순한 업무라면 이 방식만으로도 충분합니다. 그러나 실제 제품으로 들어가면 흐름이 금방 복잡해집니다.
고객 지원 에이전트를 떠올려 보겠습니다. 사용자가 환불을 요청합니다. 에이전트는 주문 정보를 조회해야 하고, 환불 정책을 확인해야 하며, 금액이 크면 담당자의 승인을 받아야 합니다. 재고 문제라면 물류 시스템을 조회하고, 법적 이슈가 있으면 별도 팀으로 넘겨야 합니다. 중간에 API가 실패하면 재시도해야 하고, 사용자가 브라우저를 닫았다가 다시 들어와도 이전 상태를 이어 가야 합니다.
이런 순간부터 우리는 단순한 '모델 호출'이 아니라 '업무 흐름'을 설계하고 있는 것입니다. LangGraph는 바로 이 지점에서 등장합니다. LangGraph는 장기 실행되고 상태를 보존해야 하는 에이전트와 워크플로를 그래프 형태로 만들기 위한 낮은 수준의 오케스트레이션 프레임워크입니다.1 여기서 오케스트레이션이란 여러 작업 단계를 어떤 순서로 실행하고, 언제 멈추고, 어디로 분기하고, 실패했을 때 어떻게 복구할지를 조율하는 일을 뜻합니다.
LangChain이 모델, 프롬프트, 파서, 리트리버, 도구 같은 부품을 잘 연결하게 해 준다면, LangGraph는 그 부품들이 복잡한 업무 안에서 어떻게 움직일지를 명시적으로 그리게 해 줍니다. 비유하자면 LangChain은 좋은 악기와 연주자를 제공하고, LangGraph는 악보와 지휘 체계를 제공합니다.
워크플로와 에이전트의 차이
LangGraph를 이해하려면 먼저 워크플로와 에이전트를 구분해야 합니다. 워크플로는 정해진 코드 경로를 따릅니다. 예를 들어 '문서 읽기 → 요약하기 → 번역하기 → 저장하기'처럼 순서가 미리 정해져 있습니다. 입력이 달라도 전체 흐름은 크게 바뀌지 않습니다.
반면 에이전트는 실행 중에 다음 행동을 고릅니다. 검색할지, 계산할지, 사용자에게 되물을지, 답변을 마무리할지를 모델이 상황에 따라 판단합니다. LangChain 문서에서도 워크플로는 미리 정해진 경로를 따르고, 에이전트는 도구 사용과 절차를 동적으로 결정한다고 설명합니다.2
현실의 AI 애플리케이션은 둘 중 하나로만 딱 떨어지지 않습니다. 환불 처리처럼 정책상 반드시 거쳐야 하는 단계도 있고, 사용자 질문에 따라 도구를 선택해야 하는 자율적인 구간도 있습니다. 그래서 좋은 설계는 보통 다음과 같은 혼합형이 됩니다.
정해진 업무 규칙은 워크플로로 고정합니다.
모델의 판단이 필요한 부분은 에이전트 노드로 둡니다.
위험한 행동 앞에는 승인 노드나 검증 노드를 둡니다.
실패 가능성이 큰 작업은 재시도와 종료 조건을 그래프에 명시합니다.
LangGraph의 장점은 이 혼합 구조를 코드로 또렷하게 표현할 수 있다는 데 있습니다. 실행 흐름이 머릿속에만 있지 않고, 노드와 엣지로 드러납니다.
LangGraph의 세 가지 기본 요소
LangGraph의 핵심은 StateGraph입니다. 이름 그대로 상태를 중심으로 움직이는 그래프입니다. 그래프 안의 모든 노드는 같은 상태 객체를 읽고, 자신이 바꿀 부분만 업데이트해서 반환합니다. LangGraph 공식 문서는 상태를 TypedDict, Pydantic 모델, dataclass 등으로 정의할 수 있고, 각 노드는 상태를 입력받아 업데이트를 반환한다고 설명합니다.3
가장 중요한 구성요소는 세 가지입니다.
상태 State: 그래프 전체가 공유하는 데이터입니다. 메시지 이력, 검색 결과, 현재 단계, 재시도 횟수, 최종 답변 같은 값이 들어갑니다.
노드 Node: 실제 작업을 수행하는 함수입니다. LLM 호출, 도구 실행, 검색, 검증, 사용자 승인 요청 등이 노드가 될 수 있습니다.
엣지 Edge: 다음에 어떤 노드로 갈지 정하는 연결선입니다. 항상 같은 곳으로 가는 고정 엣지도 있고, 상태를 보고 갈림길을 정하는 조건부 엣지도 있습니다.
작은 예로 시작해 보겠습니다. 사용자의 메시지를 받아 모델이 한 번 답하는 그래프입니다.
from typing import Annotated
from typing_extensions import TypedDict

from langchain_core.messages import AnyMessage
from langchain_openai import ChatOpenAI
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages


class ChatState(TypedDict):
    messages: Annotated[list[AnyMessage], add_messages]


model = ChatOpenAI(model="gpt-4o-mini", temperature=0)


def call_model(state: ChatState):
    response = model.invoke(state["messages"])
    return {"messages": [response]}


builder = StateGraph(ChatState)
builder.add_node("call_model", call_model)
builder.add_edge(START, "call_model")
builder.add_edge("call_model", END)

graph = builder.compile()

result = graph.invoke({
    "messages": [{"role": "user", "content": "LangGraph를 한 문장으로 설명해줘"}]
})

print(result["messages"][-1].content)
여기서 messages 필드에 붙은 add_messages가 중요합니다. 일반 딕셔너리라면 새 메시지가 기존 메시지를 덮어쓸 수 있습니다. 하지만 대화형 애플리케이션에서는 메시지를 계속 누적해야 합니다. add_messages는 새 메시지를 기존 메시지 목록에 자연스럽게 합쳐 주는 리듀서입니다. 리듀서는 상태 업데이트를 어떻게 병합할지 정하는 함수라고 이해하면 됩니다.
노드 함수 call_model도 눈여겨보세요. 이 함수는 전체 상태를 다시 만들지 않습니다. 오직 바뀐 부분인 messages만 반환합니다. LangGraph는 이 부분 업데이트를 기존 상태에 병합합니다. 이 방식 덕분에 노드가 많아져도 각 노드는 자기 역할에만 집중할 수 있습니다.
도구를 쓰는 에이전트를 그래프로 만들기
이제 앞 장에서 만든 도구 사용 에이전트를 LangGraph로 표현해 보겠습니다. 핵심 흐름은 단순합니다.
모델이 사용자 메시지를 읽습니다. 도구 호출이 필요하다고 판단하면 도구 노드로 이동합니다. 도구 결과를 메시지에 추가한 뒤 다시 모델에게 돌아갑니다. 모델이 더 이상 도구를 호출하지 않으면 종료합니다.
이 흐름은 순환 구조입니다. 일반적인 선형 체인으로 표현하면 불편하지만, 그래프로 표현하면 아주 자연스럽습니다.
from typing import Annotated, Literal
from typing_extensions import TypedDict

from langchain_core.messages import AnyMessage
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
from langgraph.graph import StateGraph, START, END
from langgraph.graph.message import add_messages
from langgraph.prebuilt import ToolNode


class AgentState(TypedDict):
    messages: Annotated[list[AnyMessage], add_messages]


@tool
def get_refund_policy(product_type: str) -> str:
    """상품 유형별 환불 정책을 조회합니다."""
    policies = {
        "digital": "디지털 상품은 다운로드 후 환불이 제한됩니다.",
        "physical": "실물 상품은 수령 후 7일 이내 환불할 수 있습니다.",
    }
    return policies.get(product_type, "일반 환불 정책을 적용합니다.")


@tool
def lookup_order(order_id: str) -> str:
    """주문 번호로 주문 상태를 조회합니다."""
    return f"주문 {order_id}는 배송 완료 상태입니다."


tools = [get_refund_policy, lookup_order]
model = ChatOpenAI(model="gpt-4o-mini", temperature=0).bind_tools(tools)


def agent_node(state: AgentState):
    response = model.invoke(state["messages"])
    return {"messages": [response]}


def route_after_agent(state: AgentState) -> Literal["tools", "end"]:
    last_message = state["messages"][-1]
    if getattr(last_message, "tool_calls", None):
        return "tools"
    return "end"


builder = StateGraph(AgentState)
builder.add_node("agent", agent_node)
builder.add_node("tools", ToolNode(tools))

builder.add_edge(START, "agent")
builder.add_conditional_edges(
    "agent",
    route_after_agent,
    {
        "tools": "tools",
        "end": END,
    },
)
builder.add_edge("tools", "agent")

graph = builder.compile()
이 그래프의 모양을 말로 그리면 다음과 같습니다.
이 구조가 강력한 이유는 모델의 자율성을 완전히 풀어놓지 않으면서도 필요한 만큼 허용하기 때문입니다. 모델은 어떤 도구를 쓸지 판단합니다. 하지만 실행 흐름 자체는 그래프가 통제합니다. 도구를 실행한 뒤에는 반드시 다시 agent 노드로 돌아오고, 종료 조건은 route_after_agent 함수가 결정합니다.
복잡한 에이전트에서 가장 무서운 문제는 끝나지 않는 루프입니다. 따라서 실전에서는 상태에 attempts나 tool_call_count 같은 필드를 두고 최대 반복 횟수를 제한하는 것이 좋습니다.
class SafeAgentState(TypedDict):
    messages: Annotated[list[AnyMessage], add_messages]
    tool_call_count: int


def count_tool_use(state: SafeAgentState):
    return {"tool_call_count": state.get("tool_call_count", 0) + 1}


def route_safely(state: SafeAgentState) -> Literal["tools", "end"]:
    if state.get("tool_call_count", 0) >= 5:
        return "end"

    last_message = state["messages"][-1]
    if getattr(last_message, "tool_calls", None):
        return "tools"

    return "end"
에이전트에게 자유를 주되, 비상 브레이크는 코드로 잡아 두어야 합니다. 이것이 프로덕션 에이전트 설계의 기본 감각입니다.
조건 분기와 반복 루프 설계하기
조건부 엣지는 LangGraph를 단순한 파이프라인이 아니라 의사결정 시스템으로 만들어 줍니다. 예를 들어 RAG 시스템을 생각해 보겠습니다. 검색 결과가 충분하면 답변을 생성하고, 부족하면 질문을 다시 쓰고 재검색합니다. 답변 품질이 낮으면 검토 노드로 보내 다시 작성합니다. 이런 구조는 앞 장들에서 배운 RAG와 에이전트 개념이 만나는 지점입니다.
간단한 고객 지원 흐름을 그래프로 표현하면 다음과 같습니다.
이때 분류 노드는 모델을 쓸 수도 있고, 규칙 기반 함수일 수도 있습니다. 중요한 것은 분류 결과를 상태에 남기는 것입니다.
from typing import Literal
from typing_extensions import TypedDict

from langgraph.graph import StateGraph, START, END


class SupportState(TypedDict):
    question: str
    category: str
    approval_required: bool
    answer: str


def classify(state: SupportState):
    question = state["question"]
    if "환불" in question:
        return {"category": "refund"}
    if "배송" in question:
        return {"category": "shipping"}
    return {"category": "general"}


def route_by_category(state: SupportState) -> Literal["refund", "shipping", "general"]:
    return state["category"]


def refund_node(state: SupportState):
    approval_required = "100만원" in state["question"] or "고가" in state["question"]
    return {"approval_required": approval_required}


def route_by_approval(state: SupportState) -> Literal["human_approval", "answer"]:
    if state["approval_required"]:
        return "human_approval"
    return "answer"
처음에는 이런 코드가 LCEL 체인보다 길어 보일 수 있습니다. 하지만 업무가 커질수록 차이가 드러납니다. 체인 안에 if문과 while문이 숨어 있으면 흐름을 추적하기 어렵습니다. 반면 그래프는 분기와 반복이 구조로 드러납니다. 나중에 운영 중 문제가 생겼을 때도 어느 노드에서 실패했는지, 어떤 상태 때문에 잘못 분기했는지 확인하기 쉽습니다.
체크포인터로 상태를 기억하기
LangGraph의 큰 장점 중 하나는 상태를 저장하고 이어서 실행할 수 있다는 점입니다. LangGraph는 지속 실행, 사람의 개입, 메모리, 스트리밍 같은 기능을 에이전트 런타임의 중요한 요소로 제공합니다.4 이때 체크포인터는 그래프 실행 중간중간 상태를 저장하는 장치입니다.
가장 간단한 체크포인터는 MemorySaver입니다. 이름처럼 메모리에 상태를 저장합니다. 개발과 실습에는 편하지만, 프로세스가 종료되면 사라지므로 실제 운영에서는 영속 저장소 기반 체크포인터를 검토해야 합니다.
from langgraph.checkpoint.memory import MemorySaver

memory = MemorySaver()
graph = builder.compile(checkpointer=memory)

config = {
    "configurable": {
        "thread_id": "user-42-session-1"
    }
}

graph.invoke(
    {"messages": [{"role": "user", "content": "내 주문 A100의 환불 가능 여부를 확인해줘"}]},
    config=config,
)

graph.invoke(
    {"messages": [{"role": "user", "content": "방금 말한 주문 기준으로 다시 설명해줘"}]},
    config=config,
)
여기서 핵심은 thread_id입니다. 같은 thread_id로 호출하면 같은 실행 스레드의 상태를 이어 갑니다. 사용자가 첫 번째 요청에서 주문 번호를 말했고, 두 번째 요청에서 '방금 말한 주문'이라고 표현해도 그래프는 이전 메시지 이력을 바탕으로 문맥을 이어 갈 수 있습니다.
반대로 다른 사용자에게 같은 thread_id를 쓰면 큰 사고가 납니다. A 사용자의 대화가 B 사용자에게 섞일 수 있기 때문입니다. 실전에서는 보통 사용자 ID와 세션 ID를 조합해 스레드 ID를 만듭니다.
thread_id = f"user:{user_id}:session:{session_id}"
config = {"configurable": {"thread_id": thread_id}}
체크포인트 설계를 할 때는 다음 질문을 반드시 던져야 합니다.
이 상태는 브라우저 새로고침 후에도 유지되어야 하는가?
서버가 재시작되어도 복구되어야 하는가?
사용자별, 조직별, 업무별로 상태가 안전하게 분리되는가?
오래된 대화 이력은 언제 요약하거나 삭제할 것인가?
상태ful 워크플로는 편리하지만, 상태가 쌓이는 순간 개인정보와 보안의 문제가 함께 따라옵니다. 저장해야 할 것과 저장하지 말아야 할 것을 구분하는 습관이 중요합니다.
사람의 승인을 그래프에 넣기
앞 장에서 쓰기 도구는 조심해야 한다고 강조했습니다. 이메일 발송, 결제 취소, 데이터 삭제, 권한 변경 같은 행동은 모델 판단만으로 실행하면 위험합니다. LangGraph에서는 이런 지점을 승인 노드로 명확하게 분리할 수 있습니다.
예를 들어 환불 금액이 일정 기준 이상이면 human_approval 노드로 보냅니다. 이 노드는 실제 서비스에서는 관리자 화면에 승인 요청을 만들고, 승인이 들어오면 그래프를 재개하는 방식으로 구현할 수 있습니다.
def human_approval_node(state: SupportState):
    # 실제 제품에서는 여기서 승인 요청 레코드를 생성하거나
    # 사용자 인터페이스에 중단 상태를 표시합니다.
    return {
        "answer": "환불 금액이 커서 담당자 승인이 필요합니다. 승인 후 처리를 이어가겠습니다."
    }
처음에는 승인 노드를 단순한 안내 메시지로 구현해도 됩니다. 중요한 것은 위험한 행동 앞에 멈춤 지점을 설계하는 습관입니다. 나중에 LangSmith나 운영 시스템과 연결하면 이 멈춤 지점에서 상태를 확인하고 수정한 뒤 다시 실행할 수 있습니다.
멀티 에이전트는 팀을 설계하는 일입니다
단일 에이전트가 혼자 모든 일을 하게 만들 수도 있습니다. 하지만 업무가 커질수록 한 명의 만능 직원을 만드는 것보다 역할이 분리된 팀을 만드는 편이 안정적입니다. 리서처는 자료를 찾고, 분석가는 핵심을 뽑고, 작성자는 문서를 만들고, 리뷰어는 품질을 검토합니다.
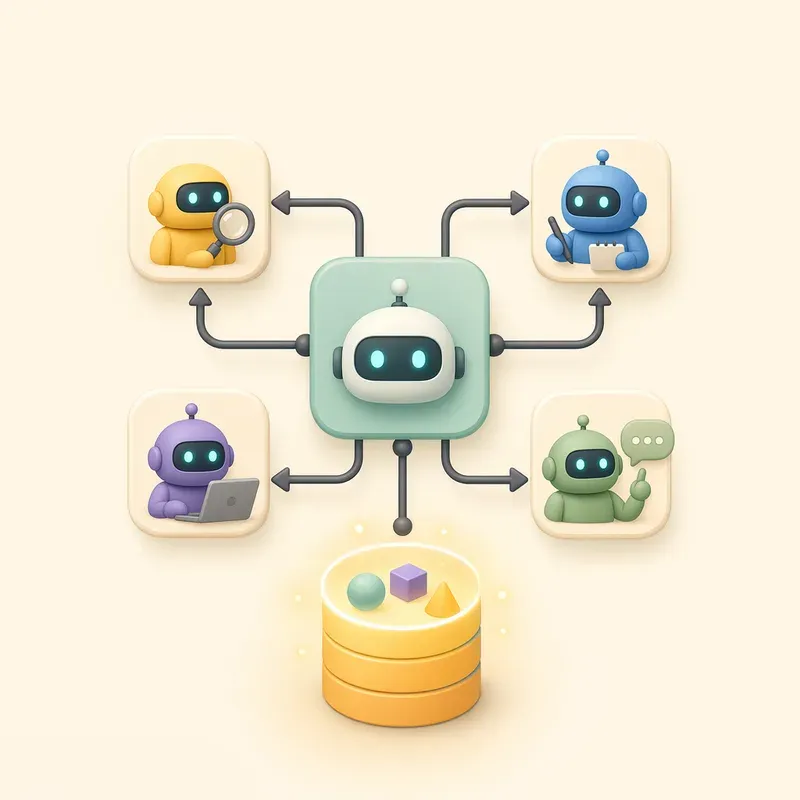
LangGraph에서 멀티 에이전트는 결국 여러 노드를 가진 그래프입니다. 각 노드는 하나의 역할을 맡고, 공유 상태를 읽고 갱신합니다. 관리자-작업자 구조라면 supervisor 노드가 다음에 어떤 작업자를 호출할지 결정합니다. 순차 협업 구조라면 researcher → analyst → writer → reviewer처럼 고정된 경로를 둡니다. 병렬 구조라면 여러 작업자가 동시에 결과를 만들고, 마지막에 synthesizer 노드가 합칩니다.
먼저 가장 이해하기 쉬운 순차형 멀티 에이전트부터 보겠습니다.
import operator
from typing import Annotated
from typing_extensions import TypedDict

from langchain_openai import ChatOpenAI
from langgraph.graph import StateGraph, START, END


class ReportState(TypedDict):
    topic: str
    research_notes: Annotated[list[str], operator.add]
    analysis: str
    draft: str
    review: str
    final_report: str


llm = ChatOpenAI(model="gpt-4o-mini", temperature=0.2)


def researcher(state: ReportState):
    response = llm.invoke(
        f"다음 주제의 핵심 자료를 조사해 요약해줘: {state['topic']}"
    )
    return {"research_notes": [response.content]}


def analyst(state: ReportState):
    notes = "n".join(state["research_notes"])
    response = llm.invoke(
        f"아래 조사 내용을 바탕으로 핵심 쟁점과 시사점을 분석해줘:n{notes}"
    )
    return {"analysis": response.content}


def writer(state: ReportState):
    response = llm.invoke(
        f"주제: {state['topic']}n분석: {state['analysis']}n위 내용을 바탕으로 보고서 초안을 작성해줘."
    )
    return {"draft": response.content}


def reviewer(state: ReportState):
    response = llm.invoke(
        f"다음 초안을 검토하고 개선 의견을 작성해줘:n{state['draft']}"
    )
    return {"review": response.content}


def finalizer(state: ReportState):
    response = llm.invoke(
        f"초안과 리뷰를 반영해 최종 보고서를 작성해줘.n초안:n{state['draft']}n리뷰:n{state['review']}"
    )
    return {"final_report": response.content}


builder = StateGraph(ReportState)
builder.add_node("researcher", researcher)
builder.add_node("analyst", analyst)
builder.add_node("writer", writer)
builder.add_node("reviewer", reviewer)
builder.add_node("finalizer", finalizer)

builder.add_edge(START, "researcher")
builder.add_edge("researcher", "analyst")
builder.add_edge("analyst", "writer")
builder.add_edge("writer", "reviewer")
builder.add_edge("reviewer", "finalizer")
builder.add_edge("finalizer", END)

report_graph = builder.compile()
위 코드는 설명을 위해 단순화한 예입니다. 실제로는 프롬프트 템플릿을 별도로 분리하고, 각 노드의 입력과 출력을 LangSmith로 추적하는 편이 좋습니다. 중요한 것은 상태의 흐름입니다. researcher는 research_notes를 채우고, analyst는 그것을 읽어 analysis를 만듭니다. writer는 분석을 바탕으로 draft를 만들고, reviewer는 초안을 검토합니다. 마지막 finalizer는 초안과 리뷰를 합쳐 최종 결과를 만듭니다.
여기서 research_notes에 operator.add 리듀서를 붙인 것도 눈여겨보세요. 여러 리서처가 동시에 조사 결과를 반환해도 리스트가 덮어써지지 않고 누적될 수 있습니다. 멀티 에이전트에서 공유 상태를 설계할 때 리듀서는 매우 중요합니다.
관리자-작업자 패턴으로 라우팅하기
순차형 구조는 예측 가능하지만 유연성이 낮습니다. 어떤 요청은 조사만 하면 되고, 어떤 요청은 분석이 필요하며, 어떤 요청은 바로 작성으로 넘어갈 수 있습니다. 이럴 때 supervisor 노드를 둡니다. supervisor는 현재 상태를 보고 다음 작업자를 고릅니다.
from typing import Literal
from typing_extensions import TypedDict

from langgraph.graph import StateGraph, START, END


class TeamState(TypedDict):
    task: str
    research: str
    analysis: str
    draft: str
    next_agent: str
    done: bool


def supervisor(state: TeamState):
    if not state.get("research"):
        return {"next_agent": "researcher"}
    if not state.get("analysis"):
        return {"next_agent": "analyst"}
    if not state.get("draft"):
        return {"next_agent": "writer"}
    return {"next_agent": "end", "done": True}


def route_from_supervisor(state: TeamState) -> Literal["researcher", "analyst", "writer", "end"]:
    return state["next_agent"]


def researcher_node(state: TeamState):
    return {"research": f"{state['task']}에 대한 조사 결과"}


def analyst_node(state: TeamState):
    return {"analysis": f"{state['research']}를 분석한 내용"}


def writer_node(state: TeamState):
    return {"draft": f"{state['analysis']}를 바탕으로 작성한 초안"}


builder = StateGraph(TeamState)
builder.add_node("supervisor", supervisor)
builder.add_node("researcher", researcher_node)
builder.add_node("analyst", analyst_node)
builder.add_node("writer", writer_node)

builder.add_edge(START, "supervisor")
builder.add_conditional_edges(
    "supervisor",
    route_from_supervisor,
    {
        "researcher": "researcher",
        "analyst": "analyst",
        "writer": "writer",
        "end": END,
    },
)

builder.add_edge("researcher", "supervisor")
builder.add_edge("analyst", "supervisor")
builder.add_edge("writer", "supervisor")

team_graph = builder.compile()
이 구조는 회사의 업무 배정과 닮았습니다. supervisor가 전체 진행 상황을 확인하고, 아직 비어 있는 결과를 채우도록 적절한 작업자를 호출합니다. 작업자는 자기 일을 끝내면 다시 supervisor에게 돌아옵니다. 그래프는 이 반복을 통해 최종 상태로 수렴합니다.
실전에서는 supervisor 자체도 LLM이 될 수 있습니다. 다만 모든 결정을 LLM에게 맡기기보다, 명확한 업무 규칙은 코드로 두고 애매한 판단만 모델에게 맡기는 편이 안정적입니다. 예를 들어 '초안이 없으면 writer로 간다'는 규칙은 코드가 더 잘합니다. '이 요청이 법무 검토 대상인가'처럼 문맥 판단이 필요한 부분은 모델이 도울 수 있습니다.
멀티 에이전트 설계에서 자주 하는 실수
멀티 에이전트는 멋있어 보이지만, 에이전트 수가 늘어난다고 품질이 자동으로 좋아지는 것은 아닙니다. 오히려 잘못 나누면 비용과 지연시간만 늘고, 책임 소재가 흐려집니다.
실전에서 특히 조심해야 할 지점은 다음과 같습니다.
역할이 겹치면 안 됩니다. 리서처와 분석가가 모두 자료 조사와 해석을 동시에 하면 결과가 중복되고 충돌합니다.
공유 상태의 소유권을 정해야 합니다. 어떤 노드가 어떤 필드를 쓰는지 명확하지 않으면 나중에 상태가 오염됩니다.
종료 조건이 분명해야 합니다. 리뷰어가 계속 수정을 요구하고 작성자가 계속 다시 쓰는 루프는 쉽게 무한 반복이 됩니다.
도구 권한은 역할별로 제한해야 합니다. 작성자 노드가 결제 취소 도구까지 쓸 필요는 없습니다.
중간 결과를 관측 가능하게 남겨야 합니다. 최종 답변만 보면 어느 에이전트가 문제를 만들었는지 알기 어렵습니다.
멀티 에이전트 설계의 핵심은 '많이 만들기'가 아니라 '잘 나누기'입니다. 사람 조직과 마찬가지로, 좋은 팀은 역할과 책임이 분명합니다.
LangGraph 설계 절차
처음부터 복잡한 그래프를 만들려고 하면 어렵습니다. 다음 순서로 접근하면 훨씬 수월합니다.
먼저 업무를 문장으로 씁니다. 예를 들어 고객 질문을 분류하고, 필요한 정보를 조회하고, 위험한 요청은 승인받고, 최종 답변을 작성한다고 적습니다.
각 동사를 노드 후보로 바꿉니다. 분류하기, 조회하기, 승인받기, 답변하기가 노드가 됩니다.
노드들이 공유해야 할 값을 상태로 정의합니다. 질문, 분류 결과, 조회 결과, 승인 여부, 답변 등이 상태 필드가 됩니다.
항상 가는 길은 고정 엣지로 연결합니다. START에서 classify로 가는 것처럼 변하지 않는 흐름입니다.
판단이 필요한 길은 조건부 엣지로 만듭니다. 환불인지 배송인지, 도구 호출이 있는지, 승인 필요 여부를 라우터 함수가 결정합니다.
반복이 필요한 곳에는 최대 횟수와 실패 시 경로를 둡니다. 재검색, 재작성, 도구 호출 루프에는 반드시 탈출 조건이 필요합니다.
마지막으로 체크포인터와 thread_id를 붙입니다. 상태가 이어져야 하는 업무라면 저장 전략이 설계의 일부입니다.
이 절차를 따르면 LangGraph는 거대한 마법 상자가 아니라, 읽을 수 있는 업무 지도처럼 보이기 시작합니다.
작은 그래프에서 운영 가능한 그래프로
LangGraph를 배우는 첫날에는 노드 두세 개짜리 그래프로 충분합니다. 그러나 이 장에서 익힌 개념은 그대로 운영 시스템까지 이어집니다. 상태를 정의하고, 노드를 작게 나누고, 조건부 엣지로 분기하고, 반복 루프에 종료 조건을 두고, 체크포인터로 실행 상태를 보존합니다. 이 원칙이 흔들리지 않으면 그래프가 커져도 관리할 수 있습니다.
LangGraph는 에이전트에게 더 많은 자유를 주는 도구가 아닙니다. 정확히 말하면, 자유와 통제의 균형을 잡는 도구입니다. 모델은 필요한 곳에서 판단하고, 그래프는 업무의 경계를 지킵니다. 그래서 단일 에이전트를 넘어 조건 분기, 반복, 승인, 협업이 필요한 AI 애플리케이션을 만들 때 LangGraph가 빛납니다.
다음 장에서는 이렇게 만든 복잡한 체인과 그래프가 실제로 어떻게 움직였는지 관찰하는 방법을 다룹니다. LangSmith를 사용하면 각 노드의 입력과 출력, 모델 호출, 도구 실행, 실패 지점을 추적할 수 있습니다. 그래프를 설계했다면, 이제 그 그래프가 현장에서 제대로 달리는지 볼 차례입니다.
참고
2LangChain Docs: Workflows and agents
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.