
이제부터는 "돌아간다"가 아니라 "버틴다"가 기준이다
앞 장에서 로컬 추론 도구로 멀티 GPU를 시작했다면, 이제 질문이 조금 바뀐다. "이 모델이 실행되는가?"가 아니라 "사용자가 몰려도 안정적으로 응답하는가?"를 물어야 한다. 개인이 터미널에서 프롬프트 하나를 넣고 답을 받는 상황과, 수십 명 또는 수천 명의 요청이 동시에 들어오는 서비스 환경은 완전히 다르다.
서비스용 LLM 서버는 단순한 generate() 루프가 아니다. 사용자가 보낸 요청을 줄 세우고, 비슷한 시점의 요청을 묶어 GPU에 올리고, 각 요청의 KV 캐시를 관리하고, 긴 프롬프트가 짧은 채팅 요청을 막지 않도록 스케줄링해야 한다. 모델이 GPU 한 장에 올라가지 않으면 여러 GPU로 쪼개야 하고, GPU가 죽거나 요청이 폭주하면 앞단 라우터와 모니터링도 필요하다.
이 장에서 비교할 엔진은 다음 다섯 가지다.
| 엔진 | 한 줄 요약 | 가장 잘 맞는 상황 |
|---|---|---|
| vLLM | 범용성과 처리량의 균형이 좋은 사실상의 기본 선택지 | 고동시성 API, 다양한 모델, 빠른 실험과 운영의 균형 |
| Hugging Face TGI | Hugging Face 생태계와 배포 경험이 강한 서버 | HF Hub 중심 조직, 기존 TGI 운영 환경, 단순 Docker 배포 |
| TensorRT-LLM | NVIDIA GPU 성능을 끝까지 뽑아내는 고성능 엔진 | 고정 모델, 대량 트래픽, H100/H200/B200/GB200 등 NVIDIA 최적화 환경 |
| SGLang | 반복 프롬프트와 구조화 생성을 잘 다루는 엔진 | 에이전트, 멀티턴 대화, 도구 호출, JSON 출력이 많은 워크로드 |
| Transformers TP | 연구와 실험에 유용한 기본 텐서 병렬 실행 | 모델 구조 실험, 논문 재현, 간단한 멀티 GPU 추론 테스트 |
중요한 점은 "가장 빠른 엔진 하나"가 모든 문제의 답은 아니라는 것이다. 같은 70B 모델이라도 짧은 챗봇 요청인지, 100K 토큰 문서 요약인지, 에이전트가 같은 시스템 프롬프트를 반복해서 쓰는지에 따라 최적의 엔진이 달라진다.
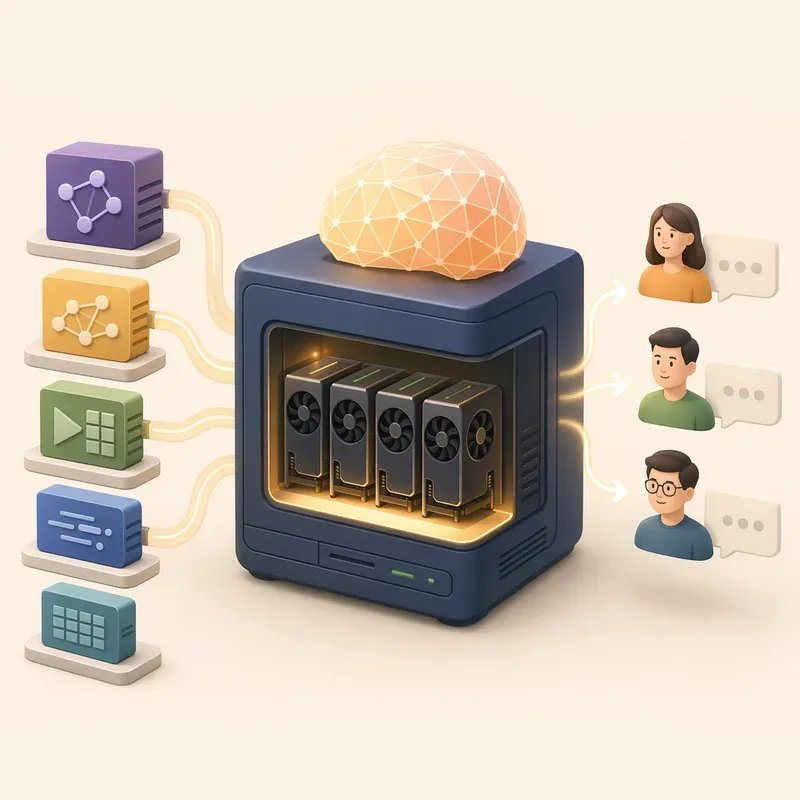
프로덕션 추론 엔진이 해결해야 하는 네 가지 문제
LLM 추론 서버는 크게 네 가지 싸움을 한다.
첫째는 배칭이다. GPU는 작은 요청 하나씩 처리할 때보다 여러 요청을 묶어 처리할 때 훨씬 효율적이다. 그러나 모든 요청의 길이가 같지 않기 때문에 고정 배치로 묶으면 짧은 요청이 긴 요청을 기다리는 낭비가 생긴다. 그래서 최신 엔진들은 요청이 끝나는 즉시 배치에서 빼고, 새 요청을 바로 넣는 continuous batching, 즉 연속 배칭을 사용한다.
둘째는 KV 캐시 관리다. KV 캐시는 이미 계산한 Key와 Value를 저장해 다음 토큰 생성 때 재사용하는 메모리다. 문제는 이 캐시가 컨텍스트 길이와 동시 요청 수에 따라 선형으로 커진다는 점이다. 모델 가중치는 4비트나 FP8로 줄였는데, KV 캐시가 긴 대화와 배치 때문에 VRAM을 다 먹어버리는 일이 흔하다. 좋은 추론 엔진은 KV 캐시를 필요한 만큼만 할당하고, 중복 프롬프트를 재사용하며, 메모리 압박 상황에서도 요청을 무너뜨리지 않아야 한다.
셋째는 병렬화다. 모델이 한 장의 GPU에 올라가지 않으면 텐서 병렬, 파이프라인 병렬, 전문가 병렬 같은 전략으로 쪼개야 한다. 하지만 병렬화는 공짜가 아니다. GPU 사이에 중간 결과를 계속 주고받아야 하므로 NVLink, PCIe, InfiniBand 같은 인터커넥트 성능이 곧 추론 성능이 된다.
넷째는 운영성이다. 실제 서비스에서는 모델 서버가 죽을 수 있고, 특정 사용자의 긴 요청이 전체 큐를 막을 수 있으며, 새 모델 버전을 배포하다가 캐시와 메모리 사용량이 달라질 수 있다. 따라서 프로덕션 엔진을 고를 때는 토큰/초 벤치마크만 보면 안 된다. 로그, 메트릭, 헬스체크, 장애 복구, 롤링 업데이트, API 호환성까지 함께 봐야 한다.
vLLM: 범용 프로덕션 서빙의 기준점
vLLM이 널리 쓰이는 이유는 분명하다. 좋은 기본 성능, 넓은 모델 지원, OpenAI 호환 API, 멀티 GPU 확장성이 한곳에 모여 있다. vLLM은 PagedAttention, continuous batching, chunked prefill, prefix caching, 다양한 양자화, speculative decoding, 구조화 출력, LoRA 서빙 등을 지원하는 고처리량 LLM 서빙 엔진으로 발전했다.1
vLLM의 핵심은 PagedAttention이다. 기존 방식은 각 요청에 대해 최대 컨텍스트 길이만큼 KV 캐시 공간을 크게 잡아두는 경우가 많았다. 마치 호텔 방을 예약할 때 실제로 한 명이 하루만 묵는데도 한 층 전체를 비워두는 것과 비슷하다. PagedAttention은 KV 캐시를 작은 블록으로 나누고, 운영체제의 가상 메모리처럼 필요한 블록만 연결해 쓴다. 덕분에 짧은 요청, 긴 요청, 중간에 종료된 요청이 섞여도 VRAM 조각을 훨씬 촘촘하게 사용할 수 있다.
continuous batching도 vLLM의 강점이다. LLM 생성은 한 번에 긴 문장을 완성하는 것이 아니라 토큰을 하나씩 반복 생성한다. 어떤 요청은 20토큰 만에 끝나고, 어떤 요청은 2,000토큰을 생성한다. vLLM은 매 생성 단계마다 완료된 요청을 빼고 새 요청을 넣으면서 GPU를 계속 바쁘게 만든다. 사용자는 더 빨리 첫 토큰을 받고, 운영자는 같은 GPU로 더 많은 토큰을 처리한다.
멀티 GPU 관점에서도 vLLM은 시작하기 쉽다. 모델이 한 노드의 여러 GPU에 들어가면 --tensor-parallel-size를 사용하고, 한 노드를 넘어가면 tensor parallel과 pipeline parallel을 조합할 수 있다. vLLM 공식 문서는 단일 GPU에 모델이 들어가면 분산이 필요 없고, 단일 노드 여러 GPU에 들어가면 텐서 병렬을 쓰며, 단일 노드에 들어가지 않으면 노드 내 GPU 수를 tensor parallel size로, 노드 수를 pipeline parallel size로 잡는 식의 지침을 제시한다.2
예를 들어 8장 GPU 서버에서 70B 모델을 서빙한다면 다음과 같은 구성이 출발점이 된다.
vllm serve meta-llama/Llama-3.1-70B-Instruct \
  --tensor-parallel-size 8 \
  --dtype auto \
  --max-model-len 32768 \
  --enable-prefix-caching \
  --gpu-memory-utilization 0.90
여기서 중요한 옵션은 --tensor-parallel-size만이 아니다. --max-model-len은 KV 캐시 상한을 결정하고, --gpu-memory-utilization은 모델 가중치를 제외한 VRAM을 얼마나 공격적으로 KV 캐시와 실행 버퍼에 쓸지 정한다. 이 값을 너무 높이면 처리량은 올라갈 수 있지만 갑작스러운 긴 요청이나 CUDA 그래프 버퍼 때문에 OOM이 날 수 있다. 너무 낮추면 GPU는 여유가 있는데 동시 요청을 충분히 받지 못한다.
vLLM은 특히 다음 상황에 강하다.
다양한 Hugging Face 모델을 빠르게 올려야 할 때
OpenAI 호환 API로 기존 애플리케이션을 거의 그대로 붙이고 싶을 때
단일 노드 멀티 GPU부터 멀티 노드까지 단계적으로 확장하려 할 때
LoRA, prefix caching, 구조화 출력, speculative decoding 등 기능을 유연하게 조합해야 할 때
다만 vLLM이 항상 최고 성능은 아니다. NVIDIA GPU에서 고정된 모델을 대규모로 돌리고, 모델 업데이트가 드물며, 엔진 빌드와 튜닝에 시간을 쓸 수 있다면 TensorRT-LLM이 더 높은 처리량을 낼 수 있다. 반대로 에이전트처럼 같은 프롬프트 뼈대를 반복하는 워크로드에서는 SGLang의 RadixAttention이 더 유리할 수 있다. vLLM은 "모든 상황에서 1등"이라기보다 "대부분의 상황에서 실패 확률이 낮은 기본값"에 가깝다.
Hugging Face TGI: 생태계 연동과 기존 운영의 힘
Text Generation Inference, 줄여서 TGI는 Hugging Face가 만든 LLM 서빙 서버다. TGI는 Docker 한 줄로 모델을 띄우기 쉽고, Hugging Face Hub의 모델 ID와 토큰을 자연스럽게 다루며, 토큰 스트리밍, Prometheus 메트릭, OpenTelemetry 추적, tensor parallelism, continuous batching, Flash Attention, Paged Attention, GPTQ·AWQ·bitsandbytes·FP8 양자화 등을 제공한다.3
TGI의 대표적인 멀티 GPU 구성은 shard 기반이다. --num-shard 4라고 지정하면 모델을 4개 GPU에 나눠 올리고, 내부적으로 NCCL 통신을 사용해 텐서 병렬 추론을 수행한다. vLLM의 --tensor-parallel-size와 개념적으로 비슷하지만, TGI를 사용하는 팀에서는 보통 "몇 shard로 띄울 것인가"라는 식으로 생각한다.
docker run --gpus all --shm-size 1g --ipc=host \
  -p 8080:80 \
  -v $PWD/data:/data \
  ghcr.io/huggingface/text-generation-inference:3.3.5 \
  --model-id meta-llama/Llama-3.1-70B-Instruct \
  --num-shard 4 \
  --max-input-tokens 8192 \
  --max-total-tokens 16384
TGI가 유리한 상황은 명확하다. 조직이 이미 Hugging Face Hub, Inference Endpoints, Transformers, safetensors, gated model 권한 관리에 익숙하다면 TGI는 배포 마찰을 크게 줄여준다. 모델을 사전에 변환하거나 별도 포맷으로 컴파일하지 않아도 되는 경우가 많고, Docker 기반 운영도 단순하다.
다만 2026년 기준으로는 중요한 변화가 있다. Hugging Face 공식 문서와 저장소는 TGI가 maintenance mode에 들어갔고, 앞으로는 경량 유지보수와 문서 개선 중심으로 운영되며 신규 배포에는 vLLM, SGLang, llama.cpp, MLX 같은 엔진 사용을 권장한다고 밝히고 있다.3 이것은 TGI가 갑자기 쓸 수 없다는 뜻이 아니다. 이미 안정적으로 운영 중인 TGI 서비스는 계속 유지할 수 있다. 그러나 새 시스템을 설계한다면 "TGI를 계속 가져갈 이유가 있는가?"를 한 번 더 물어야 한다.
요약하면 TGI는 Hugging Face 생태계와 운영 단순성 측면에서 여전히 이해하기 쉬운 선택지지만, 장기적인 기능 확장과 최신 최적화 속도까지 고려하면 vLLM이나 SGLang으로의 이전 가능성을 염두에 두는 편이 안전하다.
TensorRT-LLM: NVIDIA 환경에서 최고 성능을 노릴 때
TensorRT-LLM은 성격이 다르다. vLLM과 TGI가 "범용 서버"에 가깝다면, TensorRT-LLM은 NVIDIA GPU를 위해 깊게 최적화된 고성능 엔진이다. NVIDIA는 TensorRT-LLM이 custom attention kernel, in-flight batching, paged KV caching, FP8·NVFP4·INT4 AWQ·INT8 SmoothQuant 양자화, speculative decoding 등을 제공한다고 설명한다.5
핵심 차이는 컴파일과 최적화다. TensorRT-LLM은 모델 구조와 타깃 GPU, 정밀도, 최대 배치, 최대 시퀀스 길이 같은 조건을 바탕으로 최적화된 실행 엔진을 만들 수 있다. 이 과정은 번거롭다. 모델이 바뀌거나 시퀀스 길이 정책이 바뀌면 다시 빌드해야 할 수 있다. 하지만 한 번 잘 맞추면 NVIDIA GPU에서는 매우 높은 처리량과 낮은 지연시간을 기대할 수 있다.
TensorRT-LLM의 병렬화 옵션은 매우 풍부하다. 공식 문서 기준으로 TP, PP, DP, EP, CP, Wide-EP를 지원한다.4
| 전략 | 의미 | 잘 맞는 상황 |
|---|---|---|
| TP | 가중치 행렬을 여러 GPU에 나눔 | 한 장에 모델이 안 들어가거나 작은 배치에서 빠른 응답이 필요할 때 |
| PP | 레이어를 GPU별로 나눔 | 모델이 매우 커서 레이어 단위 분할이 필요할 때 |
| DP | 모델 복제본을 여러 개 띄워 요청을 나눔 | 모델이 GPU 한 묶음에 들어가고 트래픽이 많을 때 |
| EP | MoE 전문가를 여러 GPU에 나눔 | Mixtral, DeepSeek, Qwen-MoE 같은 MoE 모델 |
| CP | 긴 컨텍스트 처리를 여러 GPU에 나눔 | 초장문 입력, 문서 분석, 긴 RAG 요청 |
| Wide-EP | 전문가 복제와 로드밸런싱을 포함한 고급 EP | DeepSeek-V3/R1, Llama 4, Qwen3급 대형 MoE |
Wide-EP는 특히 MoE 모델에서 중요하다. MoE는 모든 전문가가 균등하게 호출되지 않는다. 어떤 전문가는 "인기 맛집"처럼 토큰이 몰리고, 어떤 전문가는 한산하다. 단순히 전문가를 GPU에 나눠 올리기만 하면 특정 GPU만 바빠져 전체 성능이 떨어진다. TensorRT-LLM의 Wide-EP는 hot expert 복제, 전문가 배치 조정, 로드밸런싱을 통해 이런 불균형을 줄이는 방향으로 설계되어 있다.4
정밀도 최적화도 TensorRT-LLM의 큰 장점이다. H100 세대에서는 FP8이, Blackwell 세대에서는 FP4 또는 NVFP4 계열 최적화가 중요해진다. 모델 가중치와 일부 연산을 낮은 정밀도로 처리하면 VRAM 사용량이 줄고, Tensor Core를 더 효율적으로 사용할 수 있다. 물론 저정밀은 항상 검증이 필요하다. 단순 챗봇에서는 품질 차이가 작아도, 수학 추론이나 코드 생성처럼 작은 오차가 결과를 크게 바꾸는 작업에서는 모델별 평가가 필요하다.
TensorRT-LLM은 다음 상황에서 빛난다.
NVIDIA GPU만 사용하고 하드웨어가 H100, H200, B200, GB200 등으로 통일되어 있다.
서비스하는 모델 종류가 적고, 모델 업데이트 주기가 비교적 길다.
트래픽이 충분히 커서 엔진 빌드와 튜닝 비용을 처리량 절감으로 회수할 수 있다.
엔터프라이즈 환경에서 Triton, Dynamo, NVIDIA AI Enterprise 같은 스택과 함께 운영한다.
반대로 모델을 자주 바꾸고, 여러 오픈 모델을 실험하고, AMD나 Apple Silicon 같은 다른 하드웨어까지 염두에 둔다면 TensorRT-LLM의 NVIDIA 종속성과 빌드 과정은 부담이 될 수 있다. 성능은 강력하지만, 유연성은 비용으로 지불해야 한다.
SGLang: 반복 프롬프트와 에이전트 워크로드의 강자
SGLang은 Structured Generation Language에서 출발한 엔진이다. 단순히 텍스트를 생성하는 서버라기보다, LLM 호출을 프로그램처럼 구성하고 최적화하는 데 초점을 둔다. SGLang 문서는 RadixAttention 기반 prefix caching, zero-overhead CPU scheduler, prefill-decode disaggregation, speculative decoding, continuous batching, paged attention, tensor/pipeline/expert/data parallelism, structured outputs, chunked prefill, FP4·FP8·INT4·AWQ·GPTQ 양자화, multi-LoRA batching 등을 핵심 기능으로 제시한다.6
SGLang을 이해하는 열쇠는 RadixAttention이다. vLLM의 PagedAttention이 KV 캐시를 잘게 나눠 VRAM을 효율적으로 쓰는 기술이라면, SGLang의 RadixAttention은 "이미 계산한 프롬프트 앞부분을 얼마나 잘 재사용할 것인가"에 초점을 둔다. Radix tree, 즉 접두어 트리 구조를 사용해 여러 요청이 공유하는 앞부분을 찾아 KV 캐시를 재사용한다. NVIDIA의 SGLang 개요도 RadixAttention이 반복문, 조건문, 복잡한 생성 프로그램에서 KV 캐시를 효율적으로 관리하고 중복 계산을 제거한다고 설명한다.7
예를 들어 에이전트 서비스가 있다고 하자. 모든 요청은 긴 시스템 프롬프트, 도구 목록, JSON 출력 규칙, 보안 정책, 회사 내부 용어 설명을 공유한다. 사용자 질문은 매번 다르지만 앞부분은 거의 같다. 일반 서버는 매 요청마다 이 긴 앞부분을 다시 prefill한다. SGLang은 이 공통 접두어를 캐시에 남겨두고, 다음 요청에서는 달라진 부분부터 계산을 시작할 수 있다.
SGLang은 다음과 같은 워크로드에 특히 잘 맞는다.
고정 시스템 프롬프트가 긴 챗봇
도구 정의와 함수 호출 스키마가 반복되는 에이전트
같은 문서나 규칙을 바탕으로 여러 질문을 던지는 RAG
JSON, 정규식, 문법 제약 등 구조화 출력이 많은 서비스
멀티턴 대화와 분기형 LLM 프로그램
SGLang의 structured generation도 중요하다. 많은 에이전트 시스템은 모델이 "자연어 답변"이 아니라 "정확한 JSON 함수 호출"을 내놓아야 한다. 출력이 중괄호 하나만 틀려도 파서가 실패하고, 애플리케이션은 재시도하거나 오류를 내야 한다. SGLang은 구조화 출력을 엔진 차원에서 다루기 때문에 애플리케이션 레벨의 후처리와 재시도 비용을 줄일 수 있다.
멀티 GPU 측면에서도 SGLang은 tensor parallel, data parallel, expert parallel, pipeline parallel 등 다양한 분산 전략을 지원한다.6 특히 MoE와 에이전트 워크로드가 결합되는 환경에서는 SGLang의 빠른 기능 추가 속도와 캐시 중심 설계가 매력적이다. 다만 모든 워크로드에서 vLLM보다 낫다고 단정하면 안 된다. 매번 완전히 다른 단발성 프롬프트가 들어오고 공유 접두어가 거의 없다면 RadixAttention의 장점은 줄어든다.
Transformers TP: 연구와 실험을 위한 가장 가까운 도구
Hugging Face Transformers에도 텐서 병렬 기능이 있다. tp_plan="auto"를 지정하면 모델이 사전에 정의한 텐서 병렬 계획을 바탕으로 레이어를 여러 GPU에 나눌 수 있고, 실행은 torchrun으로 여러 프로세스를 띄워 수행한다. 공식 문서는 tensor parallelism이 모델 레이어를 여러 조각으로 나눠 여러 가속기가 동시에 작업하게 하며, 단일 GPU 메모리를 초과하는 모델 실행과 처리량 향상에 도움이 된다고 설명한다.8
예시는 간단하다.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Meta-Llama-3-8B-Instruct",
    dtype=torch.bfloat16,
    tp_plan="auto",
)

tokenizer = AutoTokenizer.from_pretrained("meta-llama/Meta-Llama-3-8B-Instruct")
inputs = tokenizer("Can I help", return_tensors="pt").input_ids.to(model.device)
outputs = model(inputs)
실행은 다음처럼 한다.
torchrun --nproc-per-node 4 demo.py이 방식은 연구자와 모델 개발자에게 편리하다. 새로운 모델 구조를 실험하고, 직접 forward를 뜯어보고, 서빙 엔진이 아직 지원하지 않는 모델을 임시로 돌려볼 수 있다. Transformers 내부에서 모델 구조와 토크나이저, 커스텀 코드가 그대로 보이기 때문에 디버깅도 쉽다.
하지만 프로덕션 서빙 엔진으로 보면 한계가 분명하다. Transformers TP는 모델 병렬 실행을 도와주지만, vLLM이나 SGLang 같은 고급 요청 스케줄러, continuous batching, 정교한 KV 캐시 블록 관리, OpenAI 호환 서버 운영, 헬스체크와 메트릭, prefix caching 최적화까지 모두 자동으로 제공하는 것은 아니다. 물론 별도 서버를 직접 만들 수는 있지만, 그 순간 추론 엔진을 새로 만들기 시작하는 셈이다.
따라서 Transformers TP의 위치는 명확하다. 연구·실험·검증에는 좋다. 사용자 트래픽을 안정적으로 받는 API 서버라면 vLLM, SGLang, TensorRT-LLM, TGI 같은 전용 서빙 엔진을 우선 검토하는 편이 낫다.
엔진 선택을 위한 현실적인 기준
프로덕션 엔진 선택은 취향 문제가 아니라 트래픽 분포 문제다. 먼저 평균 입력 길이, p95 입력 길이, 평균 출력 길이, 동시 요청 수, 공유 프롬프트 비율, 모델 업데이트 주기, 필요한 JSON 출력 비율을 알아야 한다. 이 값이 없으면 엔진 선택은 거의 감으로 하는 일이 된다.
| 상황 | 우선 검토할 엔진 |
|---|---|
| 범용 OpenAI 호환 API를 빠르게 운영하고 싶다 | vLLM |
| Hugging Face Hub, gated model, 기존 HF 배포 체계가 중요하다 | TGI 또는 vLLM |
| NVIDIA H100/B200/GB200에서 고정 모델을 최대 처리량으로 돌린다 | TensorRT-LLM |
| 같은 시스템 프롬프트, 도구 정의, 대화 이력이 반복된다 | SGLang |
| JSON, function calling, 문법 제약 출력이 많다 | SGLang |
| 모델 구조를 바꾸며 연구하거나 서빙 엔진 지원 전 모델을 테스트한다 | Transformers TP |
| MoE 모델을 대규모로 운영한다 | TensorRT-LLM Wide-EP, vLLM/SGLang EP |
| 단순하고 안정적인 기존 TGI 서비스가 이미 있다 | 당장 유지, 신규 기능 필요 시 이전 계획 수립 |
벤치마크 표에서 TensorRT-LLM이 가장 빠르다고 해서 무조건 TensorRT-LLM을 선택하면 안 된다. 모델을 자주 바꾸는 팀이라면 엔진 빌드와 검증 시간이 운영 비용이 된다. 반대로 vLLM이 편하다고 해서 초대형 고정 트래픽을 모두 vLLM으로만 밀어붙이면 GPU 비용을 더 낼 수 있다. SGLang도 마찬가지다. 공유 prefix가 없는 워크로드에서는 강점이 줄어든다.
장애와 운영까지 포함해 비교해야 한다
LLM 서비스에서 가장 무서운 장애는 GPU가 완전히 죽는 경우만이 아니다. 더 흔한 문제는 서서히 큐가 쌓이고, TTFT가 길어지고, 사용자가 "응답이 멈춘 것 같다"고 느끼는 상황이다. 원인은 다양하다. 긴 프롬프트 몇 개가 prefill을 점유했을 수 있고, KV 캐시가 가득 차 새 요청을 못 받을 수 있으며, tensor parallel 통신이 PCIe 병목에 걸렸을 수 있다.
따라서 어떤 엔진을 쓰든 다음 지표를 반드시 봐야 한다.
TTFT: 요청 후 첫 토큰이 나오기까지의 시간
ITL 또는 TPOT: 토큰 사이 간격, 즉 생성 중 체감 속도
tokens/sec: 전체 처리량
queue depth: 대기 중인 요청 수
KV cache usage: KV 캐시 점유율과 eviction 여부
cache hit rate: prefix 또는 RadixAttention 캐시 적중률
GPU utilization: GPU 연산 사용률과 메모리 대역폭 사용률
NCCL error 및 all-reduce latency: 멀티 GPU 통신 문제
엔진 선택보다 더 중요한 것은 실제 트래픽으로 부하 테스트를 하는 일이다. ShareGPT 같은 공개 데이터셋도 출발점으로는 좋지만, 최종 결정은 서비스의 프롬프트 길이 분포와 출력 길이 분포로 해야 한다. 코드 생성 서비스, 문서 요약 서비스, 고객 상담 챗봇, 에이전트형 업무 자동화는 모두 토큰 패턴이 다르다.
이 장의 결론: 기본은 vLLM, 특수 목적은 과감히 나눠라
대부분의 팀이 처음 프로덕션 LLM 서빙을 시작한다면 vLLM을 기준점으로 삼는 것이 좋다. 기능이 넓고, OpenAI 호환 API가 편하며, PagedAttention과 continuous batching 덕분에 별도 CUDA 지식 없이도 좋은 성능을 얻을 수 있다.
Hugging Face 중심의 조직이라면 TGI는 여전히 이해하기 쉬운 선택지다. 다만 유지보수 모드라는 현실 때문에 신규 시스템에서는 장기 로드맵을 함께 검토해야 한다. NVIDIA GPU에서 같은 모델을 대규모로 오래 돌린다면 TensorRT-LLM을 벤치마크해야 한다. 엔진 빌드와 튜닝 비용을 감당할 수 있다면 GPU 비용을 크게 줄일 수 있다. 에이전트, 도구 호출, 반복 시스템 프롬프트, 구조화 출력이 핵심이라면 SGLang을 반드시 비교해야 한다. Transformers TP는 프로덕션 서버가 아니라 연구와 실험의 빠른 길로 보는 것이 안전하다.
결국 프로덕션 추론 엔진 선택은 다음 한 문장으로 정리할 수 있다. "내 모델이 어떤 GPU에 올라가는가"만 보지 말고, "내 사용자의 토큰이 어떤 패턴으로 몰려오는가"를 보아야 한다. 대형 언어모델 서빙의 승부는 모델 크기보다, 배칭과 KV 캐시와 병렬화와 운영을 얼마나 현실적으로 다루느냐에서 갈린다.
참고
1vLLM GitHub: high-throughput and memory-efficient inference and serving engine
3Hugging Face Text Generation Inference documentation
4TensorRT-LLM Parallelism in TensorRT LLM
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.