
멀티 GPU는 '더 빠른 마법'이 아니라 '나눠 담는 기술'이다
대형 언어모델을 멀티 GPU로 구동한다고 하면 왠지 GPU를 여러 장 꽂는 순간 속도가 몇 배로 뛰어오를 것처럼 느껴진다. 하지만 현실은 조금 다르다. 멀티 GPU는 공짜 성능 향상이 아니다. GPU 사이에 데이터를 주고받아야 하고, 동기화해야 하며, 어느 GPU가 놀고 있는지 계속 신경 써야 한다. 잘못 구성하면 GPU를 두 장 꽂았는데 속도는 1.3배만 빨라지거나, 심지어 단일 GPU보다 느려질 수도 있다.
그래서 첫 번째 원칙은 단순하다. 모델이 단일 GPU VRAM에 들어가거나, 단일 GPU가 목표 처리량을 낼 수 있다면 일단 단일 GPU로 시작한다. TensorRT-LLM 문서도 멀티 GPU 병렬화가 필요한 경우를 크게 두 가지로 정리한다. 하나는 모델이 GPU 한 장의 메모리에 들어가지 않는 경우이고, 다른 하나는 GPU 한 장으로 원하는 성능을 낼 수 없는 경우다1. vLLM 역시 모델이 단일 GPU에 들어간다면 분산 추론은 대체로 불필요하며, 먼저 그 GPU에서 실행하라고 권장한다2.
이 말은 멀티 GPU가 중요하지 않다는 뜻이 아니다. 오히려 반대다. 70B 모델을 BF16으로 올리거나, 405B급 모델을 다루거나, 긴 컨텍스트와 높은 동시성을 동시에 요구하는 순간부터는 멀티 GPU가 선택이 아니라 생존 전략이 된다. 다만 그때도 "GPU를 몇 장 쓸까?"보다 먼저 물어야 할 질문은 이것이다.
무엇을 어떻게 나눌 것인가?
LLM 병렬화는 이 질문에 대한 여러 가지 답이다. 모델의 행렬을 쪼갤 수도 있고, 레이어를 나눌 수도 있고, 요청을 나눌 수도 있다. MoE 모델이라면 전문가를 나눌 수 있고, 긴 문맥이 문제라면 시퀀스 자체를 나눌 수도 있다. 이 장에서는 Tensor Parallelism, Pipeline Parallelism, Data Parallelism, Expert Parallelism, Context Parallelism을 한눈에 비교하면서, 어떤 상황에서 어떤 전략을 선택해야 하는지 감을 잡아보자.
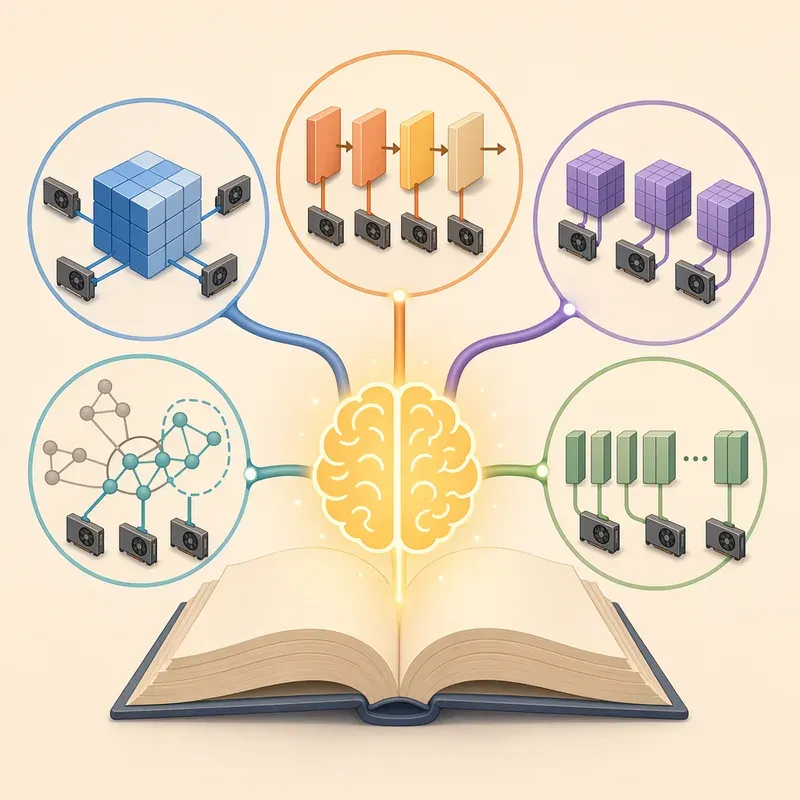
다섯 가지 병렬화 방식의 큰 그림
LLM 추론에서 자주 만나는 병렬화 전략은 다음 다섯 가지다.
| 병렬화 방식 | 무엇을 나누는가 | 주로 해결하는 문제 | 대표적인 통신 패턴 | 잘 맞는 환경 |
|---|---|---|---|---|
| Tensor Parallelism, TP | 각 레이어 내부의 큰 행렬 | 모델 가중치가 한 GPU에 안 들어감, 낮은 지연시간 | all-reduce, reduce-scatter, all-gather | NVLink가 있는 단일 노드 |
| Pipeline Parallelism, PP | 레이어 블록 | 모델 전체를 여러 GPU에 분산 | 인접 stage 간 activation 전달 | PCIe, 멀티 노드, 큰 모델 |
| Data Parallelism, DP | 요청 또는 배치 | 처리량과 동시성 확장 | 추론에서는 요청 분산, 학습에서는 gradient 동기화 | 모델이 각 GPU에 들어갈 때 |
| Expert Parallelism, EP | MoE의 expert | 거대한 MoE 모델의 expert 분산 | token dispatch, all-to-all | DeepSeek, Mixtral 같은 MoE |
| Context Parallelism, CP | 긴 시퀀스의 context | 긴 컨텍스트의 KV 캐시와 attention 부담 | KV 또는 Q 교환, ring attention 계열 | long-context, reasoning workload |
이 표만 보면 병렬화가 깔끔하게 나뉘는 것처럼 보인다. 하지만 실제 시스템에서는 이 전략들을 조합한다. 예를 들어 단일 노드 8GPU 서버에서는 TP=8을 쓰고, 노드가 2대라면 각 노드 안에서는 TP=8, 노드 사이에서는 PP=2를 쓰는 식이다. vLLM 문서도 단일 노드 안에 모델이 들어가면 텐서 병렬화를 쓰고, 단일 노드를 넘어서는 경우에는 노드 안에서는 TP, 노드 사이에서는 PP를 조합하는 구성을 예시로 제시한다2.
TensorRT-LLM 역시 TP, PP, DP, EP, CP를 모두 지원하며, MoE 모델을 위한 Wide Expert Parallelism 같은 고급 방식까지 제공한다1. 결국 병렬화 전략은 하나를 고르는 문제가 아니라, 내 모델·내 GPU·내 네트워크·내 트래픽에 맞는 조합을 찾는 문제다.
Tensor Parallelism: 레이어 내부의 큰 행렬을 잘라 나누기
텐서 병렬화, 줄여서 TP는 모델의 각 레이어 안에 있는 큰 행렬 연산을 여러 GPU에 나눠 맡기는 방식이다. Transformer 레이어에는 크게 두 종류의 무거운 계산이 있다. 하나는 attention의 Q, K, V projection과 output projection이고, 다른 하나는 MLP 또는 FFN이라고 부르는 feed-forward network의 큰 행렬 곱셈이다.
TP는 이 행렬들을 GPU 수만큼 쪼갠다. 예를 들어 TP=4라면 각 GPU가 attention과 MLP 가중치의 4분의 1씩을 들고 있다. 입력 토큰은 모든 GPU에 들어가고, 각 GPU는 자신이 가진 조각으로 계산한다. 그런 다음 결과를 합쳐야 다음 레이어로 넘어갈 수 있다.
여기서 중요한 단어가 동기화다. 각 GPU가 계산한 조각은 혼자서는 완전한 출력이 아니다. 레이어마다 결과를 합치는 통신이 필요하다. 구현에 따라 all-reduce, reduce-scatter, all-gather 같은 집합 통신이 발생한다. 쉽게 말하면 GPU들이 "내가 계산한 부분은 이거야. 네가 계산한 부분은 뭐야?" 하고 계속 맞춰보는 과정이다.
이 구조 때문에 TP는 GPU 간 연결 속도에 매우 민감하다. NVLink처럼 GPU끼리 매우 빠르게 통신할 수 있는 서버에서는 TP가 강력하다. 반대로 소비자용 메인보드의 PCIe만으로 여러 GPU를 연결한 환경에서는 레이어마다 통신 비용이 쌓여 성능이 기대만큼 나오지 않을 수 있다. Meta의 대규모 추론 최적화 글에서도 TP의 all-reduce 통신이 end-to-end latency에서 큰 비중을 차지할 수 있다고 설명한다3.
TP를 비유하자면, 네 명의 요리사가 하나의 큰 요리를 동시에 만드는 것과 비슷하다. 한 명은 고기를 굽고, 한 명은 소스를 만들고, 한 명은 채소를 볶고, 한 명은 플레이팅을 준비한다. 잘 맞으면 빠르다. 하지만 매 단계마다 "소스 다 됐어?", "고기 어디까지 됐어?"를 확인해야 한다. 주방 안에서 바로 소통할 수 있으면 좋지만, 서로 다른 건물에 있다면 확인하는 시간만으로도 요리가 늦어진다.
vLLM에서 TP는 매우 간단하게 켤 수 있다.
vllm serve meta-llama/Llama-3.1-70B-Instruct \
  --tensor-parallel-size 4
이 명령은 모델을 4개의 GPU에 텐서 병렬 방식으로 나눠 올린다. 단, 실제로 안정적으로 돌리려면 모델의 attention head 수가 TP 크기와 잘 맞는지, GPU 사이 통신이 충분히 빠른지, KV 캐시에 남는 VRAM이 충분한지 확인해야 한다.
TP가 잘 맞는 상황은 비교적 명확하다. 모델이 한 GPU에는 들어가지 않지만 단일 서버의 여러 GPU에는 들어가고, GPU 사이에 NVLink나 그에 준하는 빠른 인터커넥트가 있으며, 단일 요청 지연시간을 낮추고 싶을 때다. 특히 H100 SXM, A100 SXM, HGX/DGX 계열처럼 GPU 간 통신이 설계 단계부터 고려된 시스템에서는 TP가 가장 먼저 검토되는 전략이다.
Pipeline Parallelism: 레이어를 stage로 나눠 흐르게 하기
파이프라인 병렬화, PP는 모델의 레이어를 순서대로 나눠 여러 GPU에 배치한다. 80개 레이어를 가진 모델을 PP=4로 나누면 GPU 0은 0~19번 레이어, GPU 1은 20~39번 레이어, GPU 2는 40~59번 레이어, GPU 3은 60~79번 레이어를 맡는 식이다.
TP가 "각 레이어 안의 행렬을 가로로 자르는 방식"이라면, PP는 "모델을 세로로 잘라 구간별로 맡기는 방식"에 가깝다. 입력은 첫 번째 GPU를 통과하고, 그 결과 activation이 두 번째 GPU로 넘어간다. 다시 두 번째 GPU가 자신의 레이어를 처리하고 다음 GPU로 넘긴다. 공장의 컨베이어벨트를 떠올리면 이해하기 쉽다.
PP의 장점은 통신이 상대적으로 단순하다는 것이다. TP처럼 매 레이어마다 모든 GPU가 서로 결과를 맞춰야 하는 것이 아니라, stage와 stage 사이에서 activation을 넘기면 된다. 그래서 GPU 간 연결이 상대적으로 느린 PCIe 환경에서도 TP보다 다루기 쉬운 경우가 많다. vLLM 문서도 NVLink가 없는 GPU 환경, 예를 들어 L40S 같은 구성에서는 텐서 병렬화보다 파이프라인 병렬화를 활용하는 것이 통신 오버헤드 측면에서 유리할 수 있다고 설명한다2.
하지만 PP에는 유명한 문제가 있다. 바로 pipeline bubble이다.
요청이 하나만 들어왔다고 생각해보자. GPU 0이 첫 stage를 처리하는 동안 GPU 1, GPU 2, GPU 3은 기다린다. GPU 0이 끝나서 GPU 1로 넘기면 이제 GPU 0은 놀고, GPU 1이 일한다. 단일 요청만 보면 한 번에 하나의 GPU만 바쁘게 움직이는 순간이 많아진다. 이 빈 공간이 bubble이다.
서비스 트래픽이 많다면 이 문제를 완화할 수 있다. GPU 1이 요청 A의 두 번째 stage를 처리하는 동안 GPU 0은 요청 B의 첫 번째 stage를 처리한다. 또 GPU 2는 요청 A의 세 번째 stage를 처리하고, GPU 1은 요청 B의 두 번째 stage를 처리하는 식으로 micro-batch를 흘려보내면 공장 라인처럼 모든 GPU를 바쁘게 만들 수 있다.
다만 이 구조에는 대가가 있다. 단일 요청의 latency는 증가할 수 있다. 요청 하나가 모든 stage를 순서대로 지나가야 하기 때문이다. 그래서 PP는 "한 명의 사용자가 보낸 요청을 가장 빨리 끝내는 것"보다는 "많은 요청을 꾸준히 처리하면서 큰 모델을 여러 GPU에 올리는 것"에 더 잘 맞는다.
vLLM에서는 다음처럼 PP를 지정할 수 있다.
vllm serve meta-llama/Llama-3.1-70B-Instruct \
  --pipeline-parallel-size 4
TP와 PP를 조합할 수도 있다.
vllm serve meta-llama/Llama-3.1-405B-Instruct \
  --tensor-parallel-size 8 \
  --pipeline-parallel-size 2 \
  --distributed-executor-backend ray
이 구성은 보통 "노드 안에서는 TP, 노드 사이에서는 PP"라는 사고방식으로 이해하면 된다. 예를 들어 노드 2대가 있고 각 노드에 GPU 8장이 있다면, 각 노드 내부의 빠른 GPU 연결을 이용해 TP=8을 구성하고, 노드 사이에서는 PP=2로 레이어 stage를 나눌 수 있다.
PP는 특히 다음과 같은 상황에서 빛난다. 모델이 단일 노드에 다 들어가지 않아 여러 노드로 나눠야 할 때, GPU 간 연결이 PCIe 중심이라 TP 통신비가 부담될 때, 또는 GPU VRAM 크기가 서로 달라 균등한 텐서 쪼개기가 어려울 때다.
Data Parallelism: 모델을 복제하고 요청을 나누기
데이터 병렬화, DP는 가장 직관적인 병렬화 방식이다. 각 GPU에 같은 모델 복제본을 하나씩 올리고, 요청이나 배치를 나눠 처리한다. GPU 0은 사용자 A와 B의 요청을 처리하고, GPU 1은 사용자 C와 D의 요청을 처리하는 식이다.
중요한 점은 DP가 모델 크기 자체를 줄여주지 않는다는 것이다. 70B BF16 모델이 GPU 한 장에 들어가지 않는다면, DP를 한다고 해결되지 않는다. 왜냐하면 각 GPU가 모델 전체를 가지고 있어야 하기 때문이다. 따라서 DP는 "모델이 각 GPU에 들어갈 때" 처리량을 늘리는 방식이다.
추론에서 DP는 매우 실용적이다. 같은 모델을 여러 장의 GPU에 복제해두면 로드밸런서가 요청을 나눠 보낼 수 있다. GPU 사이에 매 토큰마다 복잡한 동기화를 할 필요도 적다. 이 때문에 단일 모델이 각 GPU VRAM에 충분히 들어가는 경우, 서비스 처리량과 동시성을 늘리는 가장 단순하고 안정적인 방법이 된다. TensorRT-LLM 문서도 DP를 모델을 여러 GPU에 복제하고 서로 다른 요청을 처리하는 방식으로 설명하며, 큰 batch와 높은 throughput 시나리오에 적합하다고 정리한다1.
예를 들어 8B 모델을 4장의 GPU에 각각 하나씩 올리면, 모델 하나의 단일 요청 속도는 거의 그대로일 수 있다. 하지만 동시에 처리할 수 있는 요청 수는 크게 늘어난다. 음식점으로 비유하면, TP와 PP는 한 주방 안에서 하나의 큰 요리를 여러 요리사가 나눠 만드는 방식이고, DP는 같은 메뉴를 만들 수 있는 주방을 여러 개 여는 방식이다.
DP는 다음과 같은 경우에 특히 좋다.
모델이 단일 GPU에 안정적으로 들어간다.
요청 수가 많고 QPS, 즉 초당 요청 처리량을 늘리고 싶다.
구성과 장애 대응을 단순하게 유지하고 싶다.
GPU 간 통신이 느리거나, 아예 통신을 최소화하고 싶다.
단, DP에서도 KV 캐시는 중요하다. 각 GPU는 자신이 처리하는 요청의 KV 캐시를 따로 가진다. 요청이 길고 동시성이 높으면, 모델 가중치는 충분히 들어가도 KV 캐시 때문에 OOM이 날 수 있다. 그래서 DP는 "모델이 들어가느냐"뿐 아니라 "동시 요청의 KV 캐시까지 들어가느냐"를 함께 봐야 한다.
또 하나 구분할 점이 있다. 학습에서 DP는 각 GPU가 gradient를 계산한 뒤 all-reduce로 동기화하는 방식으로 설명되는 경우가 많다. 하지만 이 책의 주제인 추론 서버에서는 주로 요청 분산과 복제본 확장 관점으로 이해하는 것이 더 직접적이다. 학습의 DP와 추론의 DP는 같은 이름을 쓰지만, 병목과 설계 목표가 다르다.
Expert Parallelism: MoE의 expert를 나눠 배치하기
전문가 병렬화, EP는 모든 LLM에 필요한 방식은 아니다. EP는 MoE, 즉 Mixture of Experts 구조를 가진 모델에서 중요하다. MoE 모델은 하나의 거대한 FFN 대신 여러 개의 expert 네트워크를 가지고 있고, 각 토큰마다 router가 일부 expert만 선택해 활성화한다.
이 구조의 매력은 분명하다. 전체 파라미터 수는 매우 크지만, 토큰 하나가 실제로 사용하는 활성 파라미터 수는 상대적으로 작다. 그래서 이론적으로는 "거대한 모델의 지식"과 "작은 모델처럼 낮은 연산량"을 동시에 노릴 수 있다. DeepSeek 계열, Mixtral 계열, 여러 Qwen MoE 모델이 이런 방향의 대표적인 예다.
문제는 expert 가중치를 어딘가에는 올려야 한다는 것이다. 토큰당 일부 expert만 쓴다고 해도, 서비스하려면 전체 expert의 가중치가 필요하다. EP는 이 expert들을 여러 GPU에 분산한다. GPU 0에는 expert 0~15, GPU 1에는 expert 16~31 같은 식으로 배치하고, router가 "이 토큰은 expert 23과 expert 41로 보내라"고 결정하면 해당 expert가 있는 GPU로 토큰 표현을 보낸다.
이때 발생하는 대표적인 통신이 all-to-all이다. 각 GPU가 자신에게 들어온 토큰 중 일부를 다른 GPU의 expert로 보내고, 계산 결과를 다시 받아야 한다. dense model의 TP가 레이어마다 결과를 맞추는 동기화라면, MoE의 EP는 토큰을 expert가 있는 곳으로 배달했다가 다시 회수하는 물류 시스템에 가깝다.
EP에서 가장 골치 아픈 문제는 부하 불균형이다. router가 특정 expert를 유난히 많이 선택하면 그 expert를 가진 GPU만 바빠지고 나머지 GPU는 기다리게 된다. TensorRT-LLM의 Wide Expert Parallelism은 이런 hot expert 문제와 expert 간 workload imbalance를 완화하기 위해 expert 복제와 load balancing을 활용하는 고급 EP 방식으로 소개된다1.
MoE에서 TP와 EP의 차이를 간단히 정리하면 이렇다. TP는 모든 expert의 가중치를 GPU들이 조금씩 나눠 가진다. 반면 EP는 expert 자체를 GPU별로 나눠 가진다. 전자는 계산 조각을 나누는 느낌이고, 후자는 전문가 사무실을 여러 건물에 분산 배치하는 느낌이다.
특히 DeepSeek류 모델처럼 전체 파라미터는 매우 크지만 토큰당 활성 파라미터는 비교적 작은 모델에서는 EP가 중요해진다. 단순히 TP로만 쪼개면 KV 캐시가 중복되거나 expert 통신이 비효율적일 수 있다. TensorRT-LLM 문서도 GQA, MQA, MLA처럼 KV head 수가 TP 크기보다 적은 경우 KV cache가 각 GPU에 복제될 수 있다고 설명한다1. 이런 경우 attention 쪽은 DP로 요청을 나누고, MoE expert는 EP로 나누는 식의 조합이 더 효율적일 수 있다.
vLLM에서도 MoE 모델을 위한 expert parallel 구성이 가능하다.
vllm serve deepseek-ai/DeepSeek-V3 \
  --tensor-parallel-size 8 \
  --enable-expert-parallel
또는 높은 동시성과 처리량을 목표로 DP와 EP를 조합하는 방향을 고려할 수 있다. 중요한 것은 MoE 모델을 dense model처럼만 다루면 안 된다는 점이다. MoE는 "전체 파라미터 수"와 "토큰당 활성 파라미터 수"가 다르므로, 병렬화 전략도 그 구조를 반영해야 한다.
Context Parallelism: 긴 문맥을 sequence 축으로 나누기
컨텍스트 병렬화, CP는 긴 컨텍스트 시대에 점점 중요해지는 전략이다. 앞선 장에서 보았듯이 KV 캐시는 sequence length와 batch, 동시성에 따라 커진다. 8K 컨텍스트에서는 괜찮던 모델이 128K 컨텍스트에서 갑자기 OOM을 내는 이유도 여기에 있다.
CP는 긴 시퀀스를 여러 GPU에 나눠 처리한다. 모델 가중치를 나누는 것이 아니라, 입력 context의 토큰 축을 나누는 방식이다. 예를 들어 1M 토큰짜리 문서를 여러 구간으로 쪼개고, 각 GPU가 자기 구간의 query, key, value 또는 attention 일부를 맡는다. 이후 전체 attention 결과를 만들기 위해 필요한 K/V 또는 Q 정보를 GPU끼리 교환한다.
Meta는 long-context inference에서 CP를 attention module 안에서 활용하며, Pass-KV와 Pass-Q 같은 방식으로 rank 간에 key/value 또는 query를 교환하는 접근을 설명한다. 또한 긴 컨텍스트에서는 attention 계산량, KV 캐시 메모리, 노드 간 통신이 모두 문제가 된다고 정리한다3. 별도의 연구에서도 context parallelism이 긴 컨텍스트 prefill latency를 여러 H100 GPU와 다수 노드에서 확장하는 데 사용될 수 있음을 보인다4.
여기서 꼭 이해해야 할 것이 LLM 추론의 두 단계다.
첫 번째는 prefill이다. 사용자가 입력한 프롬프트 전체를 한 번에 처리해 각 레이어의 KV 캐시를 만든다. 긴 문서 요약, 대규모 RAG, 코드베이스 전체 분석처럼 입력이 길면 prefill이 무거워진다. Attention 계산도 길이에 따라 커지고, 특히 매우 긴 context에서는 이 단계가 체감 지연시간, 즉 Time To First Token을 크게 좌우한다.
두 번째는 decode다. 모델이 토큰을 하나씩 생성하는 단계다. 이때는 매번 새 토큰 하나를 만들면서 기존 KV 캐시를 계속 참조한다. decode는 prefill보다 한 번의 계산량은 작아 보이지만, 수백 번 또는 수천 번 반복된다. 그리고 매 단계마다 KV 캐시를 읽어야 하므로 메모리 대역폭의 영향을 크게 받는다.
즉 long-context workload에서는 prefill과 decode의 병목이 다르다. prefill은 큰 입력을 한꺼번에 처리하는 계산 집약적 성격이 강하고, decode는 KV 캐시를 반복적으로 읽는 메모리 대역폭 집약적 성격이 강하다. 그래서 최근의 대규모 추론 시스템은 prefill과 decode를 분리해 서로 다른 자원이나 병렬화 전략을 적용하는 방향으로 발전하고 있다. Meta도 향후 방향으로 prefill과 decoding tier를 분리하는 disaggregated inference를 언급한다3.
CP는 특히 reasoning 모델, 긴 출력, 긴 문서 기반 질의응답, multi-turn conversation처럼 KV 캐시가 계속 커지는 환경에서 중요하다. 단순히 모델 가중치를 여러 GPU에 나눴다고 해서 긴 컨텍스트 문제가 사라지는 것은 아니다. 가중치가 들어가도 KV 캐시가 못 들어가면 서비스는 실패한다. CP는 바로 이 지점, 즉 "모델은 올라갔는데 긴 문맥이 안 된다"는 문제를 겨냥한다.
병렬화 전략은 서로 경쟁하지 않고 조합된다
실전에서 TP, PP, DP, EP, CP는 서로 배타적인 선택지가 아니다. 오히려 큰 모델일수록 여러 전략을 겹쳐 쓴다. 이를 흔히 3D parallelism, N-D parallelism 같은 말로 부른다. 이름은 거창하지만 원리는 단순하다. 서로 다른 축을 나누는 것이다.
예를 들어 dense 405B 모델을 여러 노드에서 서비스한다고 해보자. 한 노드 안에는 H100 8장이 있고, 노드는 2대다. 이 경우 노드 내부에서는 빠른 NVLink를 활용해 TP=8을 쓰고, 노드 사이에서는 레이어를 나누는 PP=2를 쓸 수 있다. 여기에 트래픽이 많아지면 같은 구성을 여러 replica로 띄워 DP처럼 요청을 분산한다.
MoE 모델이라면 구성이 더 복잡해진다. Attention과 dense layer 일부는 TP 또는 DP로 처리하고, expert layer는 EP로 분산한다. 긴 컨텍스트까지 요구하면 attention의 context 축에 CP를 더할 수 있다.
개념적으로는 다음처럼 생각하면 편하다.
전체 GPU 수 = TP × PP × DP × EP × CP의 조합으로 소비된다물론 실제 프레임워크마다 이 곱이 그대로 적용되지는 않는다. 어떤 전략은 같은 GPU 그룹 안에서 겹쳐 적용되고, 어떤 전략은 특정 레이어에만 적용된다. 하지만 설계자의 머릿속에서는 "어떤 축을 몇 개로 나눌 것인가"라는 식으로 정리하면 훨씬 덜 복잡하다.
어떤 전략을 먼저 고를까?
실무에서는 다음 순서로 판단하면 좋다.
| 상황 | 우선 검토할 전략 | 이유 |
|---|---|---|
| 모델과 KV 캐시가 단일 GPU에 충분히 들어간다 | 단일 GPU 또는 DP | 분산 오버헤드를 피하고, 필요하면 복제본으로 처리량 확장 |
| 모델이 한 GPU에는 안 들어가지만 한 노드의 여러 GPU에는 들어간다 | TP | NVLink가 있다면 낮은 latency와 좋은 활용률 기대 |
| NVLink가 없고 PCIe 기반 멀티 GPU다 | PP 또는 DP | TP의 잦은 동기화 비용을 피하기 쉬움 |
| 모델이 단일 노드 전체에도 안 들어간다 | TP + PP | 노드 안은 TP, 노드 사이는 PP가 일반적 |
| 동일 모델에 동시 요청이 많다 | DP, continuous batching | 모델 복제본을 늘려 QPS와 동시성 확장 |
| MoE 모델이다 | EP + TP/DP | expert를 분산하고 token routing 비용을 관리해야 함 |
| 긴 컨텍스트가 핵심 병목이다 | CP + prefill/decode 최적화 | KV 캐시와 attention 계산을 sequence 축으로 분산 |
이 표에서 가장 자주 놓치는 부분은 "모델이 들어간다"의 의미다. 모델 가중치만 들어가는 것으로는 충분하지 않다. KV 캐시, CUDA runtime, 프레임워크 overhead, batch 여유, speculative decoding이나 prefix caching 같은 부가 기능의 메모리까지 생각해야 한다. 그래서 병렬화 전략은 항상 VRAM 계산과 함께 결정해야 한다.
또 하나 중요한 현실은 재현성이다. 병렬화 방식을 바꾸면 floating-point 연산 순서가 바뀐다. 같은 모델, 같은 프롬프트, temperature=0이어도 TP 크기나 병렬화 구성이 달라지면 미세한 반올림 차이가 누적되어 다른 토큰이 나올 수 있다. 따라서 프로덕션에서는 병렬화 구성을 모델 배포의 일부로 보아야 한다. 모델 버전만 기록하는 것이 아니라 TP, PP, EP, CP 설정까지 함께 기록해야 한다.
작은 예제로 감 잡기
이제 몇 가지 대표 상황을 놓고 병렬화 전략을 골라보자.
먼저 RTX 4090 24GB 두 장으로 70B Q4 모델을 돌리고 싶다고 하자. 모델 가중치만 약 35~45GB 수준이라 단일 4090에는 어렵지만 두 장에는 가능할 수 있다. 다만 4090에는 NVLink가 없고 PCIe 통신만 가능하다. 이 경우 vLLM의 TP=2도 가능하지만, 통신 오버헤드가 크다면 llama.cpp나 일부 런타임의 layer split, 또는 vLLM의 PP를 검토할 만하다. 단일 요청 latency보다 "어쨌든 모델을 안정적으로 올리는 것"이 목표라면 PP가 더 편할 수 있다.
다음으로 H100 SXM 8장이 있는 서버에서 Llama 70B BF16을 서비스한다고 하자. H100 80GB 한 장에는 70B BF16 가중치만으로도 부담이 크다. 하지만 8장에 TP=8로 나누면 GPU당 가중치 부담이 크게 줄고, NVLink 덕분에 TP 통신도 비교적 잘 버틸 수 있다. 이 경우 우선 TP를 검토한다. 처리량이 더 필요하면 같은 TP=8 replica를 여러 세트 띄워 DP처럼 확장한다.
이번에는 2노드, 각 노드 8GPU로 405B급 모델을 구동한다고 하자. 단일 노드의 VRAM으로 부족하거나 KV 캐시 여유가 빠듯하다면, 노드 안에서는 TP=8, 노드 사이는 PP=2를 구성한다. vLLM 문서의 멀티 노드 예시도 이런 형태를 안내한다2. 네트워크가 InfiniBand나 그에 준하는 고속 연결이면 더 안정적이고, 그렇지 않다면 PP stage 간 통신과 batch 구성을 더 보수적으로 잡아야 한다.
마지막으로 DeepSeek 계열 MoE 모델을 높은 동시성으로 서비스한다고 하자. 이때는 dense model처럼 TP만 키우는 접근이 항상 답이 아니다. Expert를 어떻게 분산할지, router가 만든 token dispatch가 GPU 간 all-to-all 통신을 얼마나 만들지, 특정 expert로 부하가 쏠리지 않는지 확인해야 한다. Attention 쪽에서는 DP로 KV 캐시를 요청별로 나누고, expert 쪽에서는 EP를 적용하는 식의 구성이 더 유리할 수 있다.
병렬화 선택이 성능과 안정성을 결정한다
멀티 GPU 시스템에서 성능을 결정하는 것은 GPU 개수만이 아니다. 같은 GPU 8장을 가지고도 TP를 쓸지, PP를 쓸지, DP replica를 늘릴지, MoE expert를 어떻게 나눌지에 따라 결과는 크게 달라진다.
TP는 빠른 GPU 간 통신을 전제로 강력한 낮은 지연시간 전략이다. PP는 큰 모델을 여러 GPU와 노드에 올리는 데 유리하지만 bubble과 latency를 관리해야 한다. DP는 모델이 각 GPU에 들어갈 때 가장 단순하고 안정적인 처리량 확장 방식이다. EP는 MoE 모델에서 expert 가중치와 token routing을 다루는 핵심 전략이다. CP는 긴 컨텍스트 시대에 KV 캐시와 attention 계산의 한계를 sequence 축에서 푸는 전략이다.
이 장의 결론은 단순하다.
멀티 GPU를 잘 쓴다는 것은 GPU를 많이 쓰는 것이 아니라, 올바른 축으로 나누는 것이다.
다음 장부터는 이 원칙을 실제 하드웨어 구성으로 옮겨본다. 소비자용 멀티 GPU 워크스테이션에서는 NVLink가 없는 PCIe 환경을 어떻게 받아들여야 하는지, GPU 슬롯과 전원, 발열, 메인보드 선택이 병렬화 전략에 어떤 영향을 주는지 살펴보게 될 것이다.
참고
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.