
VRAM은 LLM의 작업대다
대형 언어모델을 처음 로컬에서 실행해보려는 사람은 보통 모델 파일 크기부터 확인한다. "이 모델 파일이 45GB니까 48GB VRAM 그래픽카드에는 올라가겠지?"라고 생각하기 쉽다. 숫자만 보면 맞아 보인다. 그러나 실제로 실행 버튼을 누르면 CUDA out of memory, 줄여서 OOM이라는 차가운 에러 메시지가 나타난다.
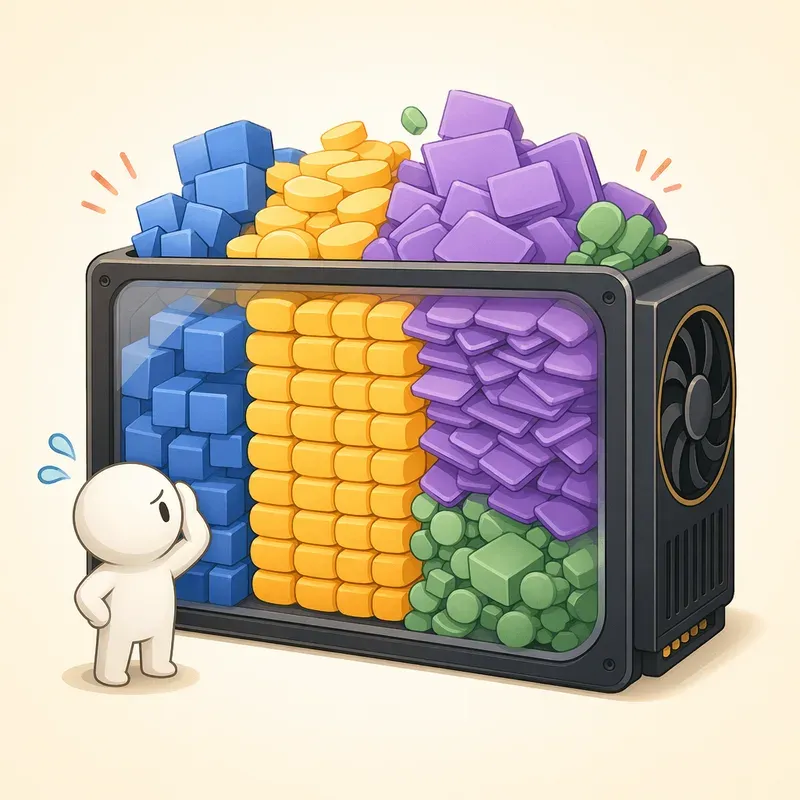
이 현상은 이상한 버그가 아니다. LLM 추론은 단순히 모델 파일 하나를 그래픽카드에 복사해두고 끝나는 작업이 아니기 때문이다. GPU의 VRAM은 모델의 지식을 담은 가중치뿐 아니라, 방금 읽은 문맥을 기억하기 위한 KV 캐시, 계산 중간에 생기는 임시 텐서, CUDA와 프레임워크가 쓰는 작업 공간까지 함께 담아야 한다.
비유하자면 모델 파일은 요리 재료에 가깝다. 하지만 실제 요리를 하려면 재료만 있으면 안 된다. 도마, 냄비, 조리대, 쓰레기통, 잠깐 덜어놓을 그릇도 필요하다. VRAM은 이 모든 것을 올려놓는 작업대다. 재료 봉투가 작업대보다 조금 작다고 해서 요리가 가능한 것은 아니다.
LLM 추론에서 VRAM을 차지하는 큰 덩어리는 다음과 같이 나눌 수 있다.
모델 가중치: 모델이 학습한 파라미터 자체
KV 캐시: 이전 토큰의 attention 정보를 저장해 다음 토큰 생성을 빠르게 만드는 메모리
활성값과 임시 버퍼: 계산 도중 잠깐 필요한 중간 결과와 커널 workspace
런타임 오버헤드: CUDA 컨텍스트, PyTorch·vLLM·TensorRT-LLM 같은 프레임워크 버퍼, 통신 버퍼, 메모리 단편화
이 네 가지를 모두 더해야 "실제로 필요한 VRAM"에 가까워진다. 그래서 멀티 GPU를 이해하는 첫걸음은 "모델 파일 크기보다 왜 훨씬 많은 VRAM이 필요한가"를 이해하는 것이다.
가중치 메모리: 가장 먼저 계산해야 할 하한선
LLM의 크기를 말할 때 자주 등장하는 7B, 13B, 70B, 405B 같은 표기는 파라미터 수를 뜻한다. 7B는 약 70억 개의 파라미터, 70B는 약 700억 개의 파라미터를 가진 모델이라는 의미다. 파라미터는 모델이 학습을 통해 얻은 숫자다. 이 숫자를 어떤 정밀도로 저장하느냐에 따라 필요한 메모리가 달라진다.
가중치 메모리의 기본 공식은 아주 단순하다.
가중치 메모리 = 파라미터 수 × 정밀도(bit) / 8FP16 또는 BF16은 파라미터 하나를 16비트, 즉 2바이트로 저장한다. 따라서 7B 모델을 FP16으로 올리면 가중치만 약 14GB가 필요하다. 70B 모델은 약 140GB, 405B 모델은 약 810GB가 필요하다. 이 숫자는 어디까지나 "가중치만" 계산한 하한선이다.
정밀도별로 보면 감이 더 빨리 온다.
| 모델 규모 | FP16/BF16 | INT8 | INT4 |
|---|---|---|---|
| 7B | 약 14GB | 약 7GB | 약 3.5GB |
| 13B | 약 26GB | 약 13GB | 약 6.5GB |
| 70B | 약 140GB | 약 70GB | 약 35GB |
| 405B | 약 810GB | 약 405GB | 약 202.5GB |
INT8은 8비트, 즉 1바이트로 파라미터를 저장하므로 FP16 대비 절반 수준으로 줄어든다. INT4는 4비트, 즉 0.5바이트로 저장하므로 FP16 대비 4분의 1 수준까지 줄어든다. 이를 양자화라고 부른다. 양자화는 모델의 숫자를 더 낮은 정밀도로 압축해 메모리를 아끼는 기술이다. 여러 VRAM 계산 가이드에서도 모델 가중치 메모리를 "파라미터 수 × 바이트 수"로 잡고, 그 위에 KV 캐시와 런타임 오버헤드를 별도로 더해야 한다고 설명한다1.
하지만 여기서 중요한 함정이 있다. INT4 양자화를 적용해 70B 모델 가중치를 약 35GB까지 줄였다고 해도, 전체 추론 메모리가 35GB가 되는 것은 아니다. 모델이 문장을 읽고 답변을 생성하는 순간, 다른 메모리 사용자가 우르르 들어오기 시작한다.
모델 파일 크기와 필요한 VRAM은 다르다
모델 파일 크기는 대체로 가중치가 디스크에 저장된 크기를 말한다. 반면 필요한 VRAM은 실행 중 GPU가 실제로 붙잡고 있어야 하는 전체 작업 공간이다. 이 둘은 비슷해 보이지만 실전에서는 꽤 다르다.
추론 엔진이 모델을 로드할 때는 가중치를 그대로 읽는 것만으로 끝나지 않는다. 양자화된 가중치를 GPU에서 빠르게 계산하기 좋은 형태로 재배치하거나, 일부 연산을 위해 역양자화할 공간을 잡거나, attention 커널이 사용할 workspace를 확보한다. PyTorch나 CUDA 런타임은 GPU 컨텍스트를 만들고, 메모리 할당자는 앞으로의 연산을 위해 여유 블록을 예약한다. 멀티 GPU라면 NCCL 같은 통신 라이브러리가 버퍼를 추가로 잡는다.
실무에서는 그래서 이론값에 딱 맞춰 GPU를 고르지 않는다. BentoML의 LLM 메모리 계산 예시처럼 간단한 1차 추정에서도 모델 가중치에 10~30% 정도의 오버헤드를 더해 잡는 방식이 흔히 쓰인다2. 실제 서비스에서는 컨텍스트 길이와 동시 요청이 커질수록 이보다 더 보수적으로 잡아야 한다.
"48GB GPU에 45GB짜리 모델이 올라간다"는 계산이 자주 실패하는 이유도 여기에 있다. 48GB VRAM은 빈 창고가 아니다. 모델이 들어오기 전부터 CUDA 컨텍스트와 드라이버가 일부 공간을 사용한다. 모델 로딩 중에는 임시 버퍼가 필요하다. 로딩이 끝나도 KV 캐시를 위한 공간이 필요하다. 메모리 단편화 때문에 전체로는 몇 GB가 남아 보이는데도 연속된 큰 블록을 못 구해 실패할 수 있다.
안정적으로 추론하려면 모델 가중치가 VRAM 총량보다 "충분히" 작아야 한다. 연구실에서 한 번 로딩되는 것과, 실제 사용자가 긴 프롬프트를 보내고 여러 요청이 동시에 들어오는 환경에서 안정적으로 버티는 것은 전혀 다른 문제다.
KV 캐시: 조용히 VRAM을 먹어 치우는 진짜 주범
LLM은 한 번에 긴 문장을 통째로 출력하지 않는다. 다음 토큰 하나를 예측하고, 그 토큰을 다시 입력에 붙여 다음 토큰을 예측한다. 이 과정을 반복해 문장이 만들어진다. 이를 자기회귀 생성이라고 한다.
문제는 매번 새 토큰을 만들 때마다 이전 토큰들을 다시 모두 계산하면 너무 느리다는 점이다. 예를 들어 4,000토큰짜리 문서를 읽고 답변을 생성한다고 해보자. 첫 번째 출력 토큰을 만들 때 문서 전체를 계산했다. 두 번째 출력 토큰을 만들 때 또 문서 전체와 방금 만든 토큰을 처음부터 다시 계산한다면 낭비가 엄청나다.
그래서 LLM은 이전 토큰들의 Key와 Value 값을 저장해둔다. 이것이 KV 캐시다. Key와 Value는 transformer의 attention 연산에서 쓰이는 벡터다. 쉽게 말하면 Key는 "이 토큰이 어떤 단서인가", Value는 "이 토큰이 실제로 제공하는 정보가 무엇인가"에 해당한다. 이전 토큰의 Key와 Value는 새 토큰이 붙어도 바뀌지 않으므로, 한 번 계산한 뒤 저장해두면 다음 생성 단계에서 다시 쓸 수 있다.
KV 캐시는 속도를 얻기 위해 메모리를 지불하는 구조다. 계산은 빨라지지만, 컨텍스트가 길어질수록 저장해야 할 Key와 Value가 계속 늘어난다.
일반적인 KV 캐시 메모리는 다음에 비례한다.
KV 캐시 메모리
≈ 레이어 수 × KV 헤드 수 × 헤드 차원 × 2(K와 V) × 토큰 수 × 배치 크기 × 원소당 바이트 수
조금 더 수식처럼 쓰면 다음과 같다.
M_kv = 2 × L × H_kv × D_head × S × B × bytes여기서 L은 레이어 수, H_kv는 KV 헤드 수, D_head는 헤드 차원, S는 시퀀스 길이, B는 동시 처리 시퀀스 수 또는 배치 크기다. 앞의 2는 Key와 Value 두 종류를 모두 저장하기 때문에 붙는다. 최신 모델은 GQA, 즉 Grouped Query Attention을 사용해 Query 헤드보다 KV 헤드 수를 줄이는 경우가 많다. 이 구조 덕분에 KV 캐시가 크게 줄지만, 사라지는 것은 아니다. Spheron의 LLM 메모리 가이드도 KV 캐시가 레이어 수, KV 헤드 수, 헤드 차원, 컨텍스트 길이, 배치 크기에 선형으로 늘어난다고 설명한다3.
여기서 가장 중요한 말은 "선형으로 늘어난다"이다. 컨텍스트 길이를 4K에서 32K로 늘리면 KV 캐시도 대략 8배가 된다. 동시 요청을 1개에서 8개로 늘리면 KV 캐시도 다시 8배가 된다. 즉 컨텍스트와 동시성이 함께 늘어나면 VRAM 사용량은 순식간에 폭발한다.
같은 모델도 4K, 32K, 128K에서 완전히 달라진다
가상의 Llama 계열 7B·8B급 모델을 생각해보자. 레이어 32개, KV 헤드 8개, 헤드 차원 128, KV 캐시 정밀도 BF16 또는 FP16이라고 하면 토큰 하나당 KV 캐시는 다음과 같다.
2 × 32 × 8 × 128 × 2 bytes = 131,072 bytes즉 토큰 하나에 약 128KB가 필요하다. 별것 아닌 것처럼 보인다. 하지만 토큰은 하나만 있는 것이 아니다.
| 컨텍스트 길이 | 단일 요청 KV 캐시 | 동시 요청 8개 |
|---|---|---|
| 4K | 약 0.5GB | 약 4GB |
| 32K | 약 4GB | 약 32GB |
| 128K | 약 16GB | 약 128GB |
이제 7B 모델을 INT4로 양자화해 가중치를 약 3.5~5GB 수준으로 줄였다고 해보자. 4K 컨텍스트의 단일 요청에서는 아주 여유로워 보인다. 그러나 128K 컨텍스트에서는 단일 요청의 KV 캐시만 약 16GB가 된다. 동시 요청 8개라면 KV 캐시만 약 128GB다. 가중치 절감으로 아낀 메모리를 KV 캐시가 순식간에 먹어 치운다.
70B 모델에서는 이 현상이 더 극적이다. Llama 3.1 70B처럼 80개 레이어와 8개 KV 헤드, 128 차원 헤드를 쓰는 모델은 BF16 기준 토큰당 KV 캐시가 약 0.31MB 수준이다. 128K 컨텍스트 단일 요청만으로도 KV 캐시가 약 40GB에 이른다는 계산이 나온다4. FP16 가중치 140GB에 이 40GB가 추가된다. 만약 같은 길이의 요청을 4개 동시에 처리하면 KV 캐시만 약 160GB가 된다.
이쯤 되면 "70B 모델이 왜 GPU 한 장에 안 올라가지?"라는 질문은 조금 더 정확하게 바뀐다. 문제는 70B 가중치만이 아니다. 70B 가중치에 긴 컨텍스트, 동시 요청, 런타임 오버헤드가 모두 더해진 총량이 GPU 한 장의 VRAM을 넘어서는 것이다.
작은 모델도 긴 컨텍스트에서는 무너진다
많은 사용자가 처음에는 7B나 13B 모델을 고른다. "작은 모델이니까 괜찮겠지"라고 생각한다. 실제로 짧은 프롬프트와 단일 사용자 환경에서는 대체로 괜찮다. 7B 모델을 4비트로 양자화하면 8GB 또는 12GB VRAM 카드에서도 실행할 수 있다. 13B 모델도 양자화와 적절한 컨텍스트 제한을 사용하면 16GB 또는 24GB 카드에서 시도해볼 수 있다.
하지만 긴 문서 요약, 코드베이스 분석, RAG 검색 결과를 많이 붙이는 챗봇, 에이전트처럼 긴 대화 기록을 계속 유지하는 작업에서는 상황이 달라진다. 입력 프롬프트가 길어지고, 모델이 생성하는 토큰이 늘어나고, 사용자가 여러 명이 되면 KV 캐시는 요청마다 따로 쌓인다.
예를 들어 13B 모델을 INT4로 줄여 가중치를 약 6.5GB 수준으로 만들었다고 하자. 여기에 32K 컨텍스트, 여러 명의 동시 사용자, 프레임워크 오버헤드가 붙으면 24GB VRAM에서도 불안정해질 수 있다. 모델 파일만 보면 충분히 들어갈 것 같지만, 실제 병목은 가중치가 아니라 KV 캐시와 임시 버퍼가 된다.
이것이 로컬 추론에서 자주 보이는 이상한 현상의 정체다. 모델은 로드된다. 짧은 질문에는 답도 한다. 그런데 긴 PDF를 넣거나, 채팅 기록이 길어지거나, 브라우저 탭 여러 개에서 동시에 요청을 보내면 갑자기 OOM이 난다. 모델이 갑자기 커진 것이 아니다. 문맥을 기억하기 위한 메모리가 커진 것이다.
컨텍스트는 공짜가 아니다
최근 모델들은 32K, 128K, 1M 컨텍스트를 지원한다고 홍보한다. 긴 컨텍스트는 분명 강력하다. 긴 보고서를 통째로 넣고 질문하거나, 코드 저장소의 여러 파일을 한 번에 넣거나, 복잡한 에이전트 작업 기록을 유지할 수 있다.
그러나 "지원한다"와 "내 GPU에서 안정적으로 서비스할 수 있다"는 다르다. 컨텍스트 길이는 모델이 한 번에 볼 수 있는 최대 토큰 수다. 이 토큰 수가 늘어날수록 KV 캐시가 늘어난다. 단일 사용자 실험에서는 32K가 가능해도, 실제 서비스에서 10명이 동시에 32K 요청을 보내면 필요한 VRAM은 완전히 달라진다.
또한 컨텍스트는 입력 프롬프트만 뜻하지 않는다. 사용자가 넣은 프롬프트, 시스템 프롬프트, 검색으로 붙인 문서, 이전 대화 기록, 그리고 모델이 새로 생성하는 답변 토큰까지 모두 포함된다. "입력은 20K이고 출력은 4K니까 총 24K"처럼 계산해야 한다. max_new_tokens 값을 크게 잡아두면 실제 생성이 길어질 때 KV 캐시가 계속 증가한다.
그래서 LLM 서버를 운영할 때는 모델의 최대 컨텍스트 길이를 그대로 열어두지 않는 경우가 많다. 실제 업무에 필요한 최대 길이를 정하고, 그에 맞춰 max_model_len, max_tokens, 동시 요청 수를 제한한다. vLLM 같은 추론 엔진이 PagedAttention으로 KV 캐시 단편화를 줄여주더라도, 캐시 자체가 필요한 물리적 메모리까지 없애주지는 못한다. vLLM의 PagedAttention은 KV 캐시를 고정 블록처럼 나눠 필요한 만큼 할당해 낭비와 단편화를 줄이는 방식으로 설명된다5.
48GB GPU와 45GB 모델의 실패 사례
이제 실전에서 자주 벌어지는 장면을 하나 따라가 보자. 사용자는 48GB VRAM을 가진 GPU를 샀다. 모델 파일은 45GB다. 계산상 3GB가 남는다. 충분해 보인다.
하지만 실행 과정은 이렇게 흘러간다.
먼저 CUDA 컨텍스트가 생성된다. 이때 수백 MB에서 1GB 안팎의 메모리가 사라질 수 있다. 그다음 추론 프레임워크가 자체 버퍼를 잡는다. PyTorch 기반이면 allocator가 메모리를 넉넉히 예약할 수 있고, vLLM이면 KV 캐시 풀을 위해 큰 영역을 미리 잡을 수 있다. 모델 로딩 중에는 체크포인트를 읽고 GPU 텐서로 변환하는 임시 공간도 필요하다.
양자화 모델이라면 끝이 아니다. 4비트로 저장된 가중치를 GPU 커널이 빠르게 처리할 수 있는 레이아웃으로 바꾸거나, 일부 연산에서 스케일 값과 함께 처리하기 위한 workspace가 필요하다. attention 연산은 임시 버퍼를 요구할 수 있고, 샘플링 단계에서도 logits와 후보 토큰을 다루는 공간이 필요하다.
그리고 결정적으로, 사용자가 프롬프트를 보내는 순간 KV 캐시가 생긴다. 짧은 프롬프트 하나라면 넘어갈 수도 있다. 그러나 8K, 16K, 32K 문맥을 넣는 순간 남아 있던 3GB는 금방 사라진다. 여기에 메모리 단편화까지 겹치면 nvidia-smi에는 약간의 여유가 보이는데도 새 텐서를 할당하지 못해 OOM이 발생할 수 있다.
그래서 안정적인 운영에서는 "간신히 로드되는가"가 아니라 "최악의 프롬프트와 동시 요청에서도 버티는가"를 기준으로 본다. 모델 가중치가 VRAM의 90% 이상을 차지하는 구성은 대부분 위험하다. 짧은 데모는 가능할 수 있지만, 서비스나 장시간 작업에서는 쉽게 흔들린다.
양자화는 만능 열쇠가 아니다
양자화는 매우 강력한 도구다. 70B 모델을 FP16으로 실행하면 가중치만 약 140GB가 필요하지만, INT4로 줄이면 약 35GB 수준까지 내려간다. 이 차이는 엄청나다. 소비자용 멀티 GPU 워크스테이션이나 단일 고용량 GPU에서 더 큰 모델을 시도할 수 있게 해준다.
그러나 양자화가 줄이는 것은 주로 모델 가중치다. KV 캐시는 별도로 존재한다. 많은 환경에서 KV 캐시는 여전히 FP16 또는 BF16으로 저장된다. 일부 프레임워크는 KV 캐시를 FP8, INT8, INT4 등으로 줄이는 기능을 제공하지만, 이것도 품질과 하드웨어 지원, 커널 지원을 확인해야 한다.
따라서 "4비트 모델이니까 VRAM은 무조건 4분의 1"이라는 말은 절반만 맞다. 가중치는 4분의 1이 될 수 있다. 하지만 전체 VRAM은 가중치, KV 캐시, 활성값, 런타임 오버헤드를 합친 값이다. 특히 긴 컨텍스트와 높은 동시성에서는 KV 캐시가 전체 메모리의 주인공이 된다.
이 점은 MoE 모델에서도 비슷하게 나타난다. MoE, 즉 Mixture of Experts 모델은 토큰마다 일부 전문가만 활성화한다. 그래서 계산량은 "활성 파라미터" 기준으로 줄어들 수 있다. 하지만 모든 전문가 가중치는 필요할 때 바로 호출될 수 있도록 메모리에 올라가 있어야 한다. 즉 MoE는 계산량을 줄여도 가중치 저장 메모리를 자동으로 줄여주지는 않는다. 이 주제는 뒤에서 MoE 모델과 전문가 병렬을 다룰 때 더 자세히 살펴볼 것이다.
VRAM 계산은 '평균'이 아니라 '최악의 순간'을 봐야 한다
LLM 추론에서 OOM은 평균 사용량이 아니라 순간 최대 사용량에서 터진다. 평소에는 35GB만 쓰다가도, 긴 프롬프트가 들어오고, 동시에 몇 개의 요청이 붙고, 프레임워크가 큰 임시 버퍼를 잡는 순간 48GB 한계를 넘을 수 있다.
실무적인 1차 계산은 다음처럼 잡는 편이 안전하다.
총 VRAM ≈ 모델 가중치 + KV 캐시 + 활성값/임시 버퍼 + 런타임 오버헤드 + 안전 여유조금 더 거칠게 시작하려면 다음과 같이 볼 수 있다.
총 VRAM ≈ 모델 가중치 + KV 캐시 + 10~30% 이상의 오버헤드단, 이 10~30%는 짧은 컨텍스트와 낮은 동시성에서의 출발점일 뿐이다. 32K 이상의 긴 컨텍스트나 다중 사용자 서빙에서는 KV 캐시를 반드시 별도로 계산해야 한다. 모델 가중치에 단순히 20%만 더하는 방식은 긴 컨텍스트 환경에서 크게 빗나갈 수 있다.
좋은 질문은 "이 모델이 내 GPU에 올라가나요?"가 아니다. 더 정확한 질문은 다음과 같다.
어떤 정밀도 또는 양자화 형식으로 실행할 것인가?
최대 컨텍스트 길이는 몇 토큰인가?
동시에 몇 개의 요청을 처리할 것인가?
KV 캐시는 어떤 정밀도로 저장할 것인가?
어떤 추론 엔진을 사용할 것인가?
로딩 순간과 피크 트래픽을 견딜 안전 여유는 얼마나 둘 것인가?
이 질문에 답해야 비로소 GPU 한 장으로 가능한지, 여러 장을 묶어야 하는지, CPU 오프로딩을 감수할지, 아예 클러스터로 가야 하는지 판단할 수 있다.
단일 GPU의 한계는 '모델이 커서'만이 아니다
대형 언어모델이 GPU 한 장에 올라가지 않는 이유를 한 문장으로 줄이면 이렇다. 모델 가중치, KV 캐시, 컨텍스트 길이, 배치 크기, 런타임 오버헤드가 동시에 VRAM을 점유하기 때문이다.
가중치는 파라미터 수와 정밀도에 따라 정해지는 고정 비용이다. KV 캐시는 컨텍스트 길이와 동시 요청 수에 따라 늘어나는 동적 비용이다. 활성값과 임시 버퍼는 연산이 진행되는 동안 필요한 작업 공간이다. CUDA와 프레임워크는 실행 환경을 유지하기 위한 기본 비용을 요구한다. 이 비용들이 한꺼번에 GPU 한 장의 VRAM 안에 들어와야 한다.
단일 GPU가 충분하지 않을 때 선택지는 크게 세 방향으로 갈라진다. 모델 자체를 줄이거나, 메모리 사용을 줄이거나, 메모리를 여러 장치에 나누는 것이다. 양자화와 KV 캐시 최적화는 메모리 사용을 줄이는 방법이다. CPU 오프로딩은 일부 부담을 시스템 RAM으로 넘기는 방법이다. 텐서 병렬화와 파이프라인 병렬화는 모델과 계산을 여러 GPU에 나누는 방법이다. 멀티 노드 클러스터링은 이 아이디어를 여러 서버로 확장한다.
앞으로의 장에서는 이 병목을 실제로 어떻게 계산하고, 어떤 하드웨어를 고르며, 어떤 프레임워크로 여러 GPU를 묶고, 나아가 Mac mini나 NVIDIA Spark급 소형 AI 노드를 어떻게 클러스터로 확장할 수 있는지 살펴볼 것이다. 하지만 그 모든 기술의 출발점은 같다. VRAM은 모델 파일만 담는 공간이 아니다. LLM이 생각하고, 기억하고, 동시에 여러 사람에게 답하기 위해 필요한 전체 작업대다.
참고
1GPU Memory Requirements for LLMs: VRAM Calculator
2Calculating GPU memory for serving LLMs
3LLM VRAM Calculator: GPU Memory Requirements for Large Language Models
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.