


로봇 파운데이션 모델이라는 말은 그럴듯하게 들린다. 마치 언어모델이 문장을 읽고 세상을 이해하듯, 거대한 로봇 모델이 온갖 집안일을 한 번에 배울 것처럼 보이기 때문이다. 실제로 최근 흐름은 그 방향으로 움직이고 있다. 여러 연구기관은 서로 다른 로봇과 작업에서 모은 데이터를 한데 묶어, 하나의 큰 정책이 여러 몸과 여러 과제를 가로질러 통하도록 만들려 한다.1
하지만 여기에는 텍스트 AI와는 다른, 아주 로봇다운 난제가 숨어 있다. 언어모델은 같은 문장을 어디서 읽어도 문장 자체는 크게 바뀌지 않는다. 반면 로봇은 같은 "컵 집기"라도 몸이 달라지면 행동의 의미 자체가 달라진다. 카메라가 위에서 보느냐 옆에서 보느냐, 관절 수가 몇 개냐, 그리퍼가 잘 미끄러지느냐 꽉 물리느냐, 바퀴가 있느냐 없느냐에 따라 정답 행동이 달라진다. 로봇의 지능은 입력과 출력만의 문제가 아니라, 몸과 물리와 제어가 한 덩어리로 묶인 문제다.
바로 이 지점에서 ALOHA 계열 데이터가 특별한 의미를 갖는다. ALOHA, Mobile ALOHA, ALOHA 2는 단순히 저렴한 로봇 플랫폼이 아니다. 로봇 파운데이션 모델 시대에 필요한, 재현 가능하고 전이 가치가 높은 행동 데이터를 꾸준히 생산하는 데이터 공장에 가깝다.234
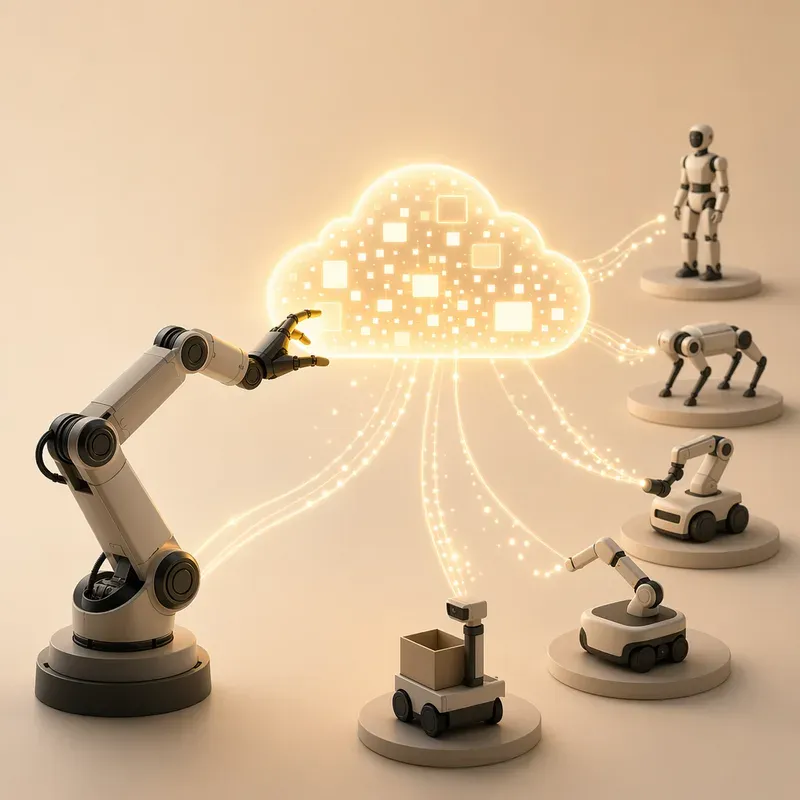
로봇 파운데이션 모델은 왜 언어모델과 다르게 자라는가
언어모델은 대체로 다음 토큰 예측이라는 공통 과제를 중심으로 스케일링됐다. 문장이 길어지든 도메인이 넓어지든, 기본적인 학습 형식은 비교적 단순하다. 더 많은 텍스트, 더 큰 모델, 더 긴 문맥이 성능 향상으로 이어지는 경향이 뚜렷했다.
로봇은 다르다. 로봇 모델이 풀어야 하는 것은 관측에서 행동으로 이어지는 제어 문제다. 여기서 관측은 카메라 영상, 관절 상태, 때로는 깊이 정보나 힘 정보까지 포함한다. 행동은 단순한 단어가 아니라 실제 모터 명령, 관절 목표값, 속도, 그리퍼 개폐량이 된다. 그리고 이 행동은 곧바로 현실 세계의 물리와 충돌한다.
그래서 로봇의 스케일링은 단순히 데이터 양을 늘린다고 같은 속도로 좋아지지 않는다. 오히려 다음 세 가지에 훨씬 더 민감하다.
데이터가 어떤 몸에서 나왔는가
그 몸의 행동이 다른 몸으로 얼마나 옮겨질 수 있는가
시연의 품질이 접촉이 많은 장면까지 버틸 만큼 충분히 정밀한가
이 차이를 쉽게 비유하면 이렇다. 언어모델은 여러 사람이 쓴 글을 모아도 대부분 같은 언어 체계를 공유한다. 하지만 로봇 데이터는 여러 사람이 쓴 글이 아니라, 서로 다른 악기로 연주한 동작 악보다. 같은 멜로디처럼 보여도 피아노 악보를 바이올린 활 긋기로 그대로 옮길 수는 없다.
RT-X와 Open X-Embodiment가 보여준 가능성
그렇다고 해서 로봇에서 범용 모델이 불가능하다는 뜻은 아니다. 오히려 최근 흐름은 반대다. Open X-Embodiment는 20개가 넘는 서로 다른 로봇 embodiment에서 수집한 100만 개 이상의 실제 궤적을 표준 형식으로 묶고, 그 위에서 RT-X 계열 모델을 학습해 교차 로봇 전이 가능성을 보여 주었다.1 이 흐름의 핵심 메시지는 분명하다. 로봇도 다양한 데이터가 모이면 더 넓은 일반화를 얻을 수 있다.
다만 이 결과를 읽을 때 흔히 놓치는 점이 있다. 중요한 것은 "모든 데이터를 다 섞었더니 magically 해결됐다"가 아니다. 실제로는 표준화된 데이터 형식, 공통 행동 표현, 과제 설명 방식 같은 정렬 작업이 함께 들어가야 했다.1 다시 말해 로봇 파운데이션 모델의 시대는 단지 큰 모델의 시대가 아니라, 큰 정리의 시대이기도 하다.
이 맥락에서 RT 계열은 로봇판 사전학습의 가능성을 보여 준다. 여러 연구실이 제각기 만든 데이터를 연결하면, 각 로봇이 혼자 배울 때보다 더 넓은 경험을 공유할 수 있다. 한 연구실의 실패와 성공이 다른 연구실의 출발점이 되는 셈이다. 로봇이 드디어 "남의 경험"으로 배우기 시작한 것이다.
ALOHA 데이터가 맡는 희귀한 역할
이 거대한 흐름 속에서 ALOHA의 역할은 꽤 독특하다. ALOHA는 원래부터 저비용 양손 원격조작과 데이터 수집을 목적으로 설계된 오픈소스 하드웨어 시스템이었다.2 이 말은 곧, 데이터 생산의 문턱을 낮추도록 태어난 플랫폼이라는 뜻이다.
이 점이 왜 중요할까. 로봇 파운데이션 모델은 결국 다양한 실제 행동 데이터가 필요하다. 그런데 실제 로봇 데이터는 텍스트처럼 인터넷에 널려 있지 않다. 누군가가 몸소 시연하고, 센서를 맞추고, 하드웨어를 유지하고, 실패를 정리해서 기록해야 한다. 여기서 저비용·오픈소스·재현 가능성은 단순한 제작 편의가 아니라 데이터 생태계의 성장률을 좌우하는 변수다.
특히 ALOHA와 Mobile ALOHA는 범용 로봇이 꼭 만나게 되는 두 영역을 강하게 겨냥한다. 하나는 양손 조작이고, 다른 하나는 이동이 결합된 조작이다.23 다시 말해 이 플랫폼은 단순 pick-and-place보다 훨씬 현실에 가까운 행동을 모은다. 주방, 정리, 세탁, 문 열기, 물체 지지와 비틀기 같은 과제는 가정형 로봇이 결국 넘어야 할 산인데, ALOHA 계열은 바로 그 산의 데이터화를 시도한다.
희소성도 크다. 공개적으로 재현 가능한 플랫폼 중에서, 양손 시연 데이터를 꾸준히 생산하고, 나아가 Mobile ALOHA처럼 전신 조작까지 연결하는 계열은 흔치 않다.3 그래서 ALOHA 데이터의 전략적 가치는 "양이 많은 데이터"라기보다 "다른 곳에서 구하기 어려운 데이터"라는 데 있다.
가장 어려운 문제는 데이터 병합이 아니라 데이터 정렬이다
여러 embodiment의 데이터를 함께 학습할 때 가장 먼저 부딪히는 벽은 포맷이 아니라 의미다. 파일을 하나의 폴더에 넣는 것은 쉽다. 하지만 로봇에게는 같은 숫자열도 서로 다른 뜻을 가진다.
정렬이 필요한 축은 크게 세 가지다.
관측 공간 정렬: 카메라 위치, 해상도, 시야각, 깊이 정보 유무가 다르면 같은 장면도 전혀 다르게 보인다.
행동 공간 정렬: 어떤 로봇은 관절 각도를 내보내고, 어떤 로봇은 말단효과기 좌표를 내보내며, 어떤 로봇은 그리퍼를 연속값으로, 어떤 로봇은 이산 명령으로 표현한다.
성공 조건 정렬: 한 데이터셋에서의 성공은 "문이 열림"일 수 있고, 다른 데이터셋에서는 "컵을 들고 지정 위치까지 이동"일 수 있다.
이 세 축이 어긋나면 단순 병합은 생각보다 도움이 되지 않는다. 모델은 데이터가 많아졌다고 좋아하는 것이 아니라, 서로 다른 데이터 사이의 공통 구조를 찾아낼 수 있을 때 좋아진다. 그래서 로봇 파운데이션 모델에는 공통 표현 학습이 중요하다. 관측은 서로 달라도 "지금 손이 물체를 지지하는 중인가", "접촉 직전인가", "양손 협응이 필요한가" 같은 추상 구조를 공유해야 한다. 행동도 각 로봇의 로우레벨 명령 그대로보다, 가능한 한 상위 수준의 공통 스키마로 변환할 필요가 있다.
이 작업은 귀찮은 전처리가 아니다. 사실상 로봇판 번역기 만들기다. 프랑스어와 한국어 문장을 같은 벡터 공간에 올리는 것처럼, 서로 다른 로봇의 행동을 같은 행동 의미 공간으로 옮겨야 한다. 파운데이션 모델의 성패가 데이터 규모만큼이나 이 번역기의 품질에 달려 있는 이유다.
embodiment gap은 몸체 차이보다 더 깊은 문제다
embodiment gap이라는 표현은 흔히 "로봇 몸이 다르다"는 뜻으로 이해된다. 물론 맞는 말이다. 하지만 실제 의미는 더 깊다. 같은 시연이 다른 몸에서는 다른 물리적 사건이 된다는 뜻에 가깝다.
예를 들어 양손으로 병을 잡아 지지한 뒤 뚜껑을 비트는 장면을 생각해 보자. ALOHA처럼 두 손이 비슷한 작업 공간을 공유하고, 그리퍼가 충분한 마찰을 제공하며, 두 팔이 동시에 미세 조정을 할 수 있으면 이 동작은 하나의 자연스러운 협응 패턴이 된다. 하지만 단일 팔 로봇에서는 애초에 같은 전략을 쓸 수 없다. 그리퍼가 미끄러운 로봇에서는 비틀기 토크를 견디지 못할 수 있다. Mobile ALOHA처럼 이동 베이스까지 포함된 시스템에서는 "행동"의 단위가 손 궤적만이 아니라, 몸을 어디에 세우고 어떤 각도로 접근할지까지 포함하는 전신 협응으로 커진다.3
즉 embodiment gap은 단순한 입력 차이도, 출력 차이도 아니다. 행동의 문법 자체가 달라지는 문제다. 그래서 교차 embodiment 학습은 데이터를 많이 섞는 일이라기보다, "같아 보이지만 사실은 다른 행동"을 구분하고, "다르게 보이지만 사실은 같은 기술"을 묶는 일에 가깝다.
여기서 ALOHA 계열은 좋은 기준점을 제공한다. 원래 ALOHA, ALOHA 2, Mobile ALOHA는 서로 완전히 같은 몸은 아니지만, 연속성이 있다. 양손 조작이라는 핵심이 유지되고, 인터페이스와 데이터 수집 철학도 이어진다.234 그래서 이 계열은 embodiment gap을 완전히 없애진 못해도, 제어 가능한 범위 안에서 점진적으로 넓혀 가는 데 유리하다. 로봇 데이터 스케일링의 현실적 경로가 바로 이런 식일 가능성이 크다. 한 번에 모든 몸을 통합하기보다, 관련성 높은 몸들을 연결하며 확장하는 것이다.
ALOHA 2 이후에는 왜 고품질 시연의 값이 더 올라가는가
파운데이션 모델 시대가 오면, 흔히 "이제는 큰 모델이 알아서 해 줄 것"이라고 기대하기 쉽다. 그러나 실제로는 반대다. 모델이 커질수록 고품질 시연 데이터의 가치가 더 올라간다.
ALOHA 2는 바로 이 점을 겨냥해 개선됐다. 저마찰 리더·팔로워 그리퍼, 인체공학을 고려한 텔레오퍼레이션, 수동 중력 보상, 더 작은 D405 카메라와 멀티뷰 구성, 그리고 시스템 식별을 거친 MuJoCo 모델 공개는 모두 한 방향을 가리킨다. 사람의 시연을 더 오래, 더 편하게, 더 정밀하게, 더 재현 가능하게 만들자는 것이다.4 이것은 단순한 사용성 개선이 아니다. 데이터의 신호 대 잡음비를 끌어올리는 일이다.
그 효과는 접촉이 많은 과제에서 특히 크다. 물체를 살짝 밀고, 지지하고, 끼우고, 비틀고, 구겨지는 물체를 다루는 장면은 원래 작은 오차가 곧 실패로 이어진다. 이런 장면에서는 어설픈 시연 1,000개보다 정밀한 시연 100개가 더 값질 때가 많다. ALOHA Unleashed가 ALOHA 2 위에서 대규모 시연 수집과 표현력 높은 정책을 결합해, 변형 물체와 복잡한 접촉 동역학이 있는 양손 작업까지 밀어붙인 것은 이 사실을 잘 보여 준다.5
결국 파운데이션 모델 시대의 경쟁력은 "누가 더 큰 모델을 갖고 있나"만으로 정해지지 않는다. 누가 더 좋은 손맛으로 데이터를 모으고, 누가 더 긴 작업을 안정적으로 시연하며, 누가 더 섬세한 접촉을 기록하느냐가 점점 더 중요해진다.
ALOHA 계열 데이터는 웹의 대체재가 아니라 고신호 행동 데이터다
로봇 분야에서는 종종 이런 유혹이 있다. 언젠가 로봇도 인터넷 텍스트처럼 거대한 범용 데이터 위에 올라타게 되지 않을까 하는 기대다. 물론 장기적으로는 로봇 데이터도 크게 늘어날 것이다. 하지만 당분간 ALOHA 계열 데이터의 의미를 "로봇판 웹 데이터"로 보는 것은 정확하지 않다.
오히려 더 정확한 표현은 이것이다. ALOHA 데이터는 희소하지만 전이 가치가 큰 고신호 행동 데이터다. 양이 무한히 많진 않지만, 하나하나가 실제 조작 기술의 핵심을 진하게 담고 있다. 그리고 오픈소스 하드웨어와 수집 파이프라인 덕분에 다른 연구실과 스타트업이 같은 계열의 데이터를 추가 생산할 수 있다.24 이 점이 중요하다. 파운데이션 모델에 필요한 데이터 네트워크 효과는 반드시 중앙집중식 거대 기업만 만들 수 있는 것이 아니라, 재현 가능한 플랫폼을 중심으로도 자라날 수 있기 때문이다.
이런 네트워크 효과는 느리지만 강하다. 누군가 한 번 만든 플랫폼을 다른 팀이 복제하고, 비슷한 관측 구조와 비슷한 행동 공간에서 새 과제를 추가하고, 그 데이터가 다시 다음 모델의 사전학습 자산이 된다. 오늘의 설거지 시연이 내일의 정리 작업을 돕고, 내일의 정리 데이터가 모레의 도구 사용을 돕는 식이다. 이것이야말로 로봇에서 현실적인 스케일링 경로다.
더 큰 모델보다 더 좋은 연결이 중요하다
로봇 파운데이션 모델의 미래는 분명 매력적이다. 여러 몸, 여러 작업, 여러 환경을 아우르는 공통 정책은 로봇 연구의 오랜 꿈이었다. 하지만 그 꿈은 텍스트 AI와 같은 방식으로 오지 않을 가능성이 크다. 로봇의 스케일링 법칙은 데이터의 총량만이 아니라 embodiment의 유사성, 행동 표현의 정렬, 시연 품질의 정밀도에 더 민감하게 반응한다.
이 관점에서 보면 ALOHA 계열의 전략적 의미도 또렷해진다. ALOHA는 범용 웹 데이터의 대체재가 아니다. 대신 파운데이션 모델이 실제 세계의 손기술을 배우는 데 필요한, 드물고 정제된 행동 데이터를 공급한다. Mobile ALOHA는 그 범위를 테이블 밖으로 넓히고, ALOHA 2는 그 데이터의 품질을 더 높인다.34
로봇 AI의 다음 경쟁은 단순히 누가 더 많은 파라미터를 쌓느냐가 아닐 것이다. 누가 더 관련성 높은 몸들을 연결하고, 누가 더 정렬된 행동 표현을 만들고, 누가 더 좋은 시연 데이터를 지속적으로 생산하느냐가 승부를 가를 가능성이 크다. 그리고 그 싸움의 한가운데에, ALOHA 같은 데이터 수집 하드웨어가 있다. 로봇의 범용성은 공중에서 떨어지지 않는다. 결국 누군가의 손이 남긴 좋은 행동 데이터에서 자란다.
참고
1Open X-Embodiment: Robotic Learning Datasets and RT-X Models
3Mobile ALOHA: Learning Bimanual Mobile Manipulation with Low-Cost Whole-Body Teleoperation
4ALOHA 2: An Enhanced Low-Cost Hardware for Bimanual Teleoperation
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.