


MVP 하네스가 처음 성공하는 순간은 대개 짜릿하다. 한 명의 사용자가 요청을 넣으면, 에이전트가 문서를 읽고, 도구를 한두 번 호출하고, 그럴듯한 결과를 내놓는다. 팀은 금세 확신에 찬다. "됐다. 이제 붙이기만 하면 된다."
하지만 제품은 바로 그다음부터 시작된다.
사용자가 한 명에서 열 명이 되면 어떤 요청이 먼저 처리되어야 하는지 정해야 한다. 요청이 5초 안에 끝나지 않고 5분을 넘기기 시작하면 브라우저 연결에 기대서는 안 된다. 에이전트가 중간까지 잘하다가 서버가 재시작되면, 어디까지 했는지 기억해야 한다. 같은 작업이 반복해서 실패하면 그 실패를 데이터로 모아 평가해야 하고, 운영자는 지금 무슨 일이 벌어지는지 대시보드에서 볼 수 있어야 한다.
이때 비로소 분명해진다. 프로토타입과 제품의 차이는 기능 수가 아니다. 운영 구조의 유무다.
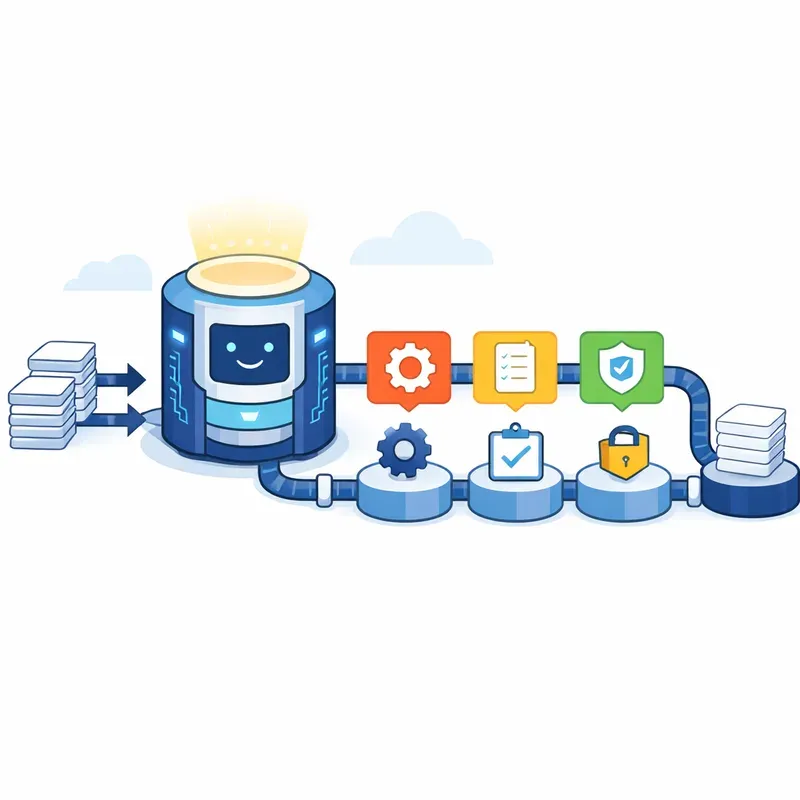
MVP와 프로덕션의 진짜 차이
MVP 하네스는 작은 작업대를 만드는 일에 가깝다. 한 사람이 옆에 서서 보고, 문제가 생기면 손으로 멈출 수 있다. 반면 프로덕션 하네스는 공장에 더 가깝다. 작업이 여러 줄로 들어오고, 누가 어떤 재료를 썼는지 기록이 남아야 하며, 중간에 멈췄을 때도 다시 이어서 돌아가야 한다.
이 차이를 자꾸 기능의 차이로 오해하면 이상한 일이 벌어진다. 팀은 도구를 더 붙이고, 프롬프트를 더 길게 쓰고, 멀티에이전트를 얹는다. 그런데 정작 사용자 수가 늘면 더 자주 멈춘다. 이유는 단순하다. 기능은 늘었지만 운영 구조는 비어 있기 때문이다.
운영 구조가 있다는 말은 보통 다음을 뜻한다.
요청이 동시에 들어와도 순서와 자원이 관리된다.
실행이 길어져도 중간 상태를 잃지 않는다.
실패가 생기면 어디서 왜 멈췄는지 추적할 수 있다.
품질이 좋아졌는지 나빠졌는지 반복적으로 측정할 수 있다.
비용과 시간, 승인, 보안 같은 현실 제약이 시스템 안에 반영된다.
좋은 프로덕션 하네스는 에이전트를 더 똑똑하게 보이게 만드는 장치가 아니다. 에이전트가 실제 서비스 환경에서 오래 버티게 만드는 장치다.
단일 사용자 사고방식에서 멀티 사용자 사고방식으로
MVP 단계에서는 보통 하나의 요청만 떠올린다. "사용자가 질문하면, 에이전트가 답한다." 이 그림은 단순해서 이해하기 쉽다. 하지만 제품에서는 질문이 줄 서서 들어온다. 같은 순간에 여러 사용자가 서로 다른 작업을 요청하고, 어떤 작업은 금방 끝나지만 어떤 작업은 오래 걸린다.
이때 가장 먼저 바뀌어야 하는 것은 사고방식이다. 프로덕션에서는 더 이상 "한 번의 실행"을 관리하는 것이 아니라, 여러 작업의 흐름을 관리해야 한다.
예를 들어 사내 문서 요약 에이전트를 생각해 보자. 한 명이 쓸 때는 문서를 읽고 요약해 돌려주면 끝이다. 그러나 팀 전체가 쓰기 시작하면 상황이 달라진다. 누군가는 짧은 회의록을 넣고, 누군가는 수십 개 파일이 달린 제안서를 넣는다. 누군가는 지금 당장 결과가 필요하고, 누군가는 백그라운드에서 돌아가도 괜찮다. 이런 차이를 다 같은 방식으로 처리하면 시스템은 금방 비효율적이 된다.
그래서 프로덕션 하네스에는 보통 작업 단위라는 개념이 생긴다. 사용자 요청을 즉시 끝내야 할 대화형 요청인지, 뒤에서 오래 돌려도 되는 비동기 작업인지, 사람 승인 대기 상태인지, 실패 후 재시도 가능한 작업인지 구분하는 것이다. 이 구분이 있어야만 멀티 사용자 환경에서 질서를 만들 수 있다.
동기 호출에서 비동기 작업으로 넘어가야 할 순간
많은 팀이 처음에는 HTTP 요청 하나로 에이전트를 끝까지 돌리려 한다. 작은 데모에서는 이 방식이 잘 맞는다. 하지만 작업이 30초를 넘기기 시작하면 연결 끊김, 브라우저 이탈, 서버 타임아웃, 재시도 중복 실행 같은 문제가 한꺼번에 나타난다. 그래서 장시간 작업은 요청을 바로 받아들이고, 작업 ID를 돌려준 뒤, 백그라운드 워커가 처리하는 비동기 패턴으로 바꾸는 것이 일반적이다.1
이 패턴의 핵심은 단순하다. 사용자는 "작업이 시작되었다"는 사실을 먼저 받고, 시스템은 뒤에서 천천히 그러나 확실하게 일한다. 사용자는 나중에 상태를 조회하거나 스트리밍으로 진행 상황을 받을 수 있다.
이 구조가 중요한 이유는 속도 때문만이 아니다. 복구 가능성 때문이다. 실행이 오래 걸릴수록, 연결보다 상태가 더 중요해진다. 프로덕션에서는 "답을 빨리 주는 것"만큼이나 "중간에 끊겨도 이어갈 수 있는 것"이 중요하다.
비동기 구조로 바꾸면 자연스럽게 다음 질문이 생긴다. 작업은 어디에 저장할 것인가? 지금 몇 퍼센트 진행됐는지는 어디서 읽을 것인가? 실패하면 자동 재시도할 것인가, 사람에게 올릴 것인가? 이 질문들에 답하기 시작할 때 하네스는 비로소 제품처럼 생기기 시작한다.
작업 큐는 속도 장치가 아니라 질서 장치다
비동기 구조를 도입하면 거의 반드시 작업 큐가 등장한다. 많은 사람이 큐를 성능 도구로만 생각하지만, 에이전트 하네스에서 큐의 본질은 질서다.
큐가 있으면 시스템은 적어도 세 가지를 얻는다. 첫째, 동시에 들어오는 요청을 한꺼번에 서버 메모리에 매달아 두지 않아도 된다. 둘째, 우선순위를 정할 수 있다. 셋째, 실패한 작업을 같은 규칙으로 다시 다룰 수 있다.
예를 들어 고객 지원 에이전트라면, "환불 분쟁"과 "배송 상태 문의"를 같은 우선순위로 둘 필요가 없을 수 있다. 내부 코딩 에이전트라면, 메인 브랜치 배포 관련 작업과 문서 정리 작업은 처리 방식이 달라야 한다. 작업 큐는 이런 차이를 운영 규칙으로 만든다.
여기서 중요한 점은 큐에 무엇을 넣느냐이다. 가장 나쁜 설계는 거대한 대화 전체와 임시 메모리를 통째로 밀어 넣는 것이다. 가장 좋은 설계는 작업을 재실행 가능한 단위로 나누고, 입력과 상태 참조만 넣는 것이다. 그래야 워커가 바뀌어도 같은 작업을 이어받을 수 있다.
즉, 큐는 "에이전트 실행을 쌓아 두는 통"이 아니라, 재현 가능한 작업 계약을 보관하는 장소여야 한다.
상태 저장소가 없으면 에이전트는 매번 신입사원이다
MVP에서 상태는 종종 대화 기록 안에 숨어 있다. 직전 메시지 몇 개를 붙여 넣으면 그럭저럭 이어지는 것처럼 보인다. 하지만 프로덕션에서는 이 방식이 오래 버티지 못한다. 세션이 끊기고, 작업이 길어지고, 여러 에이전트나 워커가 번갈아 실행되기 시작하면 대화 기록만으로는 업무 연속성을 유지하기 어렵다.
그래서 프로덕션 하네스에서는 컨텍스트와 상태를 분리해야 한다.
컨텍스트는 모델이 지금 추론하기 위해 잠깐 보는 재료다. 상태는 시스템이 사실로 보존해야 하는 업무 기록이다. 예를 들어 "사용자가 선호하는 보고서 형식"은 장기 상태일 수 있고, "이번 턴에서 방금 검색한 문서 3개"는 단기 컨텍스트일 수 있다. 또 "이 작업은 지금 검토 대기 중이다" 같은 정보는 대화가 아니라 워크플로 상태다.
실무에서는 보통 상태를 여러 층으로 나눈다.23
세션 상태: 현재 대화나 실행의 짧은 흐름
작업 상태: 지금 어떤 단계까지 끝났는지, 다음 단계가 무엇인지
사용자 상태: 선호, 권한, 과거 설정 같은 장기 정보
시스템 상태: 큐, 체크포인트, 재시도 횟수, 잠금 정보 같은 운영 정보
이 층을 나누지 않으면 곧바로 두 가지 문제가 생긴다. 첫째, 모델이 기억해야 할 것이 너무 많아진다. 둘째, 사람이 봐야 할 사실과 모델이 잠깐 참고할 재료가 뒤섞인다.
좋은 상태 저장소는 메모리가 많은 저장소가 아니다. 재개와 감사가 가능한 저장소다.
체크포인트는 저장 기능이 아니라 복구 전략이다
프로덕션으로 가면서 가장 크게 달라지는 설계 습관 중 하나는 체크포인트를 보는 눈이다. 초보 팀은 체크포인트를 "중간 저장" 정도로 생각한다. 하지만 실제로는 훨씬 중요하다. 체크포인트는 실패했을 때 어디까지 되돌아가지 않을지를 결정하는 복구 전략이다.4
예를 들어 리서치 에이전트가 다음 순서로 일한다고 해보자. 검색 계획 수립, 웹 검색, 문서 읽기, 초안 작성, 사람 승인, 최종 보고서 저장. 이때 검색 계획과 웹 검색 결과, 읽은 문서 목록, 초안 버전이 각각 남아 있지 않다면, 마지막 저장 직전에 서버가 죽었을 때 처음부터 다시 해야 할 수 있다. 그러면 비용도 늘고, 같은 외부 API를 또 호출하고, 결과가 달라져 재현도 어려워진다.
그래서 프로덕션 하네스는 의미 있는 경계마다 체크포인트를 둔다. 보통 다음 지점이 중요하다.
도구 호출이 끝난 직후
외부 시스템에 쓰기 전에
사람 승인 대기 상태로 들어가기 전에
하위 작업 하나가 끝났을 때
긴 루프를 다음 세션으로 넘기기 전에
체크포인트가 촘촘하다고 무조건 좋은 것은 아니다. 너무 자주 저장하면 비용과 복잡성이 커진다. 반대로 너무 드물면 복구 가치가 떨어진다. 결국 중요한 것은 기술적인 빈도보다 업무적인 경계다. 어디서부터 다시 하면 비용이 크고 위험한가를 기준으로 잡아야 한다.
사이드 이펙트는 반드시 경계 밖으로 빼내라
프로덕션 하네스에서 위험한 순간은 모델이 틀릴 때만이 아니다. 모델이 맞게 생각했더라도, 그 생각이 외부 세계를 바꾸는 순간 사고가 커진다. 메일 발송, 데이터베이스 수정, 결제, 파일 삭제, 배포 같은 동작이 바로 그렇다.
그래서 제품 수준의 하네스는 추론과 사이드 이펙트를 같은 덩어리로 다루지 않는다. 오케스트레이션은 "무엇을 할지"를 정하고, 실제 쓰기 작업은 별도 단계로 분리한다. 그리고 그 단계는 재시도 정책, 승인 규칙, 멱등성 규칙을 가진다.45
멱등성은 같은 요청이 두 번 실행돼도 결과가 한 번 실행된 것과 같게 유지되는 성질이다. 말은 어렵지만 실무 감각은 단순하다. "같은 메일을 두 번 보내지 않게 하라", "같은 환불을 두 번 처리하지 않게 하라"는 뜻이다. 작업 ID와 단계 번호를 묶어 외부 호출에 키로 넣는 방식이 흔하다.
이 원칙을 지키면 재시도는 훨씬 덜 무섭다. 반대로 이 원칙이 없으면, 복구를 잘할수록 중복 사고가 늘어나는 이상한 시스템이 된다.
단일 세션이 아니라 세션을 넘는 실행을 설계하라
프로토타입은 보통 한 번의 긴 대화 안에서 모든 걸 끝내려 한다. 그러나 제품에서는 긴 작업일수록 오히려 세션을 나눠야 한다. 이유는 간단하다. 컨텍스트는 썩고, 사용자는 떠나고, 서버는 재시작되며, 작업은 사람 승인 때문에 멈춘다.
따라서 프로덕션 하네스는 "하나의 긴 실행"보다 "짧은 실행들의 이어짐"을 더 잘 다뤄야 한다. 이를 위해 필요한 것은 두 가지다. 하나는 다음 세션이 읽을 수 있는 상태 아티팩트다. 다른 하나는 시작 시 복구 절차다. 어떤 파일을 읽고, 어떤 상태를 확인하고, 어디서부터 계속할지 정해져 있어야 한다.6
이 관점은 꽤 중요하다. 왜냐하면 이것이 있어야만 에이전트가 사람의 근무 리듬과도 맞아지기 때문이다. 오전에 초안을 만들고, 오후에 승인받고, 저녁에 자동 발송하는 흐름은 한 번의 거대한 컨텍스트보다 여러 번의 작은 세션으로 설계하는 편이 훨씬 안정적이다.
평가 파이프라인은 개발용이 아니라 운영용이다
MVP 단계에서는 결과를 사람이 직접 보고 "괜찮네"라고 말해도 넘어갈 수 있다. 하지만 프로덕션에서는 그 말이 거의 아무 의미가 없다. 오늘은 괜찮았는데 내일은 왜 나빠졌는지 설명할 수 없기 때문이다.
그래서 제품 수준의 하네스에는 평가 파이프라인이 들어간다. 중요한 점은 이것이 모델 성능 자랑용 장식이 아니라는 것이다. 평가 파이프라인의 목적은 변경이 시스템을 더 좋게 만들었는지, 더 위험하게 만들었는지 판단하는 것이다.78
운영에서 유용한 평가는 보통 세 층으로 나뉜다.
첫 번째는 오프라인 회귀 평가다. 프롬프트, 모델, 도구 정의, 검색 로직이 바뀔 때 기존 테스트셋을 다시 돌려 이전 버전과 비교한다. 이 평가는 배포 전에 안전벨트 역할을 한다.
두 번째는 실행 중 평가다. 실제 작업이 끝났을 때 형식 준수, 정책 위반 여부, 도구 호출 성공 여부, 특정 행동 규칙 준수 여부를 자동으로 확인한다. 이것은 생산 라인의 품질 검사에 가깝다.
세 번째는 사후 리뷰 평가다. 실패 사례와 애매한 사례를 모아 사람이 라벨을 붙이고, 그 결과를 다음 평가셋에 편입한다. 이 층이 있어야 시스템은 현장의 실패를 학습 자산으로 바꿀 수 있다.
여기서 특히 놓치기 쉬운 것이 있다. 에이전트 평가는 텍스트만 보면 안 된다는 점이다. 에이전트는 어떤 말을 했는가만큼이나 어떤 행동을 했는가가 중요하다. 그래서 평가 데이터에는 최종 출력뿐 아니라 도구 호출 순서, 인자, 실패 여부, 승인 이력 같은 행동 흔적이 함께 들어가야 한다.79
생성자와 평가자를 분리하라
프로덕션 에이전트에서 자주 생기는 착각이 있다. 모델이 자기 결과를 다시 읽고 "좋다"고 말하면 검증이 된 것처럼 느껴진다는 점이다. 하지만 생성과 평가를 같은 루프에 묶으면, 시스템은 생각보다 쉽게 자기 자신에게 관대해진다.
그래서 제품 수준에서는 생성자와 평가자를 분리하는 패턴이 자주 쓰인다. 생성자는 결과물을 만든다. 평가자는 미리 정한 기준으로 그 결과를 검사한다. 이때 평가 기준은 추상적인 감상이 아니라 점검 가능한 문장이어야 한다. 예를 들어 "좋은 보고서인가?"보다 "인용이 있는가, 금지된 표현이 없는가, 필수 섹션이 모두 있는가, 승인 없이 발송되지 않았는가"가 더 좋은 기준이다.10
이 분리는 사람에게도 좋다. 운영자는 생성자 로그와 평가자 로그를 따로 볼 수 있고, 어디서 문제가 생겼는지 훨씬 빨리 파악할 수 있다. 즉, 평가자 분리는 품질 향상 장치이면서 동시에 디버깅 장치다.
운영 모니터링은 결과 감상이 아니라 행동 관찰이다
프로덕션 하네스를 운영한다는 것은 단순히 성공률 숫자 하나를 보는 일이 아니다. 에이전트는 중간 단계가 많은 시스템이기 때문에, 결과만 보면 늦는다. 중요한 것은 도중에 무슨 일이 벌어지는지 아는 것이다.1112
운영 모니터링에서 최소한 봐야 할 축은 다음과 같다.
요청량과 동시 실행 수
대기 시간과 단계별 지연 시간
토큰 사용량과 모델별 비용
도구 호출 성공률과 실패 유형
재시도율과 사람 승인 전환율
작업별 완료율과 중단 위치
여기에 더해 트레이스가 있어야 한다. 트레이스는 에이전트의 행동 타임라인이다. 어떤 프롬프트 버전이 쓰였고, 어떤 도구가 어떤 인자로 호출됐고, 무엇이 실패했고, 최종 결과가 무엇이었는지를 한 줄로 잇는 지도라고 생각하면 된다.11
이 지도가 없으면 운영자는 이상 현상을 감으로 해석하게 된다. 예를 들어 "오늘 따라 답이 이상하다"는 신고가 들어왔을 때, 실제 원인이 검색 품질 저하인지, 특정 도구 장애인지, 프롬프트 변경인지, 비용 절감을 위한 모델 라우팅 변경인지 구분하기 어렵다. 트레이스는 이 애매함을 줄여 준다.
즉, 모니터링은 시스템이 살아 있는지 보는 것만이 아니다. 왜 그런 식으로 살아 있는지 이해하는 장치다.
운영 지표는 화려할 필요가 없고, 연결돼야 한다
AI 시스템을 운영할 때 팀은 쉽게 숫자 수집에 빠진다. 지표는 잔뜩 많은데, 정작 어떤 행동을 바꿔야 하는지는 모르는 상태다. 그래서 프로덕션 하네스의 지표는 많기보다 연결되어야 한다.
예를 들어 완료율이 떨어졌다면, 그 아래에서 어떤 지표가 함께 움직였는지 봐야 한다. 도구 오류율이 올랐는지, 특정 입력 유형의 실패가 늘었는지, 사람 승인 전환율이 급증했는지, 평균 단계 수가 늘었는지 연결해서 봐야 한다. 그래야 지표가 운영 판단으로 이어진다.
좋은 지표 체계는 보통 네 질문에 답하게 만든다.
지금 잘 되고 있는가?
어디서 느려지고 있는가?
무엇 때문에 비싸졌는가?
어떤 실패가 가장 자주 반복되는가?
이 네 질문에 답하지 못하는 대시보드는 예쁜 벽지에 가깝다.
권한 모델도 함께 확장돼야 한다
프로덕션으로 갈수록 사용자 수만 늘어나는 것이 아니다. 이해관계자도 늘어난다. 개인 실험에서는 한 명이 다 알고 있었지만, 제품에서는 일반 사용자, 관리자, 운영자, 감사 담당자, 보안 담당자가 같은 시스템을 다른 눈으로 본다.
그래서 하네스를 확장할 때는 에이전트의 권한뿐 아니라 사람의 권한도 함께 설계해야 한다. 누가 작업을 취소할 수 있는가? 누가 실패 로그를 볼 수 있는가? 누가 재시도 정책을 바꿀 수 있는가? 누가 승인 규칙을 수정할 수 있는가? 이 구분이 없으면 운영은 금방 혼란스러워진다.
특히 멀티 테넌트 환경에서는 사용자 간 데이터 경계가 하네스 코드에서 강제돼야 한다. 모델이 스스로 고객 A와 고객 B를 구분해 주길 기대하면 안 된다. 테넌트 범위, 사용자 범위, 문서 범위는 도구 레벨과 상태 저장소 레벨에서 먼저 잠가야 한다.13
프로덕션은 모델을 더 믿는 단계가 아니라, 경계를 더 명시하는 단계다.
비용 최적화는 마지막이 아니라 구조 설계의 일부다
많은 팀이 프로덕션 직전에야 비용을 본다. 그러나 에이전트 시스템에서는 비용이 운영 구조와 직접 연결되어 있다. 재시도 정책, 체크포인트 위치, 모델 라우팅, 도구 호출 횟수, 컨텍스트 크기, 장시간 작업의 세션 분할 방식이 모두 비용에 영향을 준다.1114
그래서 비용 최적화는 "나중에 모델을 싼 걸로 바꾸자"가 아니다. 오히려 이런 질문에 가깝다.
모든 단계에 가장 비싼 모델이 필요한가?
같은 결과를 다시 계산하지 않도록 중간 산출물을 저장하고 있는가?
실패한 작업은 전체 재실행이 아니라 실패 단계만 다시 돌릴 수 있는가?
대기 시간이 긴 작업은 동기 호출이 아니라 백그라운드로 빼냈는가?
사용자에게 꼭 필요한 경우에만 길고 깊은 루프를 돌리고 있는가?
제품이 커질수록 비용은 기술 문제가 아니라 사업 문제가 된다. 결국 하네스는 모델 호출 방식만이 아니라 단가 구조까지 설계하는 시스템이 된다.
확장은 한 번의 점프가 아니라 층층이 붙는 일이다
MVP에서 프로덕션으로 가는 길을 상상할 때, 많은 팀은 거대한 전환 순간을 떠올린다. 하지만 실제로는 그렇지 않다. 대개는 층을 하나씩 붙인다.
처음에는 단일 사용자용 흐름에 작업 ID와 로그를 붙인다. 그다음 작업 큐를 붙여 장시간 요청을 분리한다. 그다음 상태 저장소와 체크포인트를 도입해 재개를 가능하게 한다. 이후 평가 파이프라인과 운영 대시보드를 붙이고, 마지막으로 권한 모델과 비용 관리, 다중 사용자 분리를 정교하게 만든다.
이 순서가 중요한 이유는, 하네스의 성숙도가 곧 위임 수준을 결정하기 때문이다. 운영 구조가 약한데 자동화 수준만 높이면 시스템은 빠르게 위험해진다. 반대로 운영 구조가 탄탄하면 같은 모델이어도 훨씬 더 많은 일을 안정적으로 맡길 수 있다. 실제로 동일한 모델을 쓰더라도 하네스 설계만 바뀌어 성능 차이가 크게 벌어질 수 있다는 보고가 이어지는 이유도 여기에 있다.15
프로덕션 하네스의 최소 청사진
정리해 보자. MVP를 제품으로 키우는 데 꼭 필요한 것은 새로운 마법이 아니다. 오히려 아주 현실적인 운영 구성요소들이다.
다중 사용자를 버틸 수 있는 작업 분리
장시간 작업을 위한 비동기 실행과 큐
세션을 넘어 이어지는 상태 저장소와 체크포인트
외부 쓰기 작업을 분리하는 승인·재시도·멱등성 경계
변경 효과를 측정하는 평가 파이프라인
비용, 지연, 실패를 추적하는 운영 모니터링
이 청사진을 보면 한 가지가 분명해진다. 프로덕션 하네스는 모델을 둘러싼 부가 기능이 아니다. 그것은 모델이 실제 세계에서 일할 수 있게 만드는 운영 골격이다.
제품은 똑똑한 답변이 아니라 버티는 구조에서 나온다
프로토타입은 인상적인 한 번의 성공으로도 사람을 설득할 수 있다. 하지만 제품은 다르다. 오늘도 되고, 내일도 되고, 세 명이 동시에 써도 되고, 중간에 멈췄다가도 이어지고, 실패했을 때 왜 실패했는지 알 수 있어야 한다.
이 차이를 만드는 것은 모델의 화려함이 아니라 하네스의 구조다.
좋은 프로덕션 하네스는 에이전트를 영웅처럼 다루지 않는다. 대신 작업을 나누고, 상태를 저장하고, 실패를 기록하고, 위험한 행동을 경계 밖에 두고, 품질을 계속 측정한다. 한마디로 하면, 에이전트가 실수해도 시스템이 무너지지 않게 만든다.
그러니 MVP 다음 단계의 질문은 "무엇을 더 하게 만들까?"가 아니다. 더 정확한 질문은 이것이다.
이 에이전트가 여러 사용자와 여러 날, 여러 실패를 견디도록 만들 운영 구조는 갖추었는가?
그 질문에 예라고 답할 수 있을 때, 우리는 비로소 하네스를 제품 수준으로 확장했다고 말할 수 있다.
참고
1Build Long-Running AI Agents on Azure App Service with Microsoft Agent Framework
2OpenAIWorkshop Agent Framework State Management Guide
3AI agent memory Databricks on AWS
4Durable Execution and Background Work for AI Agent Runtimes
5Durable Execution: The Key to Harnessing AI Agents in Production
6Why Long-Running AI Agents Break in Production (And the Infrastructure to Fix It)
7Evaluate your AI agents - Microsoft Foundry Microsoft Learn
8Evaluate and monitor AI agents
9A PM's Guide to Evaluating AI Agents
10Agent Harness Design Patterns: The Infrastructure Layer That Makes AI Agents Production-Ready
11The Complete Guide to AI Agent Monitoring (2025)
12AI Observability & Monitoring in Production: What Every PM Must Know
13Our Thoughts on Agentic Architecture: Building a Production-Ready AI Harness
14Store and sync state · Cloudflare Agents docs
15Harness Engineering: How to Build Reliable AI Agents by Engineering the System, Not the Model
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.