


부록 D. PKM-MCP 전체 소스 코드 가이드
부록 D. PKM-MCP 전체 소스 코드 가이드
이 부록은 책 전체를 따라오며 만든 PKM-MCP를 한 번에 해부해 보는 안내서다. 앞 장들에서는 기능을 하나씩 추가했다. 처음에는 메모를 읽기만 하던 서버였고, 그다음에는 CRUD와 RAG가 붙었고, 결국에는 OAuth, Cloudflare Workers 배포, 감사 로그, MCP Apps UI, 레지스트리 공개까지 도달했다.
그런데 막상 완성본 폴더를 열어 보면 이런 생각이 든다. "그래서 이제 어디부터 읽어야 하지?"
이 질문은 아주 정상이다. 코드는 늘 책보다 복잡해 보인다. 파일은 많고, 설정은 흩어져 있고, 같은 기능이 여러 계층에 걸쳐 나타나기 때문이다. 그래서 이 부록의 목적은 단순하다. 완성된 PKM-MCP 코드베이스를 '읽는 지도'로 다시 정리하는 것이다.
이 장을 다 읽고 나면 적어도 다음 세 가지는 분명해질 것이다.
루트 폴더에서 어떤 디렉터리가 어떤 책임을 가지는지
도구 호출 하나가 실제로 어느 모듈들을 지나가는지
새로운 기능을 추가할 때 어디를 고치고 어디는 건드리지 말아야 하는지
완성본을 보는 가장 좋은 방법은 모든 파일을 같은 비중으로 보는 것이 아니다. 먼저 진입점, 다음으로 도메인 로직, 그다음에 저장소와 외부 연동, 마지막으로 배포와 운영 코드를 보는 식으로 읽어야 길을 잃지 않는다. 이제 그 순서대로 따라가 보자.
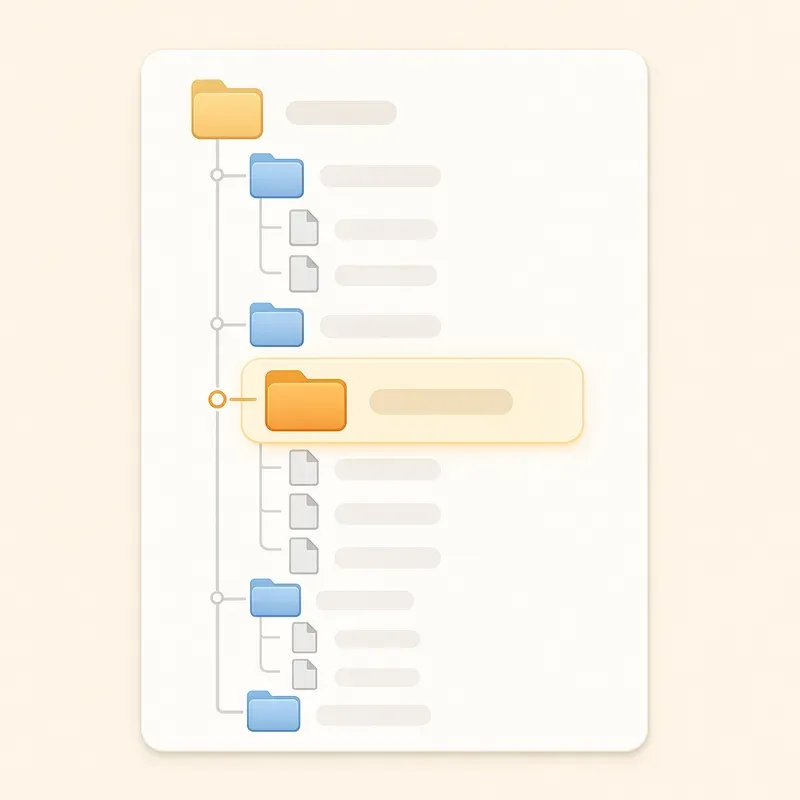
소스 트리를 먼저 머릿속에 넣기
책에서 만든 PKM-MCP 완성본은 다음과 비슷한 구조를 가진다. 실제 이름은 조금 달라도, 역할은 거의 이 틀 안에 들어간다.
pkm-mcp/
├─ apps/
│  └─ note-cards-ui/
├─ docs/
├─ infra/
│  ├─ cloudflare/
│  ├─ docker/
│  └─ scripts/
├─ packages/
│  ├─ shared/
│  └─ ts-server/
├─ server/
│  ├─ pkm_mcp/
│  │  ├─ main.py
│  │  ├─ config.py
│  │  ├─ bootstrap.py
│  │  ├─ auth/
│  │  ├─ transport/
│  │  ├─ tools/
│  │  ├─ resources/
│  │  ├─ prompts/
│  │  ├─ domain/
│  │  ├─ services/
│  │  ├─ repositories/
│  │  ├─ rag/
│  │  ├─ integrations/
│  │  ├─ audit/
│  │  ├─ logging/
│  │  └─ security/
│  ├─ tests/
│  │  ├─ unit/
│  │  ├─ integration/
│  │  └─ e2e/
│  ├─ migrations/
│  ├─ pyproject.toml
│  └─ .env.example
├─ registry/
│  ├─ server-card.json
│  └─ README.md
├─ .github/
└─ README.md
처음 보면 커 보이지만, 사실은 네 덩어리로 나눠 생각하면 된다.
첫째는 서버 본체다. server/pkm_mcp 아래에 MCP 서버의 핵심이 들어 있다. Tools, Resources, Prompts, 인증, 로깅, 저장소 접근이 전부 여기에 모인다.
둘째는 운영과 배포 코드다. infra와 registry는 애플리케이션 로직보다는 "이 서버를 어디에 어떻게 올리고, 어떻게 소개할 것인가"를 담당한다.
셋째는 UI와 보조 구현체다. apps/note-cards-ui는 MCP Apps용 인터페이스이고, packages/ts-server는 TypeScript 버전 구현이 들어가는 자리다.
넷째는 테스트와 문서다. 완성된 프로젝트는 기능만큼이나 테스트와 예제가 중요하다. 나중에 수정할수록 이 폴더들의 가치가 커진다.
즉, 이 프로젝트는 하나의 서버처럼 보이지만 실제로는 서버 코어 + 배포 자산 + UI + 문서 + 테스트가 느슨하게 묶인 작은 제품이다.
처음 코드를 읽을 때의 추천 순서
완성본을 처음 여는 독자에게 내가 권하고 싶은 읽기 순서는 이렇다.
server/pkm_mcp/main.pyserver/pkm_mcp/bootstrap.pyserver/pkm_mcp/config.pyserver/pkm_mcp/tools/server/pkm_mcp/services/server/pkm_mcp/repositories/server/pkm_mcp/auth/와security/server/pkm_mcp/rag/server/tests/infra/,apps/,registry/
이 순서가 좋은 이유는 간단하다. 먼저 서버가 어떻게 시작되는지를 본 뒤, 무엇을 제공하는지를 보고, 그 다음에 그 기능이 안쪽에서 어떻게 구현되는지를 따라가게 되기 때문이다.
반대로 repositories나 migrations부터 보면 금방 피곤해진다. 데이터베이스 테이블을 먼저 이해한다고 해서 서버 구조가 바로 보이지는 않는다. 코드는 언제나 바깥에서 안쪽으로 읽는 편이 덜 헷갈린다.
서버의 심장: main.py와 bootstrap.py
대부분의 완성형 서버는 main.py가 생각보다 짧다. 좋은 신호다. main.py가 너무 길다면 서버 시작, 설정, 등록, 로깅, 인증, 비즈니스 로직이 한 군데 뭉쳐 있다는 뜻이다.
PKM-MCP의 main.py는 대개 다음과 같은 일만 한다.
설정을 읽는다.
서버 인스턴스를 만든다.
bootstrap 함수를 호출한다.
transport 모드에 따라 stdio 또는 HTTP로 실행한다.
예를 들면 이런 느낌이다.
from pkm_mcp.config import load_settings
from pkm_mcp.bootstrap import create_server
from pkm_mcp.transport import run_stdio, run_http

settings = load_settings()
app = create_server(settings)

if settings.transport == "stdio":
    run_stdio(app)
else:
    run_http(app, host=settings.host, port=settings.port)
핵심은 main.py가 똑똑할 필요가 없다는 점이다. 진짜 중요한 일은 bootstrap.py에서 벌어진다. bootstrap.py는 서버에 어떤 도구와 리소스, 프롬프트를 등록할지 결정하는 조립 공장이다.
여기서 보통 다음 작업이 이뤄진다.
DB 리포지토리 초기화
임베딩/벡터 저장소 초기화
OAuth 검증기와 권한 체크 준비
로거와 감사 로그 수집기 연결
Tool, Resource, Prompt 등록
필요하면 Apps UI 메타데이터 연결
즉, bootstrap.py는 "PKM-MCP라는 제품을 부품으로 조립하는 파일"이다. 완성본을 이해하고 싶다면 반드시 이 파일부터 읽어야 한다.
config.py: 서버의 성격을 결정하는 파일
프로젝트가 커질수록 코드보다 설정이 더 중요해진다. 같은 코드라도 어떤 설정으로 실행하느냐에 따라 완전히 다른 서버가 되기 때문이다.
config.py는 보통 환경 변수를 읽어서 Settings 객체로 바꾸는 역할을 한다. 여기에는 다음 같은 값들이 들어 있다.
실행 모드:
stdio또는http데이터베이스 주소
벡터 DB 종류와 연결 정보
GitHub API 토큰
OAuth issuer, audience, client 관련 설정
감사 로그 저장 방식
Cloudflare 배포용 값
기능 플래그: 예를 들어 semantic search 사용 여부
설정 파일이 잘 짜여 있으면 서버는 유연해진다. 로컬에서는 SQLite와 로컬 파일 임베딩을 쓰고, 운영에서는 PostgreSQL과 외부 벡터 저장소를 쓰도록 쉽게 바꿀 수 있다. 반대로 설정이 코드 곳곳에 박혀 있으면, 배포가 아니라 발굴 작업을 하게 된다.
실무에서는 config.py를 읽을 때 다음 질문을 던지면 좋다.
"이 값은 기능인가, 환경인가?"
기능이면 코드에 있어야 하고, 환경이면 설정으로 빠져야 한다. 예를 들어 create_note라는 도구의 존재 자체는 기능이다. 하지만 최대 결과 수, 데이터베이스 URL, 로그 레벨은 환경이다.
tools 디렉터리: AI가 실제로 손을 뻗는 지점
tools/는 PKM-MCP에서 가장 눈에 잘 띄는 폴더다. LLM이 직접 호출하는 기능들이 여기에 있다. 보통 다음 같은 파일로 나뉜다.
tools/
├─ search_notes.py
├─ semantic_search_notes.py
├─ create_note.py
├─ update_note.py
├─ delete_note.py
├─ import_github_issue.py
└─ common.py
여기서 중요한 원칙이 하나 있다. 도구 함수는 얇을수록 좋다.
도구는 MCP 바깥 세계와 비즈니스 로직 사이의 문지기 역할을 한다. 그래서 도구 함수 안에는 이런 내용이 들어가는 것이 좋다.
입력 파라미터 검증
권한 확인
서비스 계층 호출
MCP 친화적인 결과 포맷 반환
예외를 사용자 친화적인 메시지로 변환
반면 다음 내용은 도구 안에 오래 머물면 안 된다.
복잡한 SQL 작성
임베딩 계산 세부 구현
감사 로그 저장 로직 전체
GitHub API 호출의 세세한 retry 처리
예를 들어 search_notes 도구는 겉으로 보기에는 검색 기능이지만, 실제로는 "입력을 받고 서비스에 위임한 뒤 결과를 MCP에 맞는 형태로 감싼다"가 핵심이다.
@mcp.tool()
def search_notes(query: str, limit: int = 10) -> dict:
    validate_query(query)
    notes = note_service.search_by_keyword(query=query, limit=limit)
    return format_note_search_result(notes)
이 짧은 구조가 중요한 이유는 테스트하기 쉬워지기 때문이다. 검색 자체의 정답 여부는 services와 repositories에서 테스트하고, 도구는 "입력과 출력 계약이 맞는가"만 확인하면 된다.
resources 디렉터리: 읽기 전용 창문 만들기
resources/는 많은 독자가 처음에는 과소평가하는 폴더다. 하지만 프로젝트가 커질수록 이 폴더가 점점 빛난다. 왜냐하면 모든 것을 Tool로 만들면 AI가 매번 "행동"을 해야 하지만, Resource는 정보를 안정적으로 보여 주는 창문이기 때문이다.
PKM-MCP에서는 메모 본문이나 특정 노트의 메타데이터를 note://{id} 같은 URI로 노출했을 가능성이 크다. 이때 리소스 계층은 대개 다음 역할을 한다.
URI를 파싱한다.
리포지토리나 서비스에서 데이터를 읽는다.
콘텐츠 타입과 본문을 정리한다.
필요하면 변경 알림 subscribe 이벤트와 연결한다.
리소스 구현은 대체로 화려하지 않다. 대신 구조가 깔끔해야 한다. Tool처럼 부수 효과가 없어야 하고, "같은 URI를 읽으면 같은 의미의 데이터를 얻는다"는 예측 가능성이 중요하다.
만약 코드베이스에서 Tool과 Resource의 경계가 흐리다면, 보통 다음 현상이 보인다. 읽기 전용 기능인데도 Tool로 만들었고, 결과 포맷이 대화용 텍스트에 치우쳐 있으며, 구독 가능한 업데이트 설계가 뒤늦게 어려워진다. 그럴 때는 resources 쪽으로 옮길 수 있는 기능이 없는지 점검해 보자.
prompts 디렉터리: 기능보다 사용 흐름을 재사용하기
prompts/는 겉보기에는 단순한 텍스트 템플릿 모음처럼 보인다. 하지만 PKM-MCP 같은 프로젝트에서는 훨씬 더 중요한 의미를 가진다. 이 폴더는 사용자가 원하는 작업 흐름을 반복 가능하게 만든다.
예를 들어 "이번 주 메모 요약" 프롬프트는 단순한 문장 조각이 아니다. 내부적으로는 다음 의도를 담을 수 있다.
최근 7일 메모만 요약 대상으로 삼는다.
할 일, 아이디어, 참고 링크를 구분해 달라고 안내한다.
필요하면 관련 리소스나 검색 도구를 먼저 사용하라고 유도한다.
이런 Prompt는 서버의 기능을 늘리는 것이 아니라, 기존 기능을 더 잘 사용하게 만드는 UX 레이어라고 생각하면 이해하기 쉽다.
코드 차원에서는 Prompt 등록 함수와 템플릿 생성 함수가 나뉘어 있으면 좋다. 등록 함수는 MCP에 연결하고, 생성 함수는 실제 인자를 받아 최종 문구를 만든다. 이렇게 분리하면 테스트도 쉬워지고, 나중에 다국어 지원이나 사용자별 프롬프트 변형도 덜 아프다.
domain 디렉터리: 비즈니스 규칙이 사는 곳
프로젝트를 오래 살리고 싶다면 domain/을 가볍게 보면 안 된다. 여기는 "노트란 무엇인가", "삭제란 무엇을 의미하는가", "검색 결과는 어떤 최소 정보를 가져야 하는가" 같은 규칙이 모이는 곳이다.
보통 다음 같은 내용이 여기에 들어간다.
Note,NoteId,UserId같은 모델태그, 수정 시각, 작성자 같은 값 객체
노트 상태 전이 규칙
입력 검증 규칙
도메인 예외
예를 들어 Note가 단순 딕셔너리라면 당장은 빨리 만들 수 있다. 하지만 나중에 공개 범위, 버전, 소프트 삭제, 동기화 상태, 감사 로그 추적 ID 같은 속성이 늘어나면 코드 전체가 흐트러진다. 반면 domain/note.py 같은 파일에서 모델과 규칙을 잡아 두면, 서비스와 저장소가 같은 언어를 쓰게 된다.
여기서 기억할 점은 하나다. 도메인은 MCP를 몰라도 된다.
도메인 계층은 Tool인지 Resource인지, stdio인지 HTTP인지 몰라도 돌아가야 한다. 이 독립성이 높을수록 나중에 TypeScript로 재구현하거나 다른 인터페이스를 붙일 때 훨씬 수월해진다.
services 디렉터리: 진짜 일은 여기서 벌어진다
완성본에서 가장 중요한 폴더를 하나만 꼽으라면 나는 services/를 고르겠다. Tool은 입구이고 Repository는 창고라면, Service는 실제 작업대다.
예를 들어 create_note 요청이 들어왔다고 하자. 이 작업은 생각보다 단순하지 않다.
제목과 본문을 정규화해야 할 수도 있고, 사용자 권한을 확인해야 할 수도 있고, 저장 후 임베딩 큐를 태워야 할 수도 있으며, 감사 로그도 남겨야 한다. 이 모든 흐름을 도구 함수 안에 넣으면 금방 스파게티가 된다. 그래서 서비스가 필요하다.
PKM-MCP에서는 대개 다음 같은 서비스들이 등장한다.
NoteService: 노트 생성, 수정, 삭제, 조회SearchService: 키워드 검색, 필터링, 정렬SemanticSearchService: 임베딩 생성, 유사도 검색, 결과 병합ImportService: GitHub 이슈 등 외부 데이터 가져오기AuditService: 행위 기록 저장AuthzService: 사용자 권한 판단
좋은 서비스는 Tool보다 길 수 있지만, Repository보다도 더 읽기 쉬워야 한다. 왜냐하면 여기에 제품의 규칙과 흐름이 드러나기 때문이다. 서비스 계층을 읽으면 "이 서버가 어떤 철학으로 동작하는지"가 보인다.
repositories 디렉터리: 데이터가 눕는 자리
repositories/는 말 그대로 데이터를 넣고 빼는 계층이다. SQLite든 PostgreSQL이든, 혹은 파일 기반 저장소든, 도메인과 외부 저장 매체 사이를 연결한다.
보통 다음처럼 나뉜다.
repositories/
├─ note_repository.py
├─ embedding_repository.py
├─ audit_log_repository.py
└─ user_repository.py
이 계층의 핵심 임무는 데이터베이스를 숨기는 것이다. 서비스는 "노트를 저장한다"만 알면 되고, 실제로 SQL을 쓰는지 ORM을 쓰는지는 몰라도 된다. 이렇게 해 두면 나중에 SQLite에서 PostgreSQL로 옮겨도 서비스는 거의 그대로 유지할 수 있다.
노트 저장소를 읽을 때는 특히 세 가지를 보자.
검색 인덱스에 유리한 스키마를 썼는가
사용자별 데이터 격리가 쿼리 레벨에서 강제되는가
삭제 정책이 하드 삭제인지 소프트 삭제인지
특히 OAuth를 붙인 이후의 PKM-MCP에서는 user_id가 빠진 조회 쿼리는 거의 잠재적 사고라고 보면 된다. 리포지토리는 단순해 보여도, 실제 보안 사고는 자주 여기서 시작된다.
rag 디렉터리: 의미 검색을 위한 별도의 두뇌
키워드 검색만 있을 때는 노트 저장소와 검색 서비스 정도로도 충분하다. 하지만 의미 검색이 붙는 순간부터는 별도 파이프라인이 생긴다. 그래서 rag/ 또는 embeddings/ 디렉터리가 분리되는 편이 좋다.
여기에는 보통 다음 컴포넌트가 들어간다.
임베딩 생성기
벡터 저장소 어댑터
인덱싱 작업기
검색 결과 리랭킹 또는 점수 후처리기
텍스트 청크 분할기
많은 초보 구현에서는 "노트를 저장할 때 바로 임베딩도 만들자"로 끝난다. 작은 프로젝트에서는 충분하다. 하지만 완성본 수준에서는 그보다 한 단계 더 생각해야 한다. 예를 들어 수정 직후 임베딩이 실패하면 어떻게 할지, 삭제된 노트의 벡터는 언제 제거할지, 같은 본문이 여러 번 저장될 때 중복 인덱싱을 막을지 같은 문제가 생긴다.
그래서 RAG 계층은 대체로 두 부분으로 나뉜다. 하나는 동기 요청 경로에서 바로 필요한 검색, 다른 하나는 비동기적으로 관리되는 인덱싱 작업이다. 책에서 작게 시작했더라도, 완성본에서는 이 둘을 머릿속에서 분리해 보는 습관이 중요하다.
auth와 security: 기능이 아니라 경계선
보안 코드는 종종 프로젝트 뒤편으로 밀려난다. 하지만 OAuth, 사용자별 노트 격리, 읽기/쓰기 권한 분리까지 간 PKM-MCP에서는 auth/와 security/가 사실상 구조의 일부다.
이 폴더는 보통 다음 책임을 가진다.
액세스 토큰 검증
사용자 컨텍스트 복원
스코프와 리소스 인디케이터 검사
민감 도구 실행 전 권한 확인
프롬프트 인젝션 또는 도구 포이즈닝 방어 규칙
출력 제한과 안전한 에러 메시지 생성
중요한 점은 인증과 인가가 Tool 바깥에도 있어야 한다는 것이다. 예를 들어 create_note 도구 안에서만 권한을 체크하면, 나중에 같은 서비스가 다른 진입점에서 호출될 때 구멍이 생긴다. 그래서 보통은 입구에서 한 번, 서비스에서 한 번 방어하는 구조가 안전하다.
보안 코드를 읽을 때는 화려한 암호학보다 더 현실적인 질문을 던져야 한다.
"사용자 A의 요청이 사용자 B의 데이터로 닿을 수 있는 경로가 있는가?"
이 질문에 자신 있게 아니오라고 말할 수 있어야 한다.
audit와 logging: 나중의 나를 구하는 폴더
처음에는 로그가 귀찮다. 감사 로그는 더더욱 귀찮다. 하지만 서버가 로컬 노트북을 떠나는 순간, 이 두 폴더는 구명조끼가 된다.
logging/은 대개 구조화된 로그 포맷, request ID, trace 정보, 에러 레벨 정리를 담당한다. 반면 audit/은 누가 언제 어떤 도구로 어떤 대상에 어떤 행동을 했는지를 남긴다.
둘은 비슷해 보여도 다르다.
로그는 디버깅을 위한 것이고, 감사 로그는 책임 추적을 위한 것이다. 예를 들어 delete_note가 실패했다면 에러 로그가 필요하지만, 성공했더라도 누가 어떤 노트를 삭제했는지의 기록은 감사 로그에 따로 남아야 한다.
완성본 코드를 볼 때는 AuditService가 어느 계층에서 호출되는지 확인해 보자. 가장 좋은 위치는 비즈니스 작업이 성공 또는 실패로 귀결되는 서비스 계층 근처다. 너무 바깥에 두면 중요한 문맥을 잃고, 너무 안쪽에 두면 저장소 세부 구현에 묶여 버린다.
transport 디렉터리: 같은 서버를 다른 선으로 연결하기
이 책의 큰 흐름 중 하나는 stdio에서 Streamable HTTP로 넘어가는 과정이었다. 그 결과 완성본에는 transport 관련 코드가 따로 빠져 있는 경우가 많다.
이 폴더의 역할은 단순하다. 서버의 기능은 그대로 두고, 연결 방식만 바꾸는 것이다.
보통 다음 식으로 나뉜다.
stdio.py: 로컬 도구용 실행http.py: 원격 서버용 실행middleware.py: 요청 컨텍스트, 인증, 로깅 연결server_card.py:.well-known및 메타데이터 응답
Transport 계층을 잘 나누면 같은 비즈니스 로직을 로컬 개발과 클라우드 배포에서 함께 재사용할 수 있다. 반대로 여기에 비즈니스 규칙이 스며들면, stdio에서는 되는데 HTTP에서는 안 되는 이상한 현상이 생긴다.
integrations 디렉터리: 외부 세계와 악수하는 곳
PKM-MCP는 내부 메모만 다루는 서버로 끝나지 않았다. GitHub 이슈를 메모로 가져오는 기능처럼, 외부 시스템을 연결하기 시작하면 코드베이스는 금방 복잡해진다. 이때 integrations/ 폴더가 경계선을 지켜 준다.
이곳에는 보통 다음이 들어간다.
GitHub API 클라이언트
외부 REST API 래퍼
SaaS별 응답 포맷 변환기
retry, timeout, rate limit 대응 로직
중요한 원칙은 외부 API의 응답 형식을 도메인 안으로 그대로 들이지 않는 것이다. GitHub의 JSON 구조는 GitHub의 사정일 뿐, 우리 노트 모델의 사정이 아니다. 그러므로 integrations/github_client.py가 받아 온 결과를 services/import_service.py에서 도메인 객체나 생성 명령으로 변환하는 단계가 필요하다.
이 한 단계를 아끼면 처음엔 편하지만, 외부 API가 바뀌는 순간 서버 전체가 함께 흔들린다.
Apps UI 폴더: MCP 서버가 화면을 얻는 순간
4부에서 붙인 MCP Apps UI는 프로젝트의 성격을 조금 바꾼다. 이제 PKM-MCP는 텍스트만 주고받는 서버가 아니라, 노트 카드 같은 시각적 인터페이스도 제공한다.
apps/note-cards-ui/는 대개 프런트엔드 프로젝트처럼 생겨 있다. HTML, CSS, JavaScript 또는 React 기반 코드가 들어가고, 서버가 보내는 데이터 계약에 맞춰 렌더링한다.
여기서 중요한 것은 UI가 서버를 대신하지 않는다는 점이다. UI는 보이기만 하고, 진짜 권한 판단과 데이터 변경은 여전히 서버 쪽에서 이뤄져야 한다. 이 경계를 지키지 않으면 보기에는 멋진데, 보안이 허술한 제품이 된다.
UI 폴더를 읽을 때는 다음을 확인해 보자.
어떤 payload를 받아 렌더링하는가
사용자의 인터랙션이 다시 어떤 MCP 호출로 이어지는가
표시용 데이터와 민감 데이터가 분리되어 있는가
TypeScript 구현체는 왜 따로 있나
8장에서 Python 버전을 TypeScript로 다시 만들어 본 이유는 문법 자랑이 아니었다. 같은 MCP 서버라도 언어에 따라 개발 경험, 배포 방식, 라이브러리 선택지가 달라진다는 걸 보여 주기 위해서였다.
따라서 packages/ts-server/는 단순 복사본이 아니라, 핵심 기능의 대체 구현체라고 이해하면 좋다. 여기서는 보통 다음 두 가지를 비교하며 읽으면 재미있다.
첫째, 등록 방식이 다르다. Python에서는 데코레이터 스타일이 직관적이고, TypeScript에서는 타입과 스키마 조합이 더 명시적일 때가 많다.
둘째, 런타임 감각이 다르다. Python 쪽은 서버 로직 작성이 편하고, TypeScript 쪽은 웹 플랫폼과의 결합이 자연스럽다. 특히 Cloudflare Workers 같은 환경을 생각하면 TS 구현체는 단순한 예제가 아니라 배포 친화적인 경로가 되기도 한다.
완성본을 읽을 때는 두 구현체의 "차이"보다 "공통된 경계"를 보는 편이 더 중요하다. Tool 이름, 입력 스키마, 결과 형식, 권한 정책이 같다면 언어가 달라도 같은 서버라고 볼 수 있다.
요청 하나가 지나가는 길: search_notes 편
이제 실제로 요청 하나를 따라가 보자. 예를 들어 클라이언트가 search_notes를 호출했다고 하자.
흐름은 대체로 이렇다.
클라이언트가 MCP Tool 호출 메시지를 보낸다.
transport 계층이 요청을 받는다.
필요하면 인증 정보를 사용자 컨텍스트로 바꾼다.
tools/search_notes.py가 입력을 검증한다.services/search_service.py를 호출한다.서비스는
repositories/note_repository.py를 통해 키워드 검색을 수행한다.결과를 서비스에서 정렬하거나 다듬는다.
도구가 MCP 친화적인 응답 구조로 감싸서 반환한다.
logging과 audit 계층이 흔적을 남긴다.
클라이언트가 응답을 받아 LLM에 전달한다.
여기서 눈여겨볼 점은, 검색이라는 하나의 기능이 실제로는 여러 폴더를 지나간다는 것이다. 바로 그래서 구조가 중요하다. 이 길이 명확하지 않으면 에러가 났을 때 어디를 봐야 할지 알 수 없다.
요청 하나가 지나가는 길: create_note 편
쓰기 작업은 읽기보다 더 신중해야 하므로 흐름이 조금 더 길다.
클라이언트가
create_note호출transport에서 인증/권한 준비
도구에서 입력 검증
서비스에서 사용자별 쓰기 권한 확인
노트 모델 생성 및 정규화
리포지토리에 저장
임베딩 인덱싱 예약 또는 실행
감사 로그 기록
생성된 노트 요약 응답 반환
이 흐름을 코드에서 분리해 두면 좋은 이유는 실패 지점을 구분할 수 있기 때문이다. 저장은 성공했는데 임베딩만 실패했다면, 노트 생성 전체를 실패로 볼지, 경고와 함께 부분 성공으로 볼지 결정해야 한다. 이런 정책은 대개 서비스 계층에서 가장 잘 표현된다.
데이터베이스와 마이그레이션 읽는 법
migrations/ 폴더는 개발 초기에는 별로 재미없어 보인다. 하지만 운영 중인 서버에서는 역사책과 비슷하다. 프로젝트가 어떻게 진화했는지가 여기에 남는다.
PKM-MCP 완성본의 데이터베이스에는 보통 다음 테이블들이 등장한다.
notesnote_embeddingsusersoauth_tokens또는 관련 세션 테이블audit_logs필요하면
sync_jobs또는imports
초보자가 많이 하는 실수는 스키마를 읽을 때 컬럼 이름만 보는 것이다. 더 중요한 것은 인덱스, 제약 조건, 외래 키, 삭제 정책이다. 예를 들어 notes(user_id, updated_at)에 인덱스가 있으면 사용자별 최근 메모 조회를 많이 한다는 뜻이고, audit_logs가 append-only 구조라면 수정 불가능한 기록을 의도했다는 뜻이다.
마이그레이션을 읽으면 "이 서버가 어떤 문제를 겪으며 성장했는지"도 보인다. 처음에는 제목과 본문만 있던 노트가 나중에 태그, 소프트 삭제 플래그, 외부 출처 식별자, 벡터 인덱스 상태를 갖게 되는 식이다. 그것이 바로 제품의 연대기다.
테스트 폴더는 정답지가 아니라 안전장치다
완성본을 이해하려면 의외로 tests/를 빨리 보는 것이 좋다. 테스트는 "이 시스템이 무엇을 해야 하는가"를 가장 짧고 단정하게 보여 주기 때문이다.
보통 구조는 이렇다.
tests/
├─ unit/
├─ integration/
└─ e2e/unit은 함수나 서비스의 규칙을 빠르게 검증한다. integration은 실제 DB, 벡터 저장소, 인증 모듈 사이의 결합을 확인한다. e2e는 클라이언트 입장에서 Tool 호출이 정말 기대대로 작동하는지 본다.
예를 들어 delete_note 테스트가 있다면, 단순히 삭제가 되는지만 볼 것이 아니라 다음도 확인해야 한다.
다른 사용자의 노트는 지울 수 없는가
이미 삭제된 노트에 대해 일관된 에러가 나는가
감사 로그가 남는가
임베딩 인덱스에서도 제거되는가
좋은 테스트는 코드를 대신 읽어 주는 요약본이다. 특히 서비스 계층과 인증 관련 테스트는 구조를 이해하는 데 큰 도움이 된다.
registry와 README: 코드를 설명하는 바깥 껍질
완성된 MCP 서버는 코드만 있다고 끝나지 않는다. 누군가가 발견하고, 이해하고, 연결할 수 있어야 한다. 그래서 registry/와 루트 README.md는 개발자를 위한 포장 상자이자 안내서다.
여기에는 보통 다음 정보가 들어 있다.
서버가 제공하는 Tool, Resource, Prompt 개요
인증 방식
설치 및 실행 방법
환경 변수 설명
버전 호환성 정책
예제 호출
Server Card 메타데이터
이 파일들은 사소해 보여도 실제 사용성에 큰 영향을 준다. 코드 구조가 좋아도 README가 나쁘면 다른 사용자는 서버를 신뢰하지 못한다. 반대로 README가 탄탄하면 코드베이스의 설계 의도까지 훨씬 잘 전달된다.
PKM-MCP에서 가장 자주 고치게 되는 확장 포인트
이제 가장 실전적인 이야기를 해 보자. 이 프로젝트를 자기 것으로 만들려면 어디를 자주 수정하게 될까. 거의 항상 아래 영역이다.
새 Tool 추가
가장 흔한 확장이다. 예를 들어 archive_note를 추가하고 싶다면 대개 다음 순서로 진행한다.
tools/archive_note.py작성services/note_service.py에 아카이브 로직 추가필요하면
domain/note.py에 상태 규칙 추가repositories/note_repository.py에 저장 로직 추가bootstrap에서 등록
테스트 추가
핵심은 Tool만 만들고 끝내지 않는 것이다. 기능은 늘 계층을 따라 흘러야 한다.
새 Resource 추가
특정 태그의 메모 목록이나 최근 수정 메모 피드를 Resource로 노출하고 싶을 수 있다. 이 경우는 Tool보다 더 읽기 친화적인 인터페이스가 된다. 구독 모델까지 생각한다면 resources와 이벤트 발행부를 함께 봐야 한다.
새 외부 연동 추가
GitHub 대신 Notion, Slack, Jira를 붙이고 싶다면 integrations/와 services/import_service.py가 주 무대가 된다. 외부 응답을 도메인 모델로 번역하는 계층을 유지하는 것이 가장 중요하다.
새 인증 정책 추가
팀별 워크스페이스 격리나 읽기 전용 토큰 같은 정책을 넣고 싶다면 auth/, security/, services/를 함께 수정해야 한다. 이런 변화는 표면적으로는 작아 보여도, 실제로는 시스템 전체 규칙을 건드리는 경우가 많다.
새 UI 추가
Apps UI에서 노트 카드 외에 편집 패널, 태그 필터, 검색 결과 비교 뷰를 붙이고 싶다면 apps/만 보면 될 것 같지만, 대부분은 서버 응답 형식도 함께 조정해야 한다. UI는 서버 계약 위에 세워진다는 사실을 잊지 말자.
완성본을 내 것으로 바꾸는 리팩터링 연습
이 부록의 핵심 문장은 이것이다. 따라 만든 코드를 진짜 내 코드로 만드는 순간은, 다시 쓰기 시작할 때다.
그렇다면 어떤 식으로 바꾸면 좋을까. 너무 큰 목표보다는 작은 리팩터링이 좋다.
첫 번째 연습은 파일 이름만 보고 구조 설명하기다. 각 폴더가 무엇을 하는지 한 문장씩 적어 보자. 설명이 안 되는 파일은 구조가 모호하거나 책임이 중복된 파일일 가능성이 크다.
두 번째 연습은 도구 하나를 다른 방식으로 다시 구현하기다. 예를 들어 search_notes를 새 서비스 메서드로 분리하거나, 결과 포맷터를 별도 모듈로 빼 보자. 이 과정에서 경계가 보인다.
세 번째 연습은 한 기능을 삭제해 보기다. 예를 들어 GitHub 가져오기 기능을 제거해 보고, 깨지는 테스트와 import를 추적해 보자. 구조가 잘 잡혀 있다면 삭제도 비교적 쉽다. 삭제가 너무 고통스럽다면 결합도가 높은 것이다.
네 번째 연습은 새로운 저장소 구현체 붙이기다. SQLite 기반 리포지토리 대신 메모리 기반 테스트 리포지토리를 만들어 보자. 이것만 해도 서비스 계층 분리가 왜 중요한지 체감할 수 있다.
길을 잃기 쉬운 지점들
완성본을 볼 때 많은 독자가 비슷한 곳에서 헷갈린다.
첫째, Tool과 Service의 경계를 혼동한다. 도구가 곧 기능이라고 생각하면, 도구 함수 안에 모든 로직을 넣고 싶어진다. 하지만 도구는 인터페이스일 뿐이다.
둘째, 설정과 코드의 경계를 혼동한다. 환경마다 달라질 값을 코드에 넣으면 운영이 어려워진다.
셋째, 인증과 인가를 한 군데만 처리하려 한다. 실제로는 입구와 핵심 로직 둘 다 방어해야 한다.
넷째, 검색 기능을 한 덩어리로 본다. 키워드 검색과 의미 검색은 사용 목적도 다르고 실패 양상도 다르므로 구분하는 편이 낫다.
다섯째, UI를 별개 프로젝트로 생각한다. Apps UI도 결국 서버 계약 위에서 움직이므로, 데이터 형식과 권한 정책을 함께 봐야 한다.
이 다섯 가지만 의식해도 코드를 읽는 속도가 훨씬 빨라진다.
폴더별 한 줄 요약
마지막으로, PKM-MCP 전체 구조를 아주 짧게 다시 정리해 보자.
main.py: 서버를 시작하는 스위치bootstrap.py: 부품을 조립하는 공장config.py: 환경에 따라 서버 성격을 바꾸는 조정판tools/: AI가 호출하는 행동의 입구resources/: 읽기 전용 데이터 창문prompts/: 반복 가능한 작업 흐름 템플릿domain/: 비즈니스 규칙의 중심services/: 실제 업무 흐름이 지나가는 작업대repositories/: 데이터 저장소와의 접점rag/: 의미 검색을 위한 별도 엔진auth/,security/: 사용자와 권한의 경계선audit/,logging/: 문제를 추적하고 책임을 남기는 기록장transport/: stdio와 HTTP를 연결하는 선integrations/: 외부 시스템과의 번역기apps/: 서버가 사용자에게 보여 줄 얼굴tests/: 구조를 지키는 안전장치infra/: 서버를 실제 세상에 올리는 장비실registry/: 다른 사람이 이 서버를 발견하고 이해하게 하는 소개서
마무리: 이제는 기능 추가보다 구조 읽기가 중요하다
책을 처음 따라올 때는 "동작하게 만드는 법"이 가장 중요했다. 하지만 여기까지 왔다면 다음 단계는 다르다. 이제 중요한 것은 왜 이런 구조로 나눴는지 이해하는 것이다.
기능은 시간이 지나면 바뀐다. 새로운 Tool이 생기고, 벡터 DB가 바뀌고, OAuth 공급자가 달라지고, UI가 더 화려해질 수 있다. 하지만 경계가 잘 잡힌 구조는 오래 버틴다. Tool은 입구에 머물고, Service는 흐름을 관리하고, Repository는 저장을 담당하고, Auth와 Audit은 경계를 지킨다. 이 질서가 유지되면 서버는 커져도 무너지지 않는다.
그리고 바로 그 지점에서, 이 프로젝트는 더 이상 책 속 예제가 아니다. 당신이 해부했고, 고칠 수 있고, 확장할 수 있는 진짜 자기 프로젝트가 된다.
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.