


20장. 프로젝트 3 — 단편 AI 영화 만들기
20장. 프로젝트 3 — 단편 AI 영화 만들기
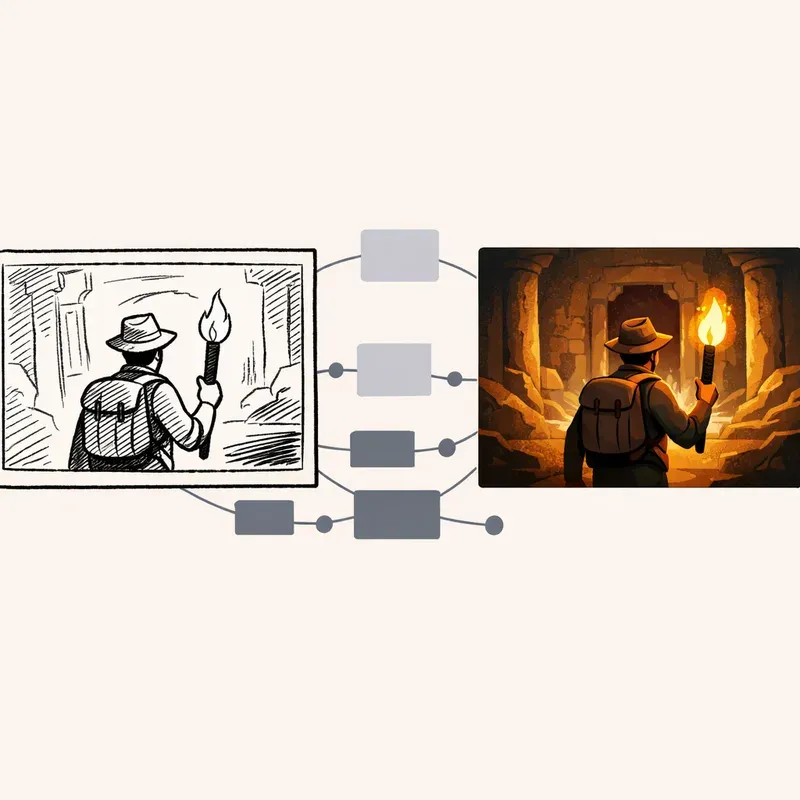
영화는 긴 프롬프트 한 줄로 완성되지 않는다. 좋은 AI 단편은 늘 작은 승인들의 연속으로 만들어진다. 시놉시스를 정리하고, 샷을 나누고, 스토리보드를 뽑고, 마음에 드는 프레임을 고르고, 그 프레임에 움직임을 주고, 대사와 음향을 붙이고, 마지막에 다시 편집한다. ComfyUI가 영화 제작에 강한 이유는 바로 이 과정 전체를 캔버스 위에서 눈으로 확인하고, 고치고, 재사용할 수 있기 때문이다.1
이 장에서는 책의 핵심 약속인 "이미지에서 영상까지"를 가장 입체적으로 실습한다. 목표는 단순한 테스트 클립이 아니라, 스토리보드부터 이미지, 영상, 음성, 최종 편집까지 이어지는 짧은 AI 영화 한 편을 완성하는 것이다.
프로젝트 브리프: 60초짜리 영화는 어떻게 쪼개야 하는가
이번 프로젝트의 권장 목표는 45초에서 90초 사이의 단편이다. 그보다 길어지면 모델 품질보다 제작 관리가 먼저 무너진다. 반대로 너무 짧으면 장면 전환, 샷 연결, 음향 설계의 맛을 제대로 경험하기 어렵다.
예시 작품으로는 다음과 같은 미니 시놉시스를 잡아보자.
제목: 비가 멈춘 후
비 내리는 근미래 도시. 기억을 잃은 배달 기사가 작은 데이터 칩 하나를 발견하고, 그것이 자신의 과거와 연결되어 있음을 깨닫는다. 마지막 장면에서 그는 새벽빛이 번지는 옥상 위에서 칩을 재생하고, 사라졌던 목소리를 다시 듣는다.
이 정도면 충분하다. 인물은 1명, 핵심 소품은 1개, 주요 배경은 1~2개면 된다. AI 영화에서 세계관을 크게 벌리는 것보다, 적게 잡고 깊게 밀어붙이는 편이 훨씬 결과가 좋다.
작업 단위는 영화 전체가 아니라 샷이다. 실전에서는 3초에서 6초짜리 샷 여러 개를 만들어 이어 붙이는 방식이 가장 안정적이다. 한 번에 1분짜리 영상을 뽑으려 하면 모델보다 먼저 제작자의 멘탈이 흔들린다.
| 단계 | 주력 도구 | 산출물 |
|---|---|---|
| 기획 | LLM, 텍스트 노드 | 로그라인, 샷리스트, 대사 초안 |
| 스토리보드 | FLUX, Qwen-Image, Z-Image 계열 | 샷별 키프레임 |
| 본 촬영용 생성 | Wan 2.2, LTX-2 | 샷별 영상 클립 |
| 음성/음향 | TTS 또는 LTX 오디오 생성 | 대사, 앰비언스, 임시 사운드 |
| 후반 | VideoCombine, 편집기 | 최종 단편 영상 |
프리프로덕션: 시놉시스를 샷리스트로 바꾸기
많은 초보자가 여기서 바로 이미지부터 만든다. 하지만 프로덕션에서는 반대로 간다. 먼저 이야기를 샷 단위의 지시문으로 쪼갠다. 이 작업을 잘해야 뒤에서 프롬프트가 덜 흔들린다.
커뮤니티의 장편형 워크플로우 사례를 보면, 시나리오 작성자, 촬영감독, 애니메이션 디렉터, 보이스 캐스팅 역할을 분리해 전처리하는 방식이 자주 쓰인다. 즉, "무슨 이야기를 할까"와 "어떤 그림으로 찍을까"와 "어떻게 움직일까"를 같은 프롬프트에 섞지 않는다는 뜻이다.23
실전에서는 다음 네 문서를 먼저 만든다.
스토리 로그라인: 영화 전체를 한두 문장으로 압축한 것
캐릭터 바이블: 인물 외형, 의상, 나이대, 표정 습관, 소지품
비주얼 바이블: 렌즈 느낌, 색감, 조명, 날씨, 카메라 질감
샷리스트: 샷 번호, 구도, 행동, 대사, 길이
특히 캐릭터 바이블은 한 번 정하면 가능한 한 문장을 그대로 반복해서 쓰는 편이 좋다. 자동 영화 제작 파이프라인 사례에서도 장면마다 인물 설명을 새로 바꾸기보다, 동일한 묘사를 반복 주입해 일관성을 높이는 접근이 강조된다.2
예시 샷리스트는 이렇게 잡을 수 있다.
| 샷 | 길이 | 구도 | 내용 | 권장 모델 |
|---|---|---|---|---|
| 1 | 4초 | 와이드 | 비 오는 골목, 주인공이 프레임 안으로 들어온다 | Wan 2.2 I2V |
| 2 | 3초 | 클로즈업 | 젖은 손바닥 위 데이터 칩 | Wan 2.2 I2V |
| 3 | 5초 | 오버숄더 | 칩에서 홀로그램이 켜진다 | Wan 2.2 I2V |
| 4 | 4초 | 미디엄 | 주인공이 낮은 목소리로 한 마디 속삭인다 | LTX-2 I2V |
| 5 | 5초 | 트래킹 | 카메라가 천천히 밀고 들어오며 감정 고조 | Wan 2.2 I2V |
| 6 | 6초 | 와이드 | 새벽 옥상, 목소리가 재생된다 | LTX-2 T2V 또는 I2V |
이 표를 만든 순간, 영화는 훨씬 쉬워진다. 이제 해야 할 일은 "좋은 영화를 상상하기"가 아니라 "샷 6개를 정확히 생산하기"가 되기 때문이다.
스토리보드: 비싸기 전에 싸게 틀리기
영상 생성은 비싸다. 시간도 먹고 VRAM도 먹고, 무엇보다 다시 돌릴 때 체력도 먹는다. 그래서 먼저 빠른 이미지 모델로 스토리보드를 만든다. 자동 영화 제작 도구들도 본격적인 비디오 생성 전에 장면별 키프레임을 만들고, 사람이 검토·승인한 뒤 다음 단계로 넘어가도록 설계하는 경우가 많다.2
여기서 중요한 것은 "멋진 그림"이 아니라 "올바른 그림"이다. 스토리보드 단계에서는 다음 세 가지만 확인하면 된다.
주인공이 내가 원하는 사람처럼 보이는가
구도와 렌즈 느낌이 이야기 의도와 맞는가
다음 샷으로 자연스럽게 이어질 수 있는가
이 단계에서는 해상도를 높이지 말자. 빠른 반복이 핵심이다. 한 샷당 4~8개의 변주를 뽑고, 그중 한 장만 승인한다. 승인된 이미지는 나중에 영상의 시작 프레임, 스타일 기준, 재촬영 기준으로 계속 재사용된다.
실무 팁도 하나 기억해두면 좋다. 좋은 단편 AI 영화는 샷마다 새 세상을 만들지 않는다. 같은 인물, 같은 장소, 같은 소품을 조금씩 다른 구도와 동선으로 보여준다. 관객은 그걸 "일관성"이라고 느끼고, 제작자는 그걸 "생존"이라고 부른다.
영상 모델 역할 분담: Wan 2.2는 카메라, LTX-2는 리듬
이 프로젝트의 핵심은 모든 샷을 한 모델로 해결하지 않는 것이다. 프로덕션 관점에서는 모델을 취향이 아니라 역할로 나눈다.
Wan 2.2는 영화적 미학 제어, 복잡한 움직임, 의미 준수에서 강점을 가진다. 공식 문서도 텍스트-비디오와 이미지-비디오를 모두 지원하며, 조명·색·구도 같은 시네마틱 제어에 강하다고 설명한다. 또한 Wan 2.2 오픈소스 계열은 Apache 2.0 기반으로 공개된 버전이 있어 상업 활용 검토에도 비교적 명확한 편이다.4
반면 LTX-2는 오디오와 비디오를 한 번에 생성하는 것이 큰 특징이다. 텍스트-비디오, 이미지-비디오, 비디오-비디오, 키프레임 기반 생성, 네이티브 업스케일러까지 지원하므로, 대사가 들어가는 샷이나 프리비즈를 빠르게 뽑는 데 특히 유리하다.5 ComfyUI 쪽 통합도 잘 되어 있어 템플릿 라이브러리에서 워크플로우를 불러오고 필요한 모델을 자동으로 받는 방식으로 시작하기 쉽다.6
실전 감각으로 정리하면 이렇다. 커뮤니티 비교에서도 LTX 계열은 빠른 초안과 반복 실험에, Wan 2.2는 무게감 있는 카메라 움직임과 파이널 품질 추구에 더 잘 맞는 편으로 평가된다.7
| 상황 | 더 어울리는 선택 |
|---|---|
| 장면 아이디어를 빨리 확인하고 싶다 | LTX-2 |
| 정적인 이미지에 영화 같은 움직임을 주고 싶다 | Wan 2.2 I2V |
| 대사와 움직임을 동시에 맞추고 싶다 | LTX-2 |
| 카메라 무게감, 시네마틱 질감을 우선한다 | Wan 2.2 |
| 최종본 전에 프리비즈를 여러 개 뽑고 싶다 | LTX-2 |
그래서 이 장의 권장 전략은 간단하다. 스토리보드는 빠른 이미지 모델로, 감정 샷과 카메라 샷은 Wan 2.2로, 대사 샷과 임시 사운드는 LTX-2로 간다.
ComfyUI 그래프 설계: 영화는 한 장의 캔버스에서 조립된다
이 프로젝트의 워크플로우는 크게 여섯 구역으로 나누면 관리가 편하다.
입력 구역: 시놉시스, 캐릭터 바이블, 장면 수, 레퍼런스 이미지
기획 구역: 샷리스트 생성, 대사 분리, 샷별 프롬프트 정리
스토리보드 구역: 샷별 키프레임 생성 및 선택
영상 구역: Wan 또는 LTX로 샷별 영상 생성
오디오 구역: 대사, 효과음, 임시 음악, 길이 계산
조립 구역: 샷 결합, 업스케일, 프레임 보간, 최종 저장
이때 가장 중요한 설계 원리는 두 가지다.
첫째, 샷을 독립적으로 재생성할 수 있어야 한다. 샷 4가 마음에 안 들면 샷 4만 갈아끼울 수 있어야지, 영화 전체를 처음부터 다시 돌리면 안 된다.
둘째, 샷은 연결되어 보여야 한다. 이를 위해 커뮤니티의 내러티브 비디오 워크플로우에서는 이전 클립의 마지막 프레임을 다음 장면의 출발점으로 쓰는 "last-frame continuation" 기법을 적극 활용한다. 장면 전환 프롬프트에 "다음 샷" 성격의 지시를 넣고, 마지막 프레임을 편집 모델의 입력으로 사용하면 구도만 바꾸고 인물과 공간을 유지하기가 쉬워진다.3
즉, 구조는 이렇게 생각하면 된다.
샷 1 키프레임 생성 → 샷 1 영상화 → 마지막 프레임 추출 → 샷 2의 시작 프레임으로 전달 → 새 구도만 지정 → 샷 2 영상화
이 패턴을 반복하면 "장면마다 다른 사람이 나오는 병"을 크게 줄일 수 있다.
구현 단계 1: 첫 장면은 영화의 기준 프레임이 된다
첫 장면은 단순한 오프닝이 아니다. 전체 영화의 색감, 얼굴, 의상, 배경 질서를 정하는 기준 프레임이다. 그래서 샷 1에 시간을 아끼면 뒤에서 더 많은 시간을 잃는다.
샷 1 제작 순서는 보통 이렇다.
먼저 빠른 이미지 모델로 여러 장의 스토리보드를 만든다. 그중 가장 좋은 한 장을 고른 뒤, 해상도와 디테일을 올린 "마스터 키프레임"을 만든다. 이 이미지는 이후 모든 샷의 참조 이미지가 된다.
그다음 Wan 2.2 I2V로 이 키프레임에 짧은 움직임을 부여한다. 여기서 프롬프트는 욕심을 줄일수록 좋다. "비가 내린다, 코트 자락이 흔들린다, 카메라가 아주 천천히 앞으로 이동한다" 정도면 충분하다. 한 샷 안에 팬, 틸트, 줌, 회전, 배우 이동을 다 넣으면 대부분은 아름답게 망가진다.
첫 샷은 3~4초면 충분하다. 감탄사를 유도하는 것보다, 다음 샷으로 이어질 여지를 남기는 편이 더 영화답다.
구현 단계 2: 다음 샷은 새로 그리는 것이 아니라 이어 찍는 것이다
초보자는 샷 2를 만들 때 또 처음부터 프롬프트를 쓴다. 하지만 프로덕션에서는 이전 샷의 결과를 다음 샷의 자산으로 사용한다. 이 발상 전환이 중요하다.
가장 실용적인 방식은 이전 영상의 마지막 프레임을 저장한 뒤, 그 프레임을 이미지 편집 단계에 넣어 새 구도만 지시하는 것이다. 커뮤니티의 풀루프 영화형 워크플로우도 이 방식을 사용해 장면 간 연속성을 확보한다.3
예를 들어 샷 1이 "비 오는 골목을 걷는 와이드샷"이었다면, 샷 2는 마지막 프레임을 받아 다음과 같이 바꾼다.
"같은 인물, 같은 장소, 같은 비 분위기. 이번에는 손바닥 위 칩에 초점을 맞춘 클로즈업. 배경은 흐리게."
핵심은 "무엇을 바꿀지"만 말하는 것이다. 나머지는 유지하라고 암묵적으로 밀어주는 편이 안정적이다. 이렇게 해야 얼굴, 의상, 장소가 덜 흔들린다.
이 방식은 특히 다음과 같은 연결에서 강력하다.
와이드샷 → 미디엄샷
미디엄샷 → 클로즈업
정면샷 → 오버숄더
낮은 카메라 → 높은 카메라
한마디로, 컷 편집의 문법을 AI에게 가르치는 셈이다.
구현 단계 3: 대사 장면은 LTX-2로 따로 다루는 편이 편하다
대사가 있는 샷은 문제의 종류가 달라진다. 이제는 화면만 좋다고 끝이 아니다. 입 모양, 길이, 감정, 배경음까지 한꺼번에 신경 써야 한다.
이럴 때 LTX-2가 빛난다. LTX-2는 영상과 오디오를 한 번에 생성할 수 있고, 이미지 기반으로도 영상을 확장할 수 있다.5 그래서 샷 4처럼 주인공이 짧게 속삭이는 장면은 Wan 2.2로 억지로 버티기보다, 승인된 키프레임을 LTX-2 I2V로 넘겨 처리하는 편이 효율적이다.
방법은 두 가지다. 하나는 LTX가 자체적으로 오디오까지 생성하게 두는 것이고, 다른 하나는 외부에서 만든 음성을 넣어 오디오 드리븐으로 처리하는 것이다. 후자가 더 통제 가능하다. LTX 오디오 연동 예제에서는 프레임 수를 FPS와 길이에 맞춰 계산하고, 해상도는 32의 배수로 맞추는 것을 기본으로 안내한다. distilled 계열 설정에서는 8스텝 정도의 낮은 스텝도 빠른 실험에 유용하다.8
초안 단계라면 LTX의 네이티브 오디오로 충분하다. 그러나 최종본에서 대사 톤을 세밀하게 만지고 싶다면, 외부 TTS나 직접 녹음한 음성을 넣고 길이를 정확히 맞추는 편이 좋다. 커뮤니티 영화 워크플로우들에서 오디오 길이를 계산해 프레임 수와 직접 연결하는 노드가 중요한 이유도 여기에 있다.3
오디오 설계: 귀가 허술하면 화면도 싸 보인다
AI 영상은 화면에서 먼저 감탄을 얻지만, 완성도는 소리에서 결정된다. 화면이 조금 흔들려도 음향이 좋으면 "의도"처럼 보일 때가 많다. 반대로 그림이 좋아도 소리가 텅 비면 바로 데모 티가 난다.
가장 현실적인 오디오 전략은 3층 구조다.
대사층: 등장인물 목소리, 내레이션, 속삭임
환경층: 빗소리, 발소리, 도시 소음, 기계음
음악층: 감정 방향만 잡아주는 얇은 스코어
중요한 것은 세 층을 한꺼번에 완벽하게 만들려 하지 않는 것이다. 먼저 대사층만 맞춰도 영화는 이미 절반쯤 살아난다. 그다음 환경음을 얹고, 마지막에 음악을 조심스럽게 더한다. 음악을 먼저 세게 깔면 웅장해지기는커녕 대부분의 문제를 덮어버린다.
대사 길이는 영상 길이를 지배한다. 그래서 샷을 만들기 전에 대사를 먼저 확정하거나, 반대로 생성된 오디오 길이를 읽어 프레임 수를 계산해야 한다. "말은 2.3초인데 샷은 4초"인 상태를 방치하면 입 모양보다 편집 리듬이 먼저 어색해진다.
프리비즈와 파이널을 분리하면 완성도가 올라간다
많은 사람이 최종 품질로 바로 달려든다. 하지만 영화 프로젝트에서는 프리비즈와 파이널을 분리하는 편이 훨씬 낫다. LTX 통합 문서도 새 프로젝트를 시작할 때는 낮은 해상도와 짧은 프레임 수로 먼저 검증한 뒤, 만족한 장면만 품질을 올리라고 권한다.6
권장 운영 방식은 이렇다.
| 단계 | 해상도/길이 | 목적 |
|---|---|---|
| 프리비즈 | 480p~720p, 2~4초 | 구도, 연기, 대사 길이 확인 |
| 프로덕션 프리뷰 | 720p, 3~6초 | 샷 연결, 색감, 카메라 무게감 확인 |
| 파이널 | 필요한 샷만 1080p 이상 | 최종 업스케일과 편집 |
낮은 해상도에서 안 되는 샷은 높은 해상도에서도 안 될 가능성이 높다. 반대로 낮은 해상도에서 이미 설계가 맞는 샷은, 파이널 단계에서 돈과 시간만 더 쓰면 훨씬 좋은 결과로 올라온다.
실패를 줄이는 다섯 가지 규칙
실전에서 자주 무너지는 지점은 의외로 비슷하다.
인물 설명을 샷마다 바꾸지 말 것: 옷, 얼굴, 나이, 분위기 문장을 고정해야 한다.
한 샷에 카메라 동작은 하나만 줄 것: 팬과 줌과 회전을 동시에 욕심내면 모두 약해진다.
긴 샷보다 짧은 샷을 여러 개 만들 것: 4초짜리 좋은 샷 셋이 12초짜리 불안한 샷 하나보다 훨씬 낫다.
대사 샷과 무대사 샷을 같은 방식으로 만들지 말 것: 오디오 정합성 요구가 다르다.
처음부터 최종 해상도로 가지 말 것: 프리비즈를 건너뛰면 수정비가 폭발한다.
여기에 하나를 더 보태고 싶다. 좋은 AI 영화는 생성보다 선택에서 나온다. 10개의 샷을 모두 고쳐서 살리는 사람보다, 10개 중 2개를 버리고 8개를 단정하게 이어붙이는 사람이 더 좋은 결과를 만든다.
최종 조립: 영화처럼 보이게 만드는 마지막 10%
샷이 다 나왔다면 이제는 생성보다 편집의 시간이다. 샷과 샷 사이를 이어 붙일 때는 화려한 전환보다 단순한 컷 편집이 더 낫다. AI 영상은 이미 프레임 내부 정보량이 많아서, 화면 전환까지 복잡하면 금세 산만해진다.
편집 단계에서는 다음 순서로 확인하자.
첫째, 이야기가 이해되는가. 둘째, 샷의 길이가 감정보다 길지 않은가. 셋째, 소리가 장면을 받쳐주는가. 넷째, 어색한 샷 하나가 전체를 망치고 있지 않은가.
필요하다면 프레임 보간이나 업스케일은 마지막에만 적용한다. 중간 단계에서 계속 보간·업스케일을 넣으면 렌더 시간만 늘고 판단은 오히려 흐려진다. 먼저 영화로서 성립시키고, 그다음 화질을 올리는 편이 맞다.
이 프로젝트의 진짜 성과
이 장의 목적은 단순히 짧은 AI 영상을 하나 만드는 것이 아니다. 더 중요한 것은 영화를 노드 단위의 생산 공정으로 이해하는 감각을 얻는 것이다.
시놉시스는 텍스트 입력이 되고, 샷리스트는 분기 구조가 되고, 스토리보드는 이미지 자산이 되고, 마지막 프레임은 다음 샷의 조건이 되고, 대사는 프레임 수 계산의 기준이 된다. 이 순간 ComfyUI는 더 이상 이미지 생성기가 아니다. 작은 영화 스튜디오가 된다.
그리고 바로 그 지점에서, 이 책의 제목은 실제가 된다. 이미지를 만드는 법을 아는 사람과, 이미지를 영상으로 연결해 하나의 이야기로 완성하는 사람 사이에는 꽤 큰 차이가 있다. 이 프로젝트는 그 차이를 건너가는 다리다.
참고
3ComfyUI Workflow: Sora2-Alike Full Loop Video
4Wan2.2 Video Generation ComfyUI Official Native Workflow Example
5LTX-2.0 ComfyUI Workflow Examples
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.