


9. 두 번째 프로젝트: 카메라로 사물을 인식하는 AI 로봇
두 번째 프로젝트: 카메라로 사물을 인식하는 AI 로봇
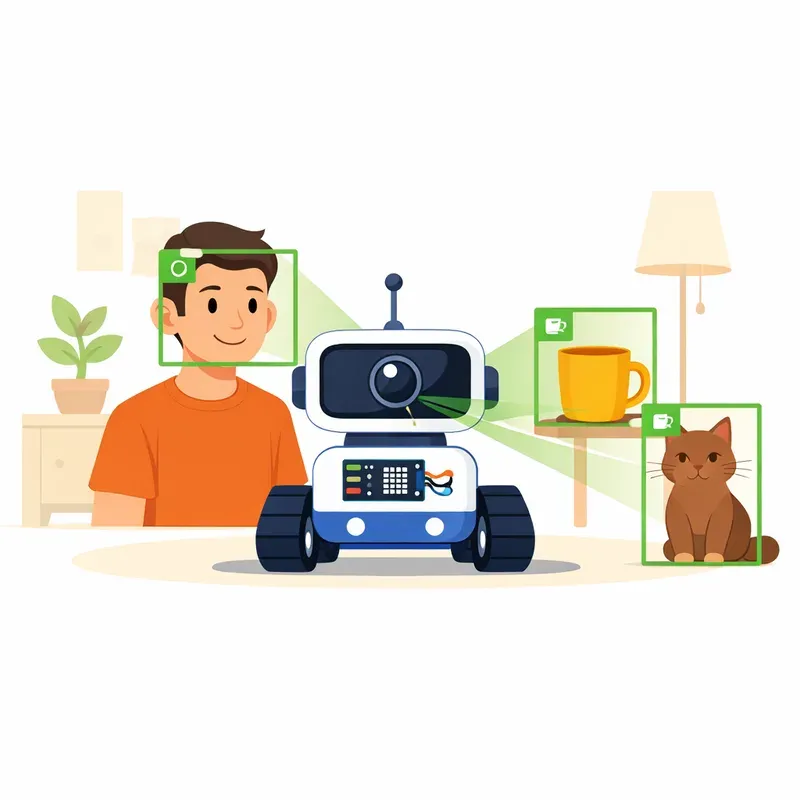
이제 로봇은 단순히 피하는 것이 아니라 본다
앞 장에서 만든 작은 이동 로봇은 앞에 뭔가 있는지 없는지를 거리 센서로 판단했습니다. 그것만으로도 꽤 그럴듯한 자율 행동이 가능했습니다. 하지만 아직 그 로봇은 세상을 아주 거칠게 보고 있었습니다. 앞에 벽이 있는지, 장애물이 가까운지 정도만 알 뿐이었죠.
이번 장에서는 여기에 카메라를 더합니다. 그러면 로봇은 단순히 "무언가 있다"를 넘어서 "사람이 있다", "컵이 있다", "책이 있다", "QR 코드가 보인다"처럼 장면을 해석하기 시작합니다. 바로 이 지점부터 로봇은 단순한 기계 장치에서 시각을 가진 시스템으로 바뀝니다.
여기서 아주 중요한 구분이 하나 있습니다. 탐지(detection)는 화면 어딘가에 대상이 있다는 것을 찾는 일이고, 인식(recognition)은 그 대상이 무엇인지 구분하는 일입니다. 로봇에게 이 차이는 꽤 큽니다. 그냥 뭔가 있다는 것과, 그게 사람인지 컵인지 알아내는 것은 전혀 다른 수준의 능력이기 때문입니다.1
이번 프로젝트에서 만들 것
이번 프로젝트의 목표는 카메라 입력을 받아 사람과 사물을 인식하고, 그 결과를 로봇 행동으로 연결하는 것입니다. 꼭 거대한 자율주행 로봇일 필요는 없습니다. 앞 장에서 만든 바퀴형 로봇 위에 카메라를 달아도 좋고, 책상 위에 고정된 작은 데스크 로봇으로 시작해도 됩니다.
이번 장에서 성공으로 볼 수 있는 기준은 다음과 같습니다.
카메라 영상을 실시간으로 읽어 온다.
화면 속 사람, 컵, 책 같은 대상을 찾아 박스로 표시한다.
여러 대상 중 지금 무엇에 반응할지 고른다.
인식 결과를 바탕으로 회전, 전진, 정지, 알림 같은 행동을 만든다.
핵심은 완벽한 정확도가 아닙니다. 카메라를 통해 세상을 보고, 그 장면을 해석한 뒤, 실제 행동으로 이어지는 흐름을 몸으로 익히는 것이 더 중요합니다.
왜 카메라가 달리면 로봇이 갑자기 똑똑해 보일까
카메라는 로봇에게 가장 인간적인 센서 중 하나입니다. 사람도 눈으로 장면을 보고, 대상을 구분하고, 거리를 짐작하고, 다음 행동을 결정합니다. 로봇도 비슷합니다. 카메라가 들어오면 주변 환경의 모양, 색, 위치, 움직임을 더 풍부하게 받아들일 수 있습니다. 카메라와 비전 알고리즘은 로봇의 지각 능력을 크게 넓혀 주고, 깊이 카메라나 스테레오 카메라를 쓰면 거리와 입체 정보까지 더 잘 다룰 수 있습니다.2
하지만 처음부터 깊이 카메라로 갈 필요는 없습니다. 입문 단계에서는 RGB 카메라 하나만으로도 충분히 재미있는 결과를 만들 수 있습니다. 사람, 컵, 책, QR 코드, 얼굴, 특정 색 물체 정도만 잘 잡아도 로봇은 금방 살아 있는 것처럼 보입니다.
어떤 하드웨어가 필요할까
이번 프로젝트는 생각보다 소박하게 시작할 수 있습니다. 이미 앞 장의 이동 로봇이 있다면 가장 좋습니다. 그 위에 카메라와 조금 더 강한 두뇌를 올리면 됩니다. 완전히 새로 만든다면 책상 위에 놓는 고정형 로봇으로 시작해도 괜찮습니다.
추천 구성은 이 정도면 충분합니다.
| 구성 요소 | 입문용 추천 | 설명 |
|---|---|---|
| 본체 | 이동 로봇 또는 데스크 스탠드 | 움직이는 몸이 있으면 더 재미있고, 없어도 비전 실험은 가능하다 |
| 연산 장치 | PC, 라즈베리파이 5, Jetson Orin Nano 계열 | 카메라 영상 처리와 모델 추론을 담당한다 |
| 카메라 | USB 웹캠, 라즈베리파이 카메라 | 가장 쉽게 구할 수 있는 RGB 카메라로 충분하다 |
| 선택 장치 | 서보 모터, 작은 디스플레이, 스피커 | 고개 돌리기, 표정 표시, 음성 응답에 쓸 수 있다 |
| 전원 | 안정적인 어댑터 또는 배터리 팩 | 카메라와 보드가 꺼지지 않게 전원을 넉넉히 잡아야 한다 |
여기서 초보자에게 가장 현실적인 조합은 두 가지입니다. 하나는 PC와 USB 카메라 조합이고, 다른 하나는 라즈베리파이 5 또는 Jetson과 카메라 조합입니다. 전자는 개발과 디버깅이 편하고, 후자는 실제 로봇에 바로 올리기 좋습니다.
OpenCV로 갈까, 경량 AI 모델로 갈까
이번 프로젝트에서 가장 많이 고민하는 부분이 바로 이것입니다. 비전 기능을 구현하는 방법은 크게 두 갈래로 나눌 수 있습니다.
첫 번째는 OpenCV 중심 접근입니다. OpenCV는 카메라 입력, 영상 처리, 필터링, QR 코드 읽기, 얼굴 검출, 기본적인 사람 검출, 추적 같은 작업을 다루기 좋은 대표적인 오픈소스 라이브러리입니다. 게다가 DNN 모듈을 통해 다른 프레임워크에서 만든 모델을 가져와 실행하는 데도 쓸 수 있습니다.3
두 번째는 경량 객체 인식 모델 중심 접근입니다. 예를 들면 YOLO 계열의 작은 모델이나 SSD-MobileNet 같은 가벼운 모델을 써서 사람, 컵, 책, 병, 의자처럼 여러 범주의 대상을 한 번에 찾는 방식입니다. 이쪽은 더 AI 로봇답고 확장성이 좋지만, 연산량이 더 큽니다.
둘 중 어느 쪽이 더 좋다고 딱 잘라 말하기는 어렵습니다. 목적이 다르기 때문입니다.
| 방식 | 장점 | 단점 | 이런 경우 추천 |
|---|---|---|---|
| OpenCV 기본 기능 | 설치와 실험이 쉽고 가볍다 | 인식 범위가 좁고 환경 변화에 약할 수 있다 | QR 코드, 얼굴, 특정 색 물체, 단순 실험 |
| HOG 기반 사람 검출 | CPU에서도 비교적 빠르다 | 보행자 형태에는 강하지만 일반 사물 인식에는 부적합하다 | 사람 감지 입문, 저사양 환경 |
| 경량 객체 인식 모델 | 여러 사물을 동시에 찾을 수 있다 | 더 높은 연산 성능이 필요하다 | 사람, 컵, 책 등 범용 객체 인식 |
특히 OpenCV의 HOG 기반 사람 검출은 CPU에서 빠르게 돌아가는 편이라 입문자에게 좋은 맛보기입니다. 다만 이 방식은 서 있는 사람 형태에는 괜찮지만, 다양한 자세나 일반 사물 인식까지 넓게 다루기에는 한계가 있습니다.4
반대로 Jetson 같은 GPU 보드는 이런 경량 모델을 실시간에 가깝게 돌리기에 훨씬 유리합니다. 엣지 AI 장치는 클라우드에 의존하지 않고도 카메라 입력을 현장에서 바로 처리할 수 있어 로봇에 잘 맞습니다.5 Jetson 생태계에서는 SSD-MobileNet, PeopleNet 같은 사전 학습 모델과 TensorRT 최적화 도구를 활용해 카메라 기반 추론을 더 쉽게 올릴 수 있습니다.6
처음 시작하는 독자라면 이렇게 생각하면 됩니다. OpenCV는 카메라와 영상을 다루는 기본 공구함이고, 경량 객체 인식 모델은 그 위에 올리는 똑똑한 눈입니다.
이번 장의 권장 개발 순서
이 프로젝트는 한 번에 끝내려고 하면 꽤 헷갈립니다. 가장 좋은 방법은 단계를 나누는 것입니다.
카메라 화면을 띄운다.
화면에서 대상을 찾는다.
찾은 대상 중 무엇에 반응할지 고른다.
화면 위치와 크기를 바탕으로 행동을 만든다.
마지막에 그 행동을 실제 모터 제어로 연결한다.
이 순서를 지키면 문제를 찾기 쉽습니다. 카메라가 안 뜨는 문제와, 모델이 못 찾는 문제와, 로봇이 이상하게 도는 문제를 한꺼번에 섞지 않게 됩니다.
로봇 비전의 기본 흐름
로봇이 카메라를 이용해 사물을 인식할 때 내부에서는 대체로 이런 흐름이 돕니다.
카메라 입력 → 프레임 전처리 → 객체 탐지 또는 인식 → 가장 중요한 대상 선택 → 행동 결정 → 화면 표시 또는 모터 제어
이 구조는 앞서 본 입력, 판단, 출력 구조가 그대로 확장된 모습입니다. 달라진 것은 입력이 초음파 센서에서 카메라로 바뀌었고, 판단이 단순 조건문에서 비전 알고리즘까지 넓어졌다는 점입니다.
첫 번째 목표: 카메라가 잘 보이는지 확인하기
가장 먼저 할 일은 매우 단순합니다. 카메라가 제대로 들어오는지 확인하는 것입니다. 이 단계에서부터 모델을 얹으려 하면 어디서 문제가 생겼는지 알기 어렵습니다.
import cv2

cap = cv2.VideoCapture(0)

while True:
    ok, frame = cap.read()
    if not ok:
        break

    cv2.imshow('camera', frame)

    if cv2.waitKey(1) & 0xFF == ord('q'):
        break

cap.release()
cv2.destroyAllWindows()
이 코드가 잘 동작하면 절반은 성공입니다. 화면이 나온다는 것은 카메라 연결, 장치 인식, 기본 OpenCV 설치가 정상이라는 뜻입니다.
두 번째 목표: 가장 작은 AI 성공 만들기
이제부터 선택지가 갈립니다. 아주 가볍게 시작하고 싶다면 OpenCV의 기본 기능으로 QR 코드나 얼굴, 사람을 먼저 잡아 볼 수 있습니다. 하지만 이번 장의 목표는 사람과 사물을 모두 인식하는 데 있으므로, 여기서는 경량 객체 인식 모델을 붙이는 흐름을 권장하겠습니다.
예시에서는 설치가 쉬운 소형 YOLO 계열 모델을 사용합니다. 모델 이름은 시간이 지나면 바뀔 수 있지만, 중요한 것은 이름이 아니라 접근 방식입니다. 작은 사전 학습 모델을 가져와 카메라 프레임에 적용하고, 관심 있는 클래스만 골라 쓰는 방식이 핵심입니다.
설치 예시는 다음처럼 시작할 수 있습니다.
pip install opencv-python ultralytics그리고 아래와 같이 가장 단순한 객체 인식 루프를 만들 수 있습니다.
import cv2
from ultralytics import YOLO

model = YOLO('yolov8n.pt')
targets = {'person', 'cup', 'book'}

cap = cv2.VideoCapture(0)
cap.set(cv2.CAP_PROP_FRAME_WIDTH, 640)
cap.set(cv2.CAP_PROP_FRAME_HEIGHT, 480)

while True:
    ok, frame = cap.read()
    if not ok:
        break

    results = model(frame, imgsz=640, conf=0.45, verbose=False)[0]

    best = None
    for box in results.boxes:
        cls_id = int(box.cls[0])
        name = model.names[cls_id]
        conf = float(box.conf[0])

        if name not in targets:
            continue

        x1, y1, x2, y2 = map(int, box.xyxy[0])
        area = (x2 - x1) * (y2 - y1)

        cv2.rectangle(frame, (x1, y1), (x2, y2), (0, 255, 0), 2)
        cv2.putText(frame, f'{name} {conf:.2f}', (x1, y1 - 10),
                    cv2.FONT_HERSHEY_SIMPLEX, 0.6, (0, 255, 0), 2)

        if best is None or area > best['area']:
            best = {
                'name': name,
                'box': (x1, y1, x2, y2),
                'area': area
            }

    action = 'SEARCH'

    if best is not None:
        x1, y1, x2, y2 = best['box']
        frame_h, frame_w = frame.shape[:2]
        center_x = (x1 + x2) // 2
        box_w = x2 - x1

        if center_x < frame_w * 0.35:
            action = 'TURN_LEFT'
        elif center_x > frame_w * 0.65:
            action = 'TURN_RIGHT'
        elif box_w < frame_w * 0.20:
            action = 'MOVE_FORWARD'
        else:
            action = 'STOP'

        cv2.putText(frame, f"target: {best['name']}", (20, 30),
                    cv2.FONT_HERSHEY_SIMPLEX, 0.8, (255, 255, 0), 2)

    cv2.putText(frame, f'action: {action}', (20, 60),
                cv2.FONT_HERSHEY_SIMPLEX, 0.8, (0, 200, 255), 2)

    print(action)
    cv2.imshow('ai_robot_vision', frame)

    if cv2.waitKey(1) & 0xFF == ord('q'):
        break

cap.release()
cv2.destroyAllWindows()
이 코드가 하는 일은 단순합니다. 카메라 프레임에서 사람, 컵, 책만 골라 찾고, 그중 가장 크게 보이는 대상을 현재의 주요 목표로 선택합니다. 그다음 화면의 왼쪽에 있으면 왼쪽으로 돌고, 오른쪽에 있으면 오른쪽으로 돌고, 너무 작게 보이면 앞으로 가고, 충분히 크게 보이면 멈추도록 행동 문자열을 만듭니다.
아직은 print(action)만 하고 있지만, 이 한 줄이 나중에는 실제 모터 제어 함수로 바뀝니다. 그러면 로봇은 단순히 화면에 박스를 그리는 수준을 넘어서, 자신이 본 것에 반응하는 기계가 됩니다.
이 코드에서 꼭 이해해야 할 포인트
첫째, 로봇은 모든 물체를 똑같이 대하지 않습니다. targets 집합으로 관심 대상을 좁혔기 때문에, 예를 들어 사람이 보이면 따라가고 컵이 보이면 멈추거나 집기 대상으로 삼는 식의 정책을 만들 수 있습니다. 이 단계에서 이미 로봇은 목적 중심으로 세상을 보기 시작합니다.
둘째, 화면 중심과 물체 중심의 차이를 이용해 방향을 정합니다. 이것은 매우 단순하지만 로봇 제어에서 자주 쓰는 방식입니다. 사람이 화면 왼쪽에 있으면 왼쪽으로 회전해서 중앙에 맞추는 식입니다. 카메라를 목처럼 쓰는 서보 모터가 있다면 바퀴 대신 카메라 팬 축을 먼저 돌릴 수도 있습니다.
셋째, 물체 박스의 크기로 대략적인 거리를 짐작합니다. 박스가 작으면 멀리 있다고 보고 앞으로 가고, 박스가 크면 가깝다고 보고 멈추는 방식입니다. 물론 이것은 정확한 거리 측정은 아닙니다. 같은 컵이라도 카메라 각도와 렌즈 화각에 따라 크기가 달라집니다. 하지만 입문 프로젝트에서는 꽤 유용합니다.
넷째, 지금은 행동이 너무 즉흥적입니다. 프레임마다 결과가 조금만 흔들려도 TURN_LEFT와 MOVE_FORWARD가 빠르게 바뀔 수 있습니다. 실제 로봇에서는 이 출렁임을 줄이기 위해 최근 몇 프레임의 평균을 내거나, 같은 판단이 몇 번 연속 나왔을 때만 행동을 바꾸는 식의 완충 장치를 넣는 편이 좋습니다.
사람 찾기만 먼저 해보고 싶다면
만약 사물 인식까지 한 번에 가기 부담스럽다면, 사람 감지부터 시작해도 됩니다. OpenCV의 HOG 사람 검출은 비교적 가볍고 CPU에서도 돌아가서 첫 성공을 만들기 좋습니다. 다만 이 방식은 주로 보행자 형태를 잡는 데 적합하고, 컵이나 책 같은 일반 물체를 넓게 인식하는 용도로는 맞지 않습니다.4
즉, 사람만 따라오는 로봇을 빨리 만들어 보고 싶다면 HOG도 괜찮습니다. 하지만 이 장의 목표처럼 사람과 컵과 책을 함께 보고 싶다면 결국 경량 객체 인식 모델 쪽이 더 낫습니다.
실행이 느릴 때는 어떻게 해야 할까
비전 프로젝트는 생각보다 연산량을 많이 먹습니다. 카메라를 읽고, 프레임을 복사하고, 모델을 돌리고, 화면까지 그려야 하기 때문입니다. 성능이 부족할 때는 욕심을 줄이는 것이 가장 빠른 해결책입니다.
해상도를 640x480이나 320x240으로 낮춘다.
모든 프레임을 처리하지 말고 2프레임이나 3프레임에 한 번만 추론한다.
가장 작은 모델부터 쓴다.
화면 표시와 추론을 분리하고, 필요하면 제어 주기를 더 느리게 잡는다.
라즈베리파이에서 버겁다면 PC에서 먼저 검증한 뒤 Jetson 같은 GPU 보드로 옮긴다.
특히 Jetson 계열 보드는 이런 카메라 비전 실험에서 체감 차이가 큽니다. 엣지 장치에서 실시간 추론을 노릴 때 왜 많은 로봇 개발자가 Jetson을 쓰는지 금방 이해하게 됩니다.56
인식 정확도가 들쭉날쭉한 이유
처음 해보면 이상할 정도로 잘 잡히다가도, 조명만 바뀌면 갑자기 엉뚱한 결과가 나올 수 있습니다. 이것은 당신이 못해서가 아니라, 원래 비전 시스템이 현실 세계의 변화에 민감하기 때문입니다.
가장 흔한 문제는 조명 변화, 가려짐, 복잡한 배경, 물체 각도 변화입니다. 같은 컵이라도 정면, 측면, 어두운 환경, 반짝이는 배경에서 다르게 보입니다. 사람도 마찬가지입니다. 모자나 외투, 앉은 자세, 부분 가림만 있어도 모델이 흔들릴 수 있습니다. 그래서 비전 시스템은 실시간 처리 성능뿐 아니라 다양한 환경에서 얼마나 잘 일반화되는지도 중요합니다.7
이 장면에서 꼭 기억해야 할 교훈은 하나입니다. 카메라는 진실을 직접 주지 않습니다. 해석해야 할 신호를 줄 뿐입니다. 그래서 테스트는 반드시 여러 조명, 여러 거리, 여러 배경에서 해봐야 합니다.
로봇 행동에 연결할 때는 비전과 제어를 적당히 분리하자
초보자는 종종 비전 코드 안에서 바로 모터 핀을 제어하려고 합니다. 물론 작은 프로젝트에서는 그것도 가능합니다. 하지만 조금만 기능이 늘어나면 금방 코드가 엉킵니다. 가장 쉬운 습관은 비전 모듈이 먼저 행동 명령만 만들고, 모터 제어 모듈은 그 명령을 받아 실행하게 나누는 것입니다.
예를 들면 이런 식입니다.
| 비전 결과 | 행동 명령 | 실제 로봇 동작 |
|---|---|---|
| 대상 없음 | SEARCH | 천천히 제자리 회전 |
| 대상이 화면 왼쪽 | TURN_LEFT | 좌회전 또는 카메라 왼쪽 회전 |
| 대상이 화면 오른쪽 | TURN_RIGHT | 우회전 또는 카메라 오른쪽 회전 |
| 대상이 멀리 있음 | MOVE_FORWARD | 천천히 전진 |
| 대상이 충분히 가까움 | STOP | 정지 후 알림 또는 음성 응답 |
이렇게 나누면 나중에 ROS 2로 넘어갈 때도 훨씬 수월합니다. 비전 노드는 목표를 내보내고, 제어 노드는 실제 모터를 담당하면 되기 때문입니다.
책상 위에서 써먹을 수 있는 간단한 응용
이 프로젝트가 재미있는 이유는, 약간만 바꾸면 바로 쓸 만한 기능이 많이 나오기 때문입니다.
사람을 보면 고개를 돌려 바라보는 데스크 로봇
컵이나 책이 놓인 위치를 알려 주는 책상 관찰 로봇
QR 코드를 읽어 작업 모드를 바꾸는 실험용 로봇
특정 사람이나 특정 물체 쪽으로 카메라를 맞추는 촬영 보조 로봇
아직은 거창한 범용 로봇이 아닙니다. 하지만 목적이 뚜렷한 작은 로봇으로는 충분히 재미있고 실용적입니다.
여기서부터 왜 진짜 AI 로봇처럼 느껴질까
거리 센서만 달린 로봇은 반응형 기계에 가깝습니다. 반면 카메라와 객체 인식이 들어간 로봇은 장면 속 의미를 다루기 시작합니다. 사람에게는 멈추고, 컵을 보면 집기 대상으로 삼고, 책을 보면 위치를 기록하는 식으로 행동이 달라질 수 있습니다. 같은 물리적 이동이라도, 무엇을 보고 있는지에 따라 행동 이유가 달라지는 것입니다.
물론 여기서 착각하면 안 됩니다. 객체 인식이 된다고 해서 로봇이 세상을 완전히 이해하는 것은 아닙니다. 물체를 알아보는 능력은 자율성으로 가는 중요한 첫걸음이지만, 그 자체가 전부는 아닙니다. 진짜 로봇은 여기에 추적, 위치 추정, 계획, 안전 판단, 제어 안정성까지 더해져야 합니다. 그래도 이번 프로젝트는 분명한 전환점입니다. 로봇이 처음으로 "눈앞의 세계를 해석해 행동하기" 시작하기 때문입니다.
자주 만나는 문제와 해결 팁
카메라 비전 프로젝트는 절반이 디버깅입니다. 자주 만나는 문제는 대개 비슷합니다.
첫째, 카메라는 뜨는데 아무것도 인식하지 못하는 경우가 있습니다. 이럴 때는 모델이 너무 무겁거나, 신뢰도 기준값이 너무 높거나, 관심 클래스 이름이 실제 모델 라벨과 다를 수 있습니다.
둘째, 인식은 되는데 화면이 너무 느린 경우가 있습니다. 대개 해상도를 낮추고, 프레임 일부만 처리하고, 표시용 화면 크기를 줄이면 개선됩니다.
셋째, 로봇이 너무 덜덜거리며 방향을 바꾸는 경우가 있습니다. 판단을 프레임마다 즉시 반영하지 말고, 최근 5프레임 평균 중심점을 쓰거나, 일정 시간 같은 명령이 이어질 때만 모터를 바꾸면 훨씬 부드럽습니다.
넷째, 로봇이 자꾸 엉뚱한 사람이나 물체를 쫓는 경우가 있습니다. 가장 큰 박스만 고르지 말고, 특정 클래스 우선순위를 두거나, 한 번 선택한 대상을 몇 초간 유지하는 간단한 추적 규칙을 추가하면 낫습니다.
이 프로젝트를 한 단계 더 키우는 업그레이드
이번 장이 잘 되었다면, 다음 단계는 의외로 많습니다.
QR 코드 인식을 붙여 작업 모드를 바꾼다.
사람 얼굴이나 포즈 인식을 붙여 더 자연스러운 상호작용을 만든다.
추적 알고리즘을 넣어 한 번 잡은 대상을 계속 따라간다.
깊이 카메라를 써서 실제 거리와 위치를 더 안정적으로 얻는다.
음성 입출력을 붙여 "저게 뭐야?" 같은 질문에 답하게 만든다.
이 업그레이드들은 각각 다음 장의 주제와도 자연스럽게 연결됩니다. 음성을 붙이면 다음 장으로, 더 구조적인 모듈 연결은 ROS 2 파트로, 로봇팔과 결합하면 조작 프로젝트로 이어집니다.
이번 프로젝트에서 배운 것
이번 장의 진짜 수확은 단순히 박스를 그리는 코드가 아닙니다. 로봇이 카메라를 통해 세상을 입력받고, 그 장면에서 중요한 대상을 뽑아내고, 그 결과를 실제 행동으로 바꾸는 전체 흐름을 익혔다는 점입니다.
이번 프로젝트를 통해 얻은 감각은 분명합니다.
로봇 비전은 카메라만 다는 것이 아니라 해석과 행동 연결까지 포함한다.
OpenCV는 좋은 출발점이고, 경량 객체 인식 모델은 로봇을 훨씬 더 유연하게 만든다.
화면 중심, 박스 크기, 클래스 종류만으로도 꽤 그럴듯한 행동을 만들 수 있다.
현실 세계의 조명, 각도, 배경은 생각보다 큰 변수라서 테스트와 튜닝이 필수다.
앞 장의 로봇이 "앞이 막혔나?"를 물었다면, 이번 장의 로봇은 "지금 내 앞에 누가 있고 무엇이 있나?"를 묻기 시작합니다. 이 차이는 아주 큽니다. 바로 여기서부터 로봇은 단순한 자동 장치가 아니라, 보는 시스템으로 바뀌기 시작합니다.
다음 장에서는 이 시각 정보 위에 음성을 얹습니다. 그러면 로봇은 보는 데서 그치지 않고, 듣고 말하며, 사람의 명령을 실제 물리 행동으로 바꾸는 존재로 한 단계 더 진화하게 됩니다.
참고
1Object Recognition Camera: How Robots Learn to Identify What They See
2Vision-guided Robotics – How Cameras are Transforming Robotics
3How to Implement OpenCV Computer Vision Algorithms in IoT Home Automation
4Real-time Human Detection with OpenCV
5Getting Started with Edge AI on NVIDIA Jetson: LLMs, VLMs, and Foundation Models for Robotics
7AI-driven Vision Systems for Object Recognition and Localization in Robotic Automation
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.