


핵심 요약
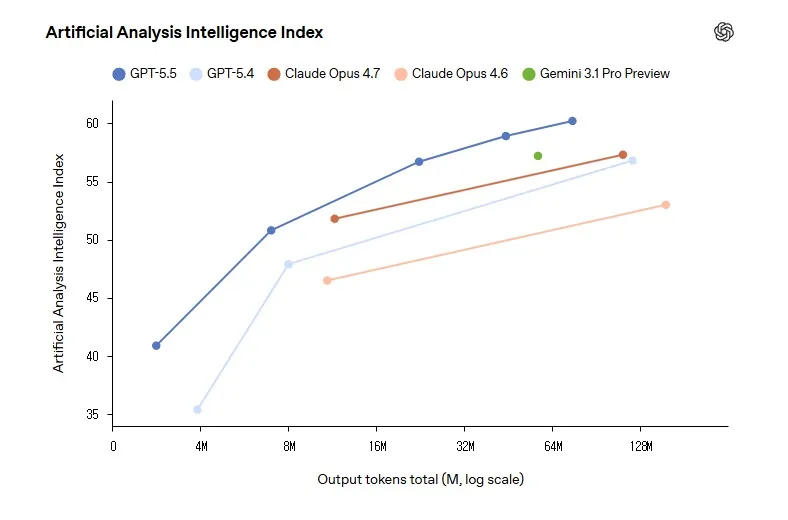
GPT-5.5는 OpenAI가 공개한 새 모델로, 코딩·컴퓨터 사용·지식 노동·초기 과학 연구에서 더 높은 성능과 더 강한 자율성을 보이도록 설계되었다. 시장 기준으로도 지난주까지는 Opus 4.7, GPT-5.4, Gemini 3.1이 공동 선두권으로 묶여 있었지만, 이날 공개 이후 GPT-5.5가 3점 차이로 단독 1위에 올랐다는 점이 함께 주목된다.1
특히 복잡한 여러 단계의 작업을 스스로 계획하고 도구를 사용해 끝까지 밀고 가는 능력이 강조된다. GPT-5.4와 비슷한 지연시간을 유지하면서도 더 적은 토큰으로 더 나은 결과를 내도록 최적화된 점도 핵심이다.1
동시에 사이버·생물 분야의 위험을 고려해 강화된 안전장치와 제한적 접근 정책도 함께 도입되었다.1
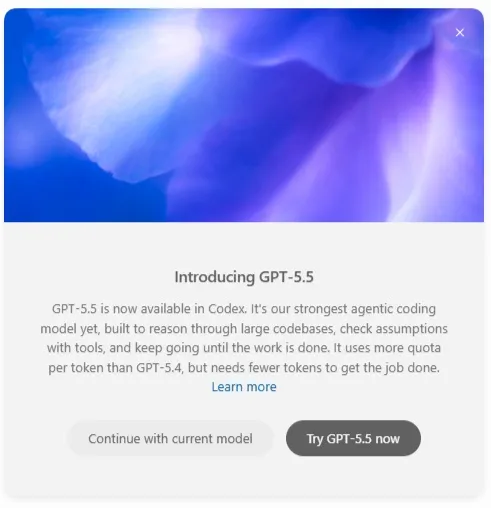
Codex 에도 GTP 5.5가 함께 공개 되었다.
Artificial Analysus 종합 인덱스는 3점 차이로 1위를 차지했다.
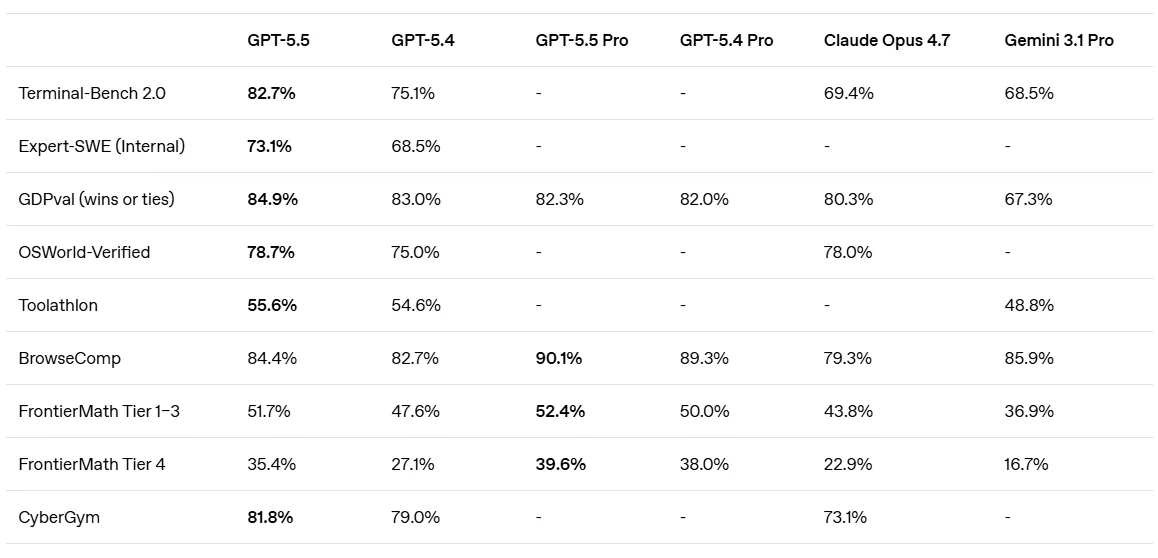
그 밖의 지표들
GPT-5.5는 무엇이 달라졌나
이 모델의 핵심 변화는 단순히 더 똑똑해졌다는 데 있지 않다. "질문에 답하는 AI"에서 "컴퓨터 앞에 앉아 실제로 일을 수행하는 AI"로 한 걸음 더 이동했다는 점이 더 중요하다.1
사용자는 이제 세부 단계를 촘촘하게 설계하기보다, 다소 엉성하고 복합적인 지시를 던질 수 있다. 그러면 모델이 스스로 계획을 세우고, 필요한 도구를 호출하고, 중간 결과를 점검하면서, 완료 단계까지 작업을 이어간다.1
쉽게 말해 똑똑한 비서에 그치지 않고, 직접 키보드와 도구를 다루며 끝까지 일을 끌고 가는 실행형 동료에 가까워졌다는 뜻이다.
가장 강한 분야: 에이전트형 코딩
GPT-5.5는 코드를 "잘 쓰는 것"을 넘어, 긴 작업 흐름을 유지하며 실제 개발 문제를 끝까지 풀도록 강화되었다.
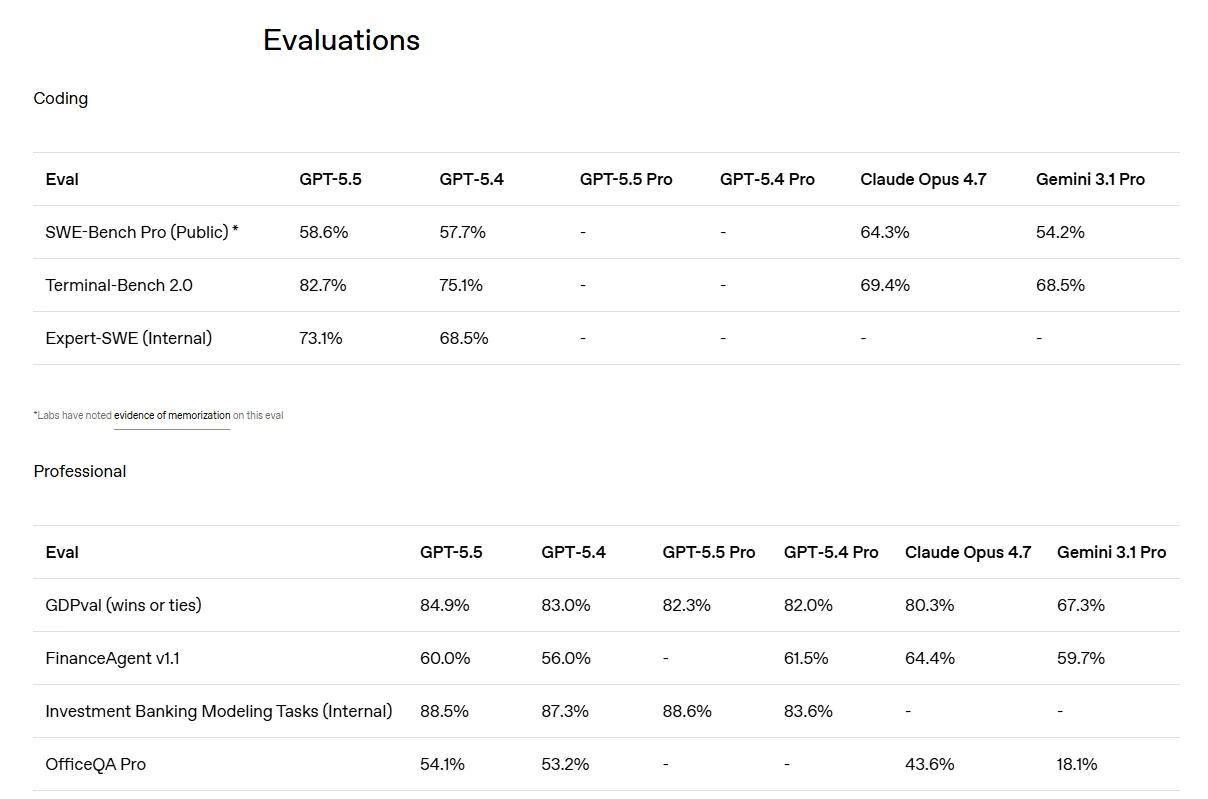
대표적으로 터미널 작업을 평가하는 Terminal-Bench 2.0에서 GPT-5.5는 82.7%를 기록했다. 비교 대상으로 제시된 Opus 4.7은 69.4%, Gemini 3.1 Pro는 68.5%여서, 이는 단순한 근소 우위라기보다 에이전트형 코딩 성능 차이가 분명히 드러난 결과로 볼 수 있다.1
내부 평가인 Expert-SWE도 눈여겨볼 만하다. OpenAI는 이를 사람 전문가 기준 중간값 약 20시간이 걸리는 작업으로 설명하는데, GPT-5.5는 이런 긴 호흡의 문제를 중간에 놓치지 않고 끝까지 끌고 가는 성격을 보여준다. 중요한 점은 단순 정답률만이 아니라, 더 적은 토큰과 더 적은 재시도로 결과를 내고 대규모 코드베이스의 영향 범위까지 고려한다는 데 있다.1
실무에서 보이는 코딩 강점
초기 사용자 평가에 따르면 GPT-5.5는 실패 원인 파악, 수정 위치 결정, 주변 코드에 미칠 영향 예측에서 더 강했다.
예를 들어, 이미 꼬여버린 서비스의 상태를 보고 사람이 했을 법한 구조 재설계를 재현하거나, 큰 브랜치 병합과 리팩터링을 한 번에 처리하는 사례가 소개되었다.
이는 "한 파일 수정기"보다 "시스템 단위로 생각하는 엔지니어"에 가까운 행동으로 볼 수 있다.
지식 노동과 컴퓨터 사용 능력
GPT-5.5의 개선은 코딩 밖에서도 이어진다. 문서 작성, 스프레드시트 생성, 발표 자료 구성, 정보 수집과 정리 같은 일반 사무 작업에서도 더 자연스럽게 전체 흐름을 처리한다.
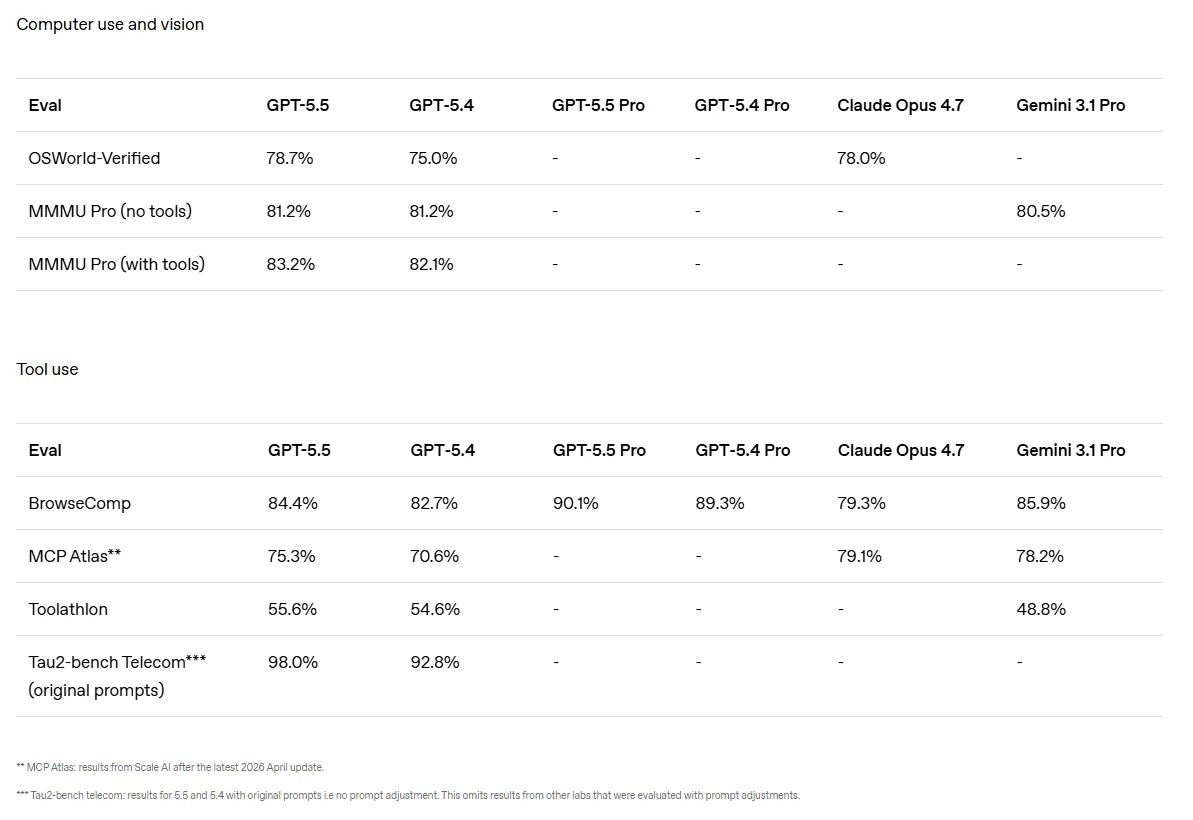
특히 화면을 보고 클릭하고 입력하고 인터페이스를 이동하는 컴퓨터 사용 능력이 강조된다. OSWorld-Verified 78.7%, GDPval 84.9%, Tau2-bench Telecom 98.0% 같은 수치는 이런 실무형 작업 능력을 보여주는 지표다.
즉, 검색만 잘하는 모델이 아니라 자료를 모아 실제 결과물로 바꾸는 쪽으로 진화한 셈이다.
과학 연구 보조 도구로서의 의미
과학 연구에서는 한 번의 정답보다, 가설 탐색·데이터 점검·방법 적용·결과 해석의 반복이 중요하다.
GPT-5.5는 유전학·정량생물학 분석용 GeneBench와 생물정보학 중심 BixBench에서 GPT-5.4보다 향상된 성능을 보였다. 또 내부 버전은 Ramsey 수 관련 수학 정리의 새로운 증명 발견에 기여했고, 이후 Lean으로 검증되었다.
이런 사례는 모델이 단순 설명기가 아니라, 연구 과정 일부를 함께 수행하는 조력자로 바뀌고 있음을 보여준다.
효율성: 더 똑똑하지만 느리지 않다
대형 모델은 보통 더 똑똑할수록 더 느려지고 더 비싸지기 쉽다. GPT-5.5는 이 문제를 줄이는 데도 초점을 맞췄다.
OpenAI는 GPT-5.4와 비슷한 실사용 토큰 지연시간을 유지했다고 설명한다. 동시에 같은 Codex 작업을 처리할 때 출력 토큰을 40%가량 덜 쓰면서 끝내, 효율과 비용 측면을 함께 개선했다고 본다.1
API 가격은 올라갔지만, OpenAI는 토큰 효율이 좋아져 실제 작업당 비용은 비슷하거나 더 낮아질 수 있다고 주장한다. 여기에 더해 GPT-5.5는 실제 운영 트래픽을 분석해 GPU 작업 분배 방식을 개선했고, 그 결과 토큰 생성 속도가 20% 이상 빨라졌다고 한다. 모델이 자기 자신을 서비스하는 기반까지 튜닝한 셈이라는 점이 흥미롭다.1
안전성과 사이버 보안 대응
성능 향상만큼 중요한 축은 안전장치다. OpenAI는 GPT-5.5를 지금까지 가장 강한 보호 조치와 함께 출시했다고 밝혔다.
특히 사이버 보안과 생물·화학 관련 능력을 Preparedness Framework 기준 "High" 수준으로 본다. Critical 단계는 아니지만, GPT-5.4보다 한 단계 올라간 위험성을 인정하고 더 엄격한 분류기와 반복 악용 방지 장치를 추가했다.
방향은 단순 봉쇄가 아니라, 정상적인 방어 목적 사용은 더 쉽게 하고 악의적 사용은 더 어렵게 만드는 "신뢰 기반 접근"에 가깝다.
출시 대상과 가격
출시 시점 기준으로 ChatGPT와 Codex에서 Plus, Pro, Business, Enterprise 중심으로 순차 제공된다. GPT-5.5 Pro는 더 어려운 문제와 더 높은 정확도를 위한 상위 버전으로 Pro 이상에서 제공된다.
Codex에서는 400K 컨텍스트를 지원하고, API는 곧 제공될 예정이며 1M 컨텍스트를 지원한다. API 가격은 gpt-5.5가 입력 100만 토큰당 5달러, 출력 100만 토큰당 30달러다. gpt-5.5-pro는 입력 30달러, 출력 180달러다.
gpt-5.4는 입력 100만 토큰당 $2.50, 출력 100만 토큰당 $15.00 이다. 비용이 2배가 올랐다.
겉보기 가격만 보면 인상처럼 보이지만, 실제 사용에서는 토큰 절감 효과 때문에 체감 비용이 완화될 수 있다는 해석이 가능하다.
벤치마크를 읽는 법
GPT-5.5는 여러 평가에서 GPT-5.4를 대체로 앞선다. 대표적으로 Terminal-Bench 2.0, Expert-SWE, GDPval, OSWorld-Verified, Toolathlon, GeneBench, BixBench, CyberGym, 장문맥 평가 등에서 개선이 보인다.1
다만 모든 항목에서 1등인 것은 아니다. 예를 들어 SWE-Bench Pro에서는 Opus 4.7이 64.3%로 앞섰고 GPT-5.5는 58.6%였다. OpenAI는 일부 문제에서 암기 징후가 보여 해석에 주의가 필요하다고 반론했지만, 이 지점은 여전히 해석이 갈릴 수 있다.1
따라서 이 모델은 "모든 면에서 압도적 1등"이라기보다, 긴 맥락과 여러 도구를 엮는 실무형 복합 작업에서 전반적으로 강해진 모델로 이해하는 편이 더 정확하다.
인사이트
GPT-5.5의 진짜 포인트는 단순한 성능 상승이 아니라, 사람의 의도를 더 빨리 파악하고 여러 단계를 스스로 이어서 처리하는 실행력에 있다.
활용할 때는 짧은 단발성 질문보다 목표·제약·산출물 형태를 한 번에 주는 복합 지시가 더 잘 맞는다. 예를 들어 "자료 조사해서 요약해줘"보다 "자료를 찾아 비교표를 만들고, 리스크를 정리한 뒤 발표 초안까지 써줘" 같은 방식이 더 효과적이다.
또 코딩·연구·보안처럼 강력한 능력이 필요한 영역에서는 결과를 그대로 믿기보다, 검증 루프를 함께 설계하는 것이 가장 현실적인 사용법이다. 결국 이 모델을 잘 쓰려면 모델만 바뀌는 것이 아니라, 지시 스타일도 함께 바뀌어야 한다.
참고
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.