


11장. 데이터를 쉬운 말로 설계하기
데이터 설계는 어려운 기술 용어가 아니다
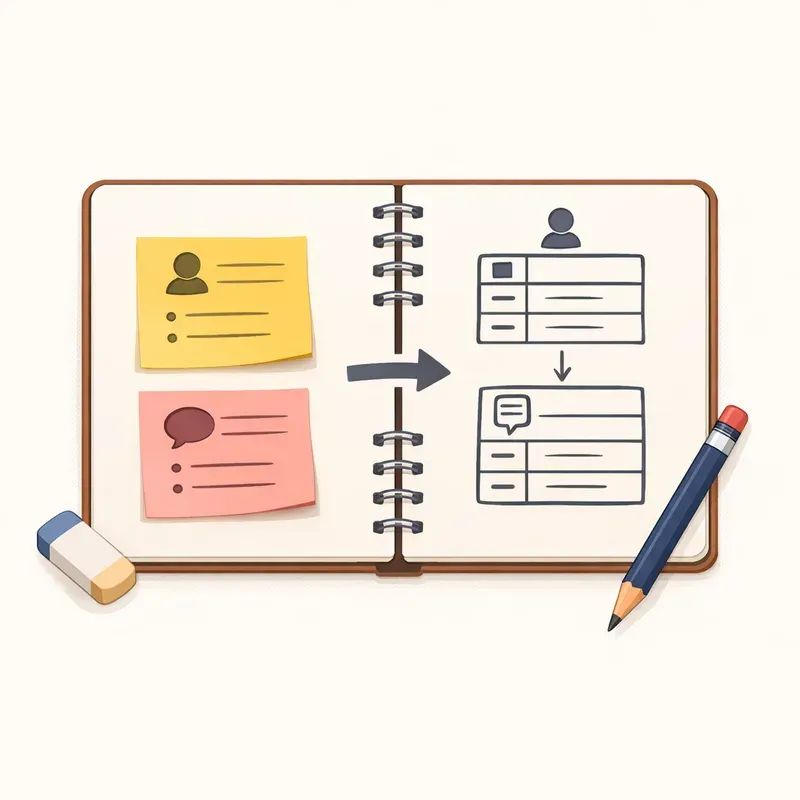
많은 초보자가 "데이터베이스 설계"라는 말을 들으면 갑자기 겁을 먹습니다. 테이블, 스키마, 관계, 모델 같은 단어가 한꺼번에 나오기 때문입니다. 하지만 처음에는 그렇게 거창하게 생각할 필요가 없습니다. 데이터 설계는 아주 단순하게 말해, 우리 서비스가 무엇을 기억해야 하는지 미리 정리하는 일입니다.
예를 들어 우리가 만들 서비스에 회원가입과 글 작성 기능이 있다면, 최소한 이런 정보는 저장해야 합니다. 누가 가입했는지, 어떤 글을 썼는지, 글 제목이 무엇인지, 언제 작성했는지 같은 것들입니다. 이걸 미리 정리해 두면 나중에 화면을 만들 때도 덜 헷갈리고, 백엔드를 붙일 때도 훨씬 수월해집니다.
즉, 기능을 먼저 상상하고 데이터는 나중에 떠올리는 방식보다, 어떤 데이터를 다룰지 먼저 정리하고 기능을 붙이는 방식이 초보자에게 훨씬 안전합니다.
데이터는 "화면"이 아니라 "기억할 정보"로 본다
초보자는 종종 화면 기준으로 생각합니다. "회원가입 화면이 있으니 이름 칸, 이메일 칸, 비밀번호 칸이 있다"처럼 말입니다. 이 접근도 나쁘지는 않지만, 데이터 설계는 화면보다 한 걸음 더 안쪽으로 들어가야 합니다.
중요한 질문은 이것입니다.
"이 서비스는 무엇을 나중에도 기억해야 하는가?"
회원가입 화면에서 입력한 이름은 가입 순간만 필요한 것이 아니라, 이후에도 사용자 정보를 보여주기 위해 계속 필요합니다. 글 작성 화면의 제목과 본문도 마찬가지입니다. 저장된 뒤에 목록 화면, 상세 화면, 수정 화면에서 다시 불러와야 합니다.
그래서 데이터 설계는 화면 설계와 닮아 있으면서도 다릅니다. 화면은 사용자가 보는 것이고, 데이터는 서비스가 기억하는 것입니다.
가장 먼저 정할 것은 핵심 데이터 두세 가지다
처음부터 모든 데이터를 설계하려고 하면 머리가 복잡해집니다. 입문 단계에서는 핵심 데이터부터 잡는 것이 좋습니다. 이번 책에서 만드는 서비스라면 가장 먼저 떠올릴 핵심 데이터는 보통 다음 두 가지입니다.
사용자
게시글
이 둘만 명확해도 회원가입, 로그인, 글 작성, 목록, 상세, 수정, 삭제 같은 핵심 기능의 뼈대가 거의 완성됩니다. 여기에 검색 기능을 붙이려면 게시글의 제목이나 본문이 필요하고, 작성자를 구분하려면 사용자와 게시글의 연결이 필요합니다.
즉, 이번 장의 목표는 대단한 데이터 구조를 만드는 것이 아니라, 서비스를 움직이게 하는 가장 중요한 정보 묶음을 정리하는 것입니다.
문장으로 먼저 써보자
표를 만들기 전에, 먼저 아주 쉬운 한국어 문장으로 데이터를 설명해보면 좋습니다. 이 과정이 의외로 강력합니다. 복잡한 구조를 외우는 대신, 서비스의 상식을 먼저 세우게 되기 때문입니다.
예를 들면 이렇게 쓸 수 있습니다.
사용자는 이메일과 비밀번호로 가입할 수 있다. 사용자마다 닉네임이 있다. 사용자는 여러 개의 게시글을 작성할 수 있다. 게시글에는 제목과 내용이 있다. 각 게시글은 한 명의 작성자에게 속한다. 게시글은 작성 시간과 수정 시간을 가지고 있다.
이 정도만 써도 벌써 중요한 규칙이 보입니다. 사용자와 게시글은 따로 존재하고, 둘은 연결되어 있으며, 게시글 하나에는 작성자가 반드시 있어야 한다는 점입니다.
데이터 설계는 표로 시작해도 되지만, 초보자에게는 문장으로 먼저 상식 만들기가 더 쉽습니다.
사용자 데이터를 표로 정리하기
이제 문장을 표로 옮겨보겠습니다. 먼저 사용자 데이터입니다.
| 항목 이름 | 쉬운 설명 | 왜 필요한가 | 예시 |
|---|---|---|---|
| id | 사용자를 구분하는 고유 번호 | 같은 이름이 있어도 사람을 구분하려고 | user_001 |
| 로그인에 쓰는 이메일 | 사용자 식별과 로그인에 필요 | [email protected] | |
| password | 로그인 비밀번호 | 본인 확인에 필요 | 사용자가 입력한 비밀번호 |
| nickname | 서비스에서 보여줄 이름 | 글 작성자 표시, 프로필 표시에 필요 | 민지 |
| createdAt | 가입한 시간 | 가입 순서 확인, 운영 관리에 필요 | 2026-04-23 10:30 |
여기서 중요한 포인트가 있습니다. 사용자는 화면에서 "이름"이라고 보더라도, 실제 데이터에서는 nickname처럼 조금 더 명확한 이름을 붙일 수 있습니다. 나중에 AI에게 작업을 맡길 때도 이런 이름이 분명할수록 덜 헷갈립니다.
또 하나 기억할 점은, 처음부터 너무 많은 항목을 넣지 않는 것입니다. 프로필 이미지, 자기소개, 전화번호, 주소까지 한꺼번에 넣고 싶어질 수 있습니다. 하지만 지금 만드는 첫 서비스에는 꼭 필요하지 않을 수 있습니다. 처음엔 최소한으로 시작하고, 나중에 늘리는 편이 좋습니다.
게시글 데이터를 표로 정리하기
이제 게시글 데이터를 보겠습니다.
| 항목 이름 | 쉬운 설명 | 왜 필요한가 | 예시 |
|---|---|---|---|
| id | 게시글을 구분하는 고유 번호 | 상세 페이지, 수정, 삭제에 필요 | post_001 |
| title | 글 제목 | 목록과 상세 화면에 필요 | 오늘 만든 첫 서비스 |
| content | 글 본문 | 상세 내용 표시와 수정에 필요 | AI와 함께 웹 서비스를 만들었다. |
| authorId | 작성한 사용자 id | 누가 쓴 글인지 연결하려고 | user_001 |
| createdAt | 처음 작성한 시간 | 최신순 정렬, 기록 확인에 필요 | 2026-04-23 11:00 |
| updatedAt | 마지막 수정 시간 | 수정 여부 표시, 최신 상태 유지에 필요 | 2026-04-23 11:20 |
이 표에서 가장 중요한 칸은 authorId입니다. 이 값 덕분에 게시글과 사용자가 연결됩니다. 쉽게 말해, 게시글 카드 뒤에 작은 메모가 하나 붙어 있는 셈입니다. "이 글은 user_001이 쓴 글이야"라고 알려주는 메모입니다.
이 연결이 없으면 글은 저장할 수 있어도, 누가 작성했는지 알 수 없습니다. 그러면 "내 글만 수정하기" 같은 기능을 만들기 어려워집니다.
데이터 사이의 관계를 이해하면 서비스 구조가 보인다
이제 관계를 아주 쉬운 말로 정리해보겠습니다.
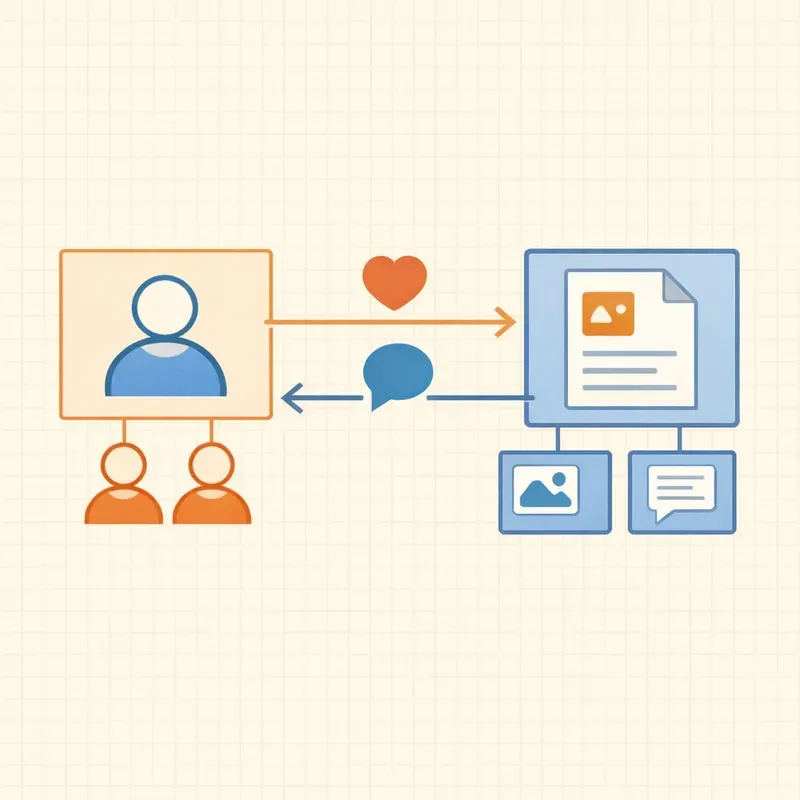
한 명의 사용자는 여러 개의 게시글을 쓸 수 있습니다. 하지만 게시글 하나의 작성자는 한 명입니다. 이것이 우리가 만들 서비스의 가장 기본적인 관계입니다.
이걸 그림처럼 표현하면 이렇게 이해하면 됩니다.
사용자 1명 → 게시글 여러 개
이 관계를 머릿속에 넣고 있으면 나중에 기능을 만들 때 훨씬 수월합니다. 예를 들어 "마이페이지에서 내가 쓴 글 보기"는 결국 authorId가 내 사용자 id와 같은 게시글만 찾아오면 됩니다. "남의 글은 수정하지 못하게 하기"도 현재 로그인한 사용자와 게시글의 작성자를 비교하면 됩니다.
즉, 데이터 관계를 먼저 이해하면, 기능이 따로따로 흩어져 보이지 않고 하나의 구조로 이어집니다.
꼭 저장할 정보와 굳이 저장하지 않을 정보를 구분하자
초보자가 자주 하는 실수는 보여주는 정보와 저장해야 하는 정보를 구분하지 못하는 것입니다. 예를 들어 "게시글 목록에서 작성 시각을 '3분 전'이라고 보여주고 싶다"는 요구가 있을 수 있습니다. 하지만 데이터베이스에 꼭 "3분 전"이라는 문장을 저장할 필요는 없습니다.
실제로 저장할 값은 createdAt 같은 원래 시간이고, 화면에서 그것을 계산해 "3분 전"처럼 바꿔 보여주면 됩니다.
이 차이를 이해하면 데이터가 깔끔해집니다.
저장해야 하는 것은 원본 정보입니다. 화면에서 잠깐 만들어 보여줄 수 있는 표현은 굳이 저장하지 않아도 됩니다. 예를 들어 게시글 글자 수, 최신순 번호, 작성 후 경과 시간 같은 것은 나중에 계산해서 만들 수 있습니다.
입력값 규칙까지 정하면 더 탄탄해진다
데이터 설계는 항목 이름만 정하는 것으로 끝나지 않습니다. 각 항목에 어떤 규칙이 필요한지도 생각해보면 훨씬 좋아집니다.
예를 들어 이런 규칙을 붙일 수 있습니다.
이메일은 비어 있으면 안 된다.
이메일은 사용자마다 달라야 한다.
닉네임은 너무 짧지 않게 정한다.
게시글 제목은 비어 있으면 안 된다.
게시글 본문은 최소 몇 글자 이상이어야 한다.
이런 규칙은 사용자가 이상한 값을 넣지 못하게 막아주는 장치입니다. 지금은 단순한 메모처럼 적어도 충분합니다. 나중에 실제 구현 단계에서 이 규칙들이 폼 검증, 서버 검증, 데이터베이스 제약 조건으로 연결됩니다.
즉, 지금 적어두는 한 줄 메모가 나중에는 서비스 품질을 지키는 기준이 됩니다.
처음 서비스에서는 욕심보다 단순함이 이긴다
처음 만드는 서비스일수록 "나중에 필요할지도 모르는 것"을 많이 넣고 싶어집니다. 예를 들면 게시글 좋아요, 태그, 이미지 여러 장, 임시 저장, 공개 범위, 신고 기능까지 한꺼번에 떠오를 수 있습니다.
하지만 첫 풀스택 서비스의 목표는 모든 기능을 넣는 것이 아닙니다. 끝까지 완성하는 것입니다.
그래서 데이터도 이렇게 나누어 생각하면 좋습니다.
지금 꼭 필요한 것과 나중에 추가해도 되는 것을 구분하는 것입니다. 회원가입, 로그인, 글 작성과 수정, 목록과 상세, 검색 정도만 제대로 돌아가도 이미 훌륭한 서비스입니다. 데이터 설계 역시 그 범위에 맞춰 단순하게 가져가는 편이 좋습니다.
우리 서비스의 1차 데이터 모델 초안
지금까지 정리한 내용을 바탕으로, 이번 책의 실습 서비스에 맞는 1차 데이터 모델 초안을 문장으로 다시 적어보겠습니다.
사용자는 이메일, 비밀번호, 닉네임을 가진다. 사용자는 여러 개의 게시글을 작성할 수 있다. 게시글은 제목, 본문, 작성자, 작성 시간, 수정 시간을 가진다. 게시글은 반드시 한 명의 사용자에게 연결된다. 검색 기능은 게시글의 제목과 본문을 기준으로 동작한다.
이 정도면 아주 훌륭한 출발선입니다. 아직 데이터베이스를 만들지도 않았고, 코드를 쓰지도 않았지만, 이미 서비스의 중심 구조가 잡힌 상태입니다.
AI와 협업할 때 데이터 표가 강력한 이유
앞으로 Claude Code나 Codex 같은 도구와 함께 작업할 때, 이런 데이터 표는 매우 강력한 기준이 됩니다. 막연하게 "게시판 만들어줘"라고 말하는 것보다, "users와 posts가 있고, posts는 authorId로 users와 연결되며, 제목과 본문과 작성 시간이 필요하다"라고 말하면 훨씬 정확한 결과를 얻을 수 있습니다.
AI는 빠르게 초안을 만들 수 있지만, 무엇을 만들어야 하는지 기준이 모호하면 엉뚱한 구조를 제안하기도 합니다. 반대로 데이터가 분명하면 AI의 속도와 사람의 판단이 잘 결합됩니다.
즉, 데이터 설계는 데이터베이스를 위한 준비이기도 하지만, 동시에 AI에게 흔들리지 않는 기준을 주는 작업이기도 합니다.
이 장에서 꼭 가져가야 할 감각
이번 장의 핵심은 복잡한 이론이 아닙니다. 서비스가 기억해야 할 정보를 먼저 정리하면, 이후의 화면 만들기와 서버 만들기와 데이터베이스 만들기가 모두 쉬워진다는 감각입니다.
데이터 설계는 멋진 기술이 아니라, 서비스의 메모장을 먼저 만드는 일입니다. 누가 있는지, 무엇을 썼는지, 둘이 어떻게 연결되는지만 분명해도 절반은 이미 성공입니다.
다음 장에서는 이 구조를 바탕으로, AI가 더 잘 이해하고 더 정확하게 작업할 수 있도록 요구사항을 어떻게 써야 하는지 살펴보겠습니다. 결국 좋은 서비스는 좋은 코드 이전에, 좋은 정리에서 시작합니다.
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.