


4부 18장. 에이전트 실행 루프 구현
좋은 에이전트를 만드는 비밀이 멋진 프롬프트 한 장에 있다고 믿기 쉽다. 하지만 실제로 시스템을 만들어 보면 금방 알게 된다. 프롬프트는 출발점일 뿐이고, 에이전트를 진짜 에이전트답게 만드는 것은 반복 가능한 실행 루프다.
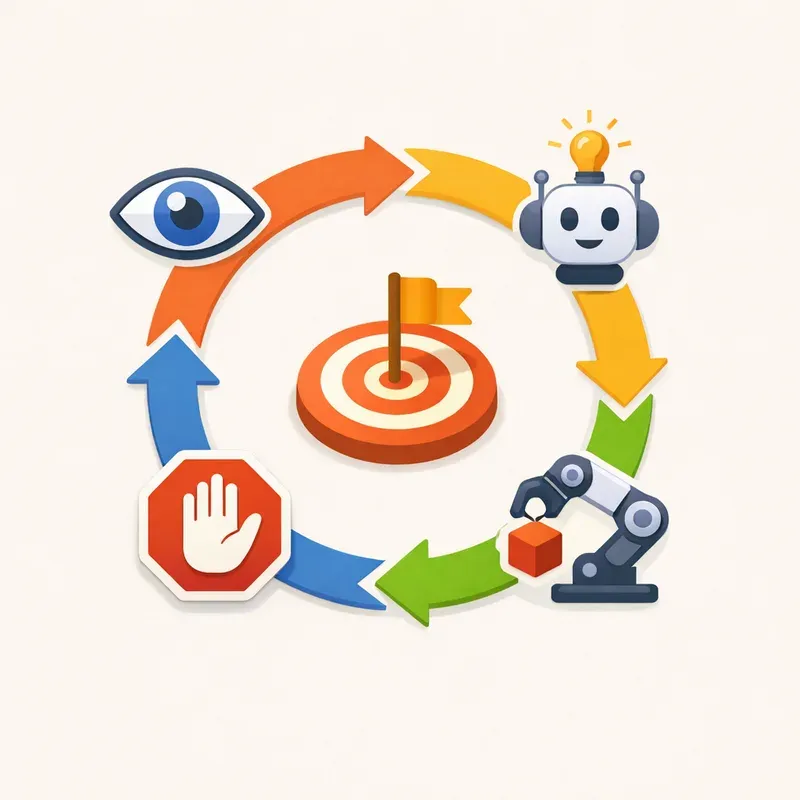
사용자 요청을 한 번 읽고 한 번 답하면 그것은 대화형 모델에 가깝다. 요청을 읽고, 현재 상태를 보고, 다음 행동을 고르고, 도구를 실행하고, 결과를 반영하고, 끝났는지 확인한 뒤 다시 한 바퀴 더 돌 수 있어야 비로소 에이전트가 된다. 이 반복 구조가 있어야 시스템은 목표를 향해 조금씩 전진한다.
이번 장에서는 바로 그 심장을 구현해 본다. Observe-Think-Act, 또는 ReAct 계열 루프를 코드 수준에서 어떻게 나누어 짜는지, 어디서 멈추게 해야 하는지, 어떤 안전장치를 둬야 끝없는 미로에 빠지지 않는지 차근차근 살펴보자.
프롬프트보다 루프가 중요한 이유
에이전트를 처음 만들면 대개 이런 기대를 한다. 시스템 프롬프트를 아주 잘 쓰면 모델이 알아서 필요한 검색도 하고, 적절한 도구도 고르고, 적당한 순간에 멈출 것이라고 말이다. 그러나 현실은 그보다 훨씬 투박하다.
모델은 매 순간 꽤 그럴듯한 다음 행동을 제안할 수 있다. 하지만 그 제안을 언제 다시 물을지, 도구 결과를 어떤 형식으로 되먹일지, 몇 번까지 시도할지, 어떤 상황에서 사람에게 넘길지는 프롬프트가 아니라 루프가 결정한다.
이 감각이 중요하다. 프롬프트는 배우의 대사집이고, 실행 루프는 무대 진행표다. 대사만 있어서는 공연이 굴러가지 않는다. 언제 입장하고, 누가 신호를 주고, 조명이 꺼지면 어디서 멈출지가 있어야 장면이 완성된다.
실행 루프를 한 바퀴로 쪼개 보기
대부분의 에이전트 루프는 이름은 달라도 비슷한 구조를 가진다.
Observe: 현재 상태와 외부 결과를 읽는다.
Think: 다음 행동을 정한다.
Act: 도구를 호출하거나 사용자에게 묻거나 종료한다.
Update: 결과를 상태에 반영한다.
이 네 단계가 한 바퀴다. 중요한 점은 Think가 중심처럼 보여도, 실제 안정성은 Observe와 Update에서 많이 갈린다는 것이다. 상태를 엉성하게 읽거나 결과를 대충 반영하면, 모델이 아무리 똑똑해도 다음 바퀴에서 길을 잃는다.
그래서 좋은 루프는 모델 호출 한 번보다, 모델 호출 전후의 상태 관리가 더 중요하다.
가장 작은 실행 루프부터 시작하자
가장 단순한 형태의 에이전트는 세 가지를 반복한다. 현재 상태를 모델에 보여 준다. 모델이 다음 행동을 고른다. 그 행동을 실행한 뒤 상태를 갱신한다. 이 정도만 있어도 이미 챗봇을 넘어서기 시작한다.
먼저 최소한의 상태 구조를 잡아 보자.
from dataclasses import dataclass, field
from typing import Any, Optional

@dataclass
class ToolCall:
    name: str
    args: dict

@dataclass
class AgentDecision:
    kind: str  # 'tool', 'respond', 'ask_user', 'fail'
    tool_call: Optional[ToolCall] = None
    message: Optional[str] = None
    reason: Optional[str] = None

@dataclass
class StepRecord:
    step: int
    observation: str
    decision: str
    result: str

@dataclass
class AgentState:
    user_request: str
    scratchpad: list[str] = field(default_factory=list)
    tool_results: list[dict] = field(default_factory=list)
    step_records: list[StepRecord] = field(default_factory=list)
    status: str = 'running'  # 'running', 'waiting_user', 'completed', 'failed'
    step_count: int = 0
    max_steps: int = 8
    last_tool_signature: Optional[str] = None
이 구조는 일부러 소박하다. 거대한 프레임워크를 떠올릴 필요가 없다. 지금 필요한 것은 현재 요청, 중간 메모, 도구 결과, 진행 상태, 반복 횟수 정도다.
에이전트 구현에서 자주 생기는 실수는 처음부터 너무 많은 필드를 넣는 것이다. 하지만 루프를 이해하려면 오히려 적게 들고 시작하는 편이 좋다. 최소 구조가 안정적으로 돌고 나서야 복잡한 필드를 붙여도 늦지 않다.
ReAct 루프의 기본 뼈대
이제 전체 루프를 의사코드로 보면 구조가 한눈에 들어온다.
def run_agent(state: AgentState, tools: dict):
    while state.status == 'running':
        if should_stop(state):
            finalize_with_stop_reason(state)
            break

        observation = build_observation(state)
        decision = think(observation)

        if decision.kind == 'respond':
            state.status = 'completed'
            return decision.message

        if decision.kind == 'ask_user':
            state.status = 'waiting_user'
            return decision.message

        if decision.kind == 'fail':
            state.status = 'failed'
            return decision.message

        if decision.kind == 'tool':
            result = execute_tool(decision.tool_call, tools)
            update_state(state, observation, decision, result)
            continue

    return render_fallback_message(state)
이 코드에서 가장 중요한 줄은 모델 호출이 아니다. should_stop(state)다. 많은 초보 구현이 이 검사를 뒤쪽에 두거나 아예 빼먹는다. 그러면 시스템은 이미 충분한 답을 얻고도 한 번 더 검색하고, 이미 세 번 실패한 도구를 또 호출하고, 이미 사용자 확인이 필요한데도 혼자 계속 달린다.
루프는 오래 도는 것이 중요한 것이 아니라, 멈출 타이밍을 알고 도는 것이 중요하다.
Observe 단계: 모델에게 세상을 어떻게 보여 줄 것인가
Observe는 단순히 대화 이력을 통째로 넣는 단계가 아니다. 모델이 지금 판단하는 데 필요한 장면만 골라 보여 주는 단계다.
예를 들어 현재 바퀴에서 모델에게 필요한 것은 대개 이런 정보다.
사용자의 현재 목표
지금까지 확인된 사실
방금 전 도구 결과 요약
아직 비어 있는 정보
남은 예산이나 반복 가능 횟수
금지된 행동이나 승인 필요 조건
이 정보를 잘 모아 주면 모델은 훨씬 짧은 입력으로도 안정적으로 판단한다. 반대로 도구 원문 로그를 길게 쌓아 넣으면 모델은 필요한 사실보다 잡음에 더 많이 흔들린다.
간단한 관찰 정보 생성 함수는 다음처럼 만들 수 있다.
def build_observation(state: AgentState) -> str:
    recent_results = state.tool_results[-3:]
    facts = 'n'.join(state.scratchpad[-5:])

    return f'''\
현재 요청:
{state.user_request}

현재 단계 수:
{state.step_count}/{state.max_steps}

확정된 사실:
{facts if facts else '아직 없음'}

최근 도구 결과:
{recent_results if recent_results else '없음'}

가능한 행동:
- tool: 도구 호출
- respond: 최종 응답
- ask_user: 추가 정보 요청
- fail: 실패 처리
'''
Observe 단계의 핵심은 풍부함이 아니라 선별이다. 모델은 모든 것을 읽을 수 있을지 몰라도, 모든 것을 읽는다고 항상 잘 판단하지는 않는다.
Think 단계: 모델은 자유 서술보다 구조화된 결정을 내려야 한다
루프 구현에서 가장 흔한 함정은 모델에게 긴 자유 서술을 시키고, 그 문장에서 도구 호출 의도를 다시 파싱하는 것이다. 이 방식은 데모에서는 그럴듯하지만 운영에서는 쉽게 깨진다.
실전에서는 모델이 다음 행동을 구조화된 형식으로 내도록 만드는 편이 훨씬 안전하다. 예를 들어 다음 네 가지 중 하나만 고르게 하는 식이다.
toolrespondask_userfail
여기에 필요한 필드만 붙이면 된다.
def think(observation: str) -> AgentDecision:
    raw = call_model_with_schema(
        prompt=observation,
        schema={
            'kind': 'tool|respond|ask_user|fail',
            'message': 'string|null',
            'tool_name': 'string|null',
            'tool_args': 'object|null',
            'reason': 'string|null'
        }
    )

    if raw['kind'] == 'tool':
        return AgentDecision(
            kind='tool',
            tool_call=ToolCall(name=raw['tool_name'], args=raw['tool_args']),
            reason=raw.get('reason')
        )

    return AgentDecision(
        kind=raw['kind'],
        message=raw.get('message'),
        reason=raw.get('reason')
    )
이렇게 하면 모델이 할 일은 문학 작품 쓰기가 아니라 다음 행동 고르기가 된다. 즉, 추론은 모델에게 맡기되 제어 형식은 시스템이 쥔다.
Act 단계: 도구 실행은 모델의 상상이 아니라 시스템의 책임이다
모델이 search_orders를 호출하겠다고 말했다고 해서 바로 실행하면 안 된다. 그 사이에 시스템이 해야 할 일이 꽤 많다. 도구가 실제로 존재하는지, 인자가 올바른지, 권한이 맞는지, 이미 같은 요청을 방금 실행하지 않았는지 검사해야 한다.
도구 실행기는 보통 다음 순서로 짜면 깔끔하다.
def execute_tool(tool_call: ToolCall, tools: dict) -> dict:
    if tool_call.name not in tools:
        return {'ok': False, 'error': 'unknown_tool'}

    validation_error = validate_args(tool_call.name, tool_call.args)
    if validation_error:
        return {'ok': False, 'error': f'invalid_args: {validation_error}'}

    try:
        data = tools[tool_call.name](**tool_call.args)
        return {'ok': True, 'data': data}
    except TimeoutError:
        return {'ok': False, 'error': 'timeout'}
    except Exception as e:
        return {'ok': False, 'error': f'tool_exception: {str(e)}'}
여기서 중요한 것은 도구 결과 형식을 통일하는 일이다. 어떤 도구는 문자열을 주고, 어떤 도구는 리스트를 주고, 어떤 도구는 예외를 던지는 식이면 다음 단계가 지저분해진다. 성공과 실패를 같은 껍데기로 감싸서 반환하면 루프가 훨씬 단순해진다.
Update 단계: 루프의 품질은 상태 갱신에서 갈린다
많은 사람이 실행 루프를 설명할 때 Think와 Act만 본다. 하지만 실무에서는 Update가 가장 중요할 때가 많다. 왜냐하면 다음 바퀴의 판단 재료가 바로 여기서 만들어지기 때문이다.
상태 갱신에서는 최소한 세 가지를 해 줘야 한다.
무엇을 관찰했고 어떤 결정을 내렸는지 기록한다.
도구 결과에서 확정된 사실만 추려 스크래치패드에 반영한다.
실패 횟수, 반복 패턴, 다음 제약 조건을 갱신한다.
예를 들어 다음처럼 구현할 수 있다.
def update_state(state: AgentState, observation: str, decision: AgentDecision, result: dict):
    state.step_count += 1

    state.step_records.append(
        StepRecord(
            step=state.step_count,
            observation=observation,
            decision=str(decision),
            result=str(result)
        )
    )

    if decision.tool_call:
        signature = f"{decision.tool_call.name}:{decision.tool_call.args}"
        state.last_tool_signature = signature

    state.tool_results.append(result)

    if result.get('ok'):
        summary = summarize_tool_result(result['data'])
        state.scratchpad.append(summary)
    else:
        state.scratchpad.append(f"도구 실패: {result['error']}")
여기서 summarize_tool_result가 은근히 중요하다. 도구 결과 원문을 통째로 계속 쌓으면 컨텍스트는 금세 무거워진다. 반대로 결과를 너무 짧게 줄이면 중요한 근거가 사라진다. 그래서 원문은 저장소에 두고, 루프에는 요약만 올리는 방식이 실용적이다.
종료 조건은 루프의 브레이크다
실행 루프에서 종료 조건은 선택 사항이 아니다. 없으면 언젠가 반드시 사고가 난다. 좋은 에이전트는 많이 움직이는 에이전트가 아니라, 적절한 순간에 멈출 줄 아는 에이전트다.
가장 기본적인 종료 조건은 다음과 같다.
충분한 답을 만들 수 있으면 종료한다.
추가 정보가 꼭 필요하면 사용자에게 묻고 멈춘다.
최대 반복 횟수에 도달하면 멈춘다.
같은 실패가 반복되면 멈춘다.
예산이나 시간 한도를 넘기면 멈춘다.
사람 승인이 필요한 단계에 오면 멈춘다.
이를 코드로 옮기면 대략 이런 모양이 된다.
def should_stop(state: AgentState) -> bool:
    if state.step_count >= state.max_steps:
        state.status = 'failed'
        state.scratchpad.append('최대 반복 횟수 초과')
        return True

    recent_failures = [r for r in state.tool_results[-3:] if not r.get('ok', False)]
    if len(recent_failures) >= 3:
        state.status = 'failed'
        state.scratchpad.append('연속 도구 실패')
        return True

    if detect_looping(state):
        state.status = 'failed'
        state.scratchpad.append('반복 패턴 감지')
        return True

    return False
초보 구현에서 자주 빠지는 함정은 종료 조건을 오직 max_steps 하나만 두는 것이다. 물론 없는 것보다는 낫다. 하지만 그것만으로는 부족하다. 같은 도구를 인자만 조금 바꿔 계속 부르거나, 이미 필요한 자료가 없다는 사실을 확인했는데도 다른 표현으로 같은 시도를 반복할 수 있기 때문이다.
반복 감지는 생각보다 중요하다
에이전트가 망가지는 가장 전형적인 장면은 같은 행동을 약간씩 바꿔 계속 반복하는 경우다. 검색어를 한 단어만 바꿔 세 번 검색하거나, 실패한 파일 경로를 비슷하게 다시 읽거나, 없는 정보를 끝까지 찾아다니는 식이다.
그래서 종료 조건에는 단순 횟수 제한 외에 반복 패턴 감지가 들어가는 편이 좋다.
def detect_looping(state: AgentState) -> bool:
    if len(state.step_records) < 3:
        return False

    last_three = state.step_records[-3:]
    decisions = [record.decision for record in last_three]

    return len(set(decisions)) == 1
실전에서는 이것보다 조금 더 똑똑하게 만든다. 같은 도구 이름과 거의 같은 인자가 반복되는지, 실패 원인이 계속 같은지, 새로 얻은 정보가 없는 채로 바퀴만 도는지 본다. 핵심은 루프가 앞으로 가고 있는지, 제자리걸음 중인지 구분하는 것이다.
사람도 문제를 풀다가 같은 페이지를 세 번 읽으면 잠깐 멈추고 방향을 바꾼다. 에이전트도 마찬가지다.
사용자 대기가 필요한 순간을 종료로 취급하라
에이전트를 구현할 때 흔히 놓치는 점이 하나 있다. 완료만 종료가 아니라는 사실이다. 실전에서는 사용자 응답 대기도 아주 중요한 종료 상태다.
예를 들어 배송지를 바꿀지, 실제 메일을 보낼지, 결제를 진행할지 같은 질문은 시스템이 혼자 결정하면 안 된다. 이때 루프는 실패한 것이 아니라 올바르게 멈춘 것이다.
그래서 종료 상태는 보통 하나가 아니라 여러 개다.
completedwaiting_userwaiting_approvalfailedcancelled
이 구분이 있어야 나중에 재개도 쉬워진다. waiting_user였다면 사용자가 답을 보내는 순간 그 상태에서 다시 한 바퀴 이어서 돌리면 된다. 루프는 항상 끝장나는 구조일 필요가 없다. 잠깐 멈췄다가 다시 시작할 수 있는 구조여야 한다.
한 번에 끝내려 하지 말고 일시정지와 재개를 설계하라
Observe-Think-Act 루프를 떠올리면 많은 사람이 while True부터 쓴다. 물론 작은 실험에서는 괜찮다. 하지만 실제 서비스에서는 한 요청 안에서 끝나지 않는 일이 많다. 사용자 확인을 기다릴 수도 있고, 외부 작업이 오래 걸릴 수도 있고, 승인 절차가 끼어들 수도 있다.
그래서 루프는 종종 이런 식으로 나뉜다.
현재 상태를 읽는다.
다음 행동을 결정한다.
즉시 실행 가능한 행동이면 실행한다.
외부 응답이나 사람 입력이 필요하면 현재 상태를 저장하고 반환한다.
나중에 이벤트가 오면 저장된 상태에서 다시 시작한다.
즉, 좋은 실행 루프는 꼭 길게 도는 루프가 아니다. 짧은 사이클을 여러 번 재개할 수 있는 루프일 때 오히려 운영하기 쉽다.
실전 예시로 보는 세 번의 루프
사용자가 이렇게 요청했다고 해 보자.
지난주 고객 불만 리뷰를 분석해서 가장 큰 원인 세 가지를 요약해 줘.
첫 번째 바퀴에서 에이전트는 아직 데이터가 없다는 사실을 관찰한다. Think 단계에서는 리뷰 데이터를 조회해야 한다고 판단한다. Act 단계에서 fetch_reviews 도구를 호출한다. Update 단계에서는 리뷰 1,200건을 불러왔고, 배송 지연 관련 표현이 많다는 사실을 요약해 넣는다.
두 번째 바퀴에서는 이미 리뷰 데이터가 있으니, 이번에는 분류 또는 집계가 필요하다고 판단한다. cluster_complaints 같은 도구를 호출해 원인별 묶음을 만든다. 결과로 배송 지연, 환불 처리 지연, 상품 설명 불일치가 상위 세 원인으로 나온다. 상태에는 비율과 대표 사례가 요약된다.
세 번째 바퀴에서는 추가 도구 호출이 꼭 필요하지 않다고 판단할 수 있다. 이미 근거와 상위 원인이 확보되었기 때문이다. 이제 respond를 선택하고, 사용자에게 요약 결과를 반환한 뒤 completed로 종료한다.
이 장면을 보면 중요한 사실이 보인다. 좋은 응답은 마지막 모델 호출 한 번에서 갑자기 생기지 않는다. 앞선 두 바퀴에서 상태를 잘 쌓아 둔 덕분에 마지막 바퀴가 쉬워진다. 결국 응답 품질은 프롬프트 한 줄이 아니라 루프 전체의 산물이다.
루프를 망치는 대표적인 구현 실수
실행 루프는 원리만 보면 단순하지만, 구현에서는 늘 비슷한 문제에 걸린다.
첫째, 모델이 원하는 모든 행동을 그대로 허용하는 경우다. 존재하지 않는 도구를 부르거나, 권한이 없는 쓰기 작업을 시도하거나, 인자가 비어 있는데도 실행해 버린다.
둘째, 상태 갱신이 느슨한 경우다. 도구 실행은 했는데 결과 요약이 없어서 다음 바퀴가 똑같은 시도를 반복한다.
셋째, 종료 조건이 약한 경우다. 최대 반복 횟수도 없고, 실패 누적도 보지 않고, 사용자 확인이 필요한 순간도 자동으로 넘어가려 한다.
넷째, 도구 결과 원문을 그대로 계속 넣는 경우다. 컨텍스트는 배처럼 불러 오르는데 정작 중요한 사실은 묻힌다.
이 네 가지는 아주 흔하고, 아주 치명적이다. 에이전트가 멍청해서가 아니라 구조가 헐거워서 생긴다.
디버깅 가능한 루프는 로그가 아니라 이벤트를 남긴다
운영 단계로 가면 질문은 늘 비슷하다. 왜 이 도구를 불렀지. 왜 여기서 멈추지 않았지. 왜 같은 시도를 두 번 했지. 이때 자유 형식 로그만 잔뜩 남아 있으면 원인을 찾기 어렵다.
그래서 실행 루프에는 보통 이벤트 단위 기록이 필요하다. 예를 들어 step_started, model_decision, tool_called, tool_succeeded, tool_failed, status_changed 같은 식이다. 이렇게 남기면 한 바퀴 한 바퀴가 나중에 재생 가능해진다.
간단한 이벤트 예시는 이렇다.
def record_event(state, event_type, payload):
    state.step_records.append({
        'step': state.step_count,
        'event_type': event_type,
        'payload': payload
    })
이 기록은 다음 장들에서 다룰 오류 복구, 사람 승인, 관측 가능성의 기초가 된다. 실행 루프는 돌아가기만 해서는 부족하다. 왜 그렇게 돌았는지 나중에 설명 가능해야 한다.
좋은 실행 루프는 모델을 믿되, 모델에 맡기지 않는다
이 말은 조금 역설적으로 들릴 수 있다. 하지만 실전 감각은 바로 여기에 있다. 모델은 다음 행동을 고르는 데 매우 유용하다. 그러나 반복 횟수, 도구 권한, 승인 정책, 종료 조건, 예외 처리 같은 운영 규칙까지 모델에게 맡기면 시스템은 급격히 불안정해진다.
정리하면 역할 분담은 이렇다.
모델은 상황을 읽고 다음 행동 후보를 정한다. 시스템은 그 행동이 허용되는지 검사하고, 실행하고, 결과를 저장하고, 계속할지 멈출지 결정한다. 이 선이 분명할수록 루프는 안정적이다.
많은 팀이 처음에는 이 선을 흐리게 잡는다. 그러다 운영 단계에서 문제를 만난 뒤에야 깨닫는다. 에이전트의 핵심은 멋진 추론 문장이 아니라, 반복 가능한 제어 구조였다는 사실을 말이다.
구현할 때 끝까지 붙잡아야 할 질문
실행 루프를 짤 때는 늘 이 질문으로 돌아오면 좋다. 이 시스템은 지금 한 번 답하고 끝나는가, 아니면 관찰하고 판단하고 행동하고 갱신하는가. 그리고 그 반복은 언제 멈추는가.
이 질문에 분명하게 답할 수 있으면 코드 구조도 자연스럽게 따라온다. 상태 객체가 생기고, 한 바퀴의 입력과 출력이 생기고, 도구 실행기가 분리되고, 종료 조건이 독립 함수가 된다. 반대로 이 질문이 흐리면 시스템은 금세 거대한 프롬프트와 임시 조건문 덩어리로 변한다.
에이전트를 만드는 일은 대단한 마법을 부리는 일이 아니다. 작은 루프를 정직하게 설계하는 일에 가깝다. 현재를 읽고, 다음 행동을 고르고, 실제로 실행하고, 결과를 반영하고, 충분하면 멈춘다. 바로 이 반복이 에이전트의 심장이다.
프롬프트는 그 심장이 어떤 말을 할지 도와줄 수 있다. 하지만 심장을 뛰게 만드는 것은 결국 루프다. 그리고 그 사실을 코드로 체감하는 순간, 에이전트는 더 이상 신기한 데모가 아니라 설계 가능한 시스템으로 보이기 시작한다.
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.