


2026년 4월 21일, OpenAI는 소비자용 ChatGPT Images 2.0과 API용 gpt-image-2를 같은 날 공개했다. 모델 카드는 이걸 "state-of-the-art image generation model"이라고 소개한다.
그런데 나는 창업자 관점에서 이 릴리스를 이렇게 읽는다.
이번 업데이트는 "더 예쁜 그림"이 아니다. "재작업 비용이 줄어드는 그림"이다.
그래서 이 글은 모델 스펙 요약이 아니라, 1인 창업자·소규모 팀·컨텐츠 운영자가 지금 뭘 바꿔야 하는지를 기준으로 정리했다. 코드 예시와 표는 끝까지 다 넣었지만, 주제는 "의사결정"이다.
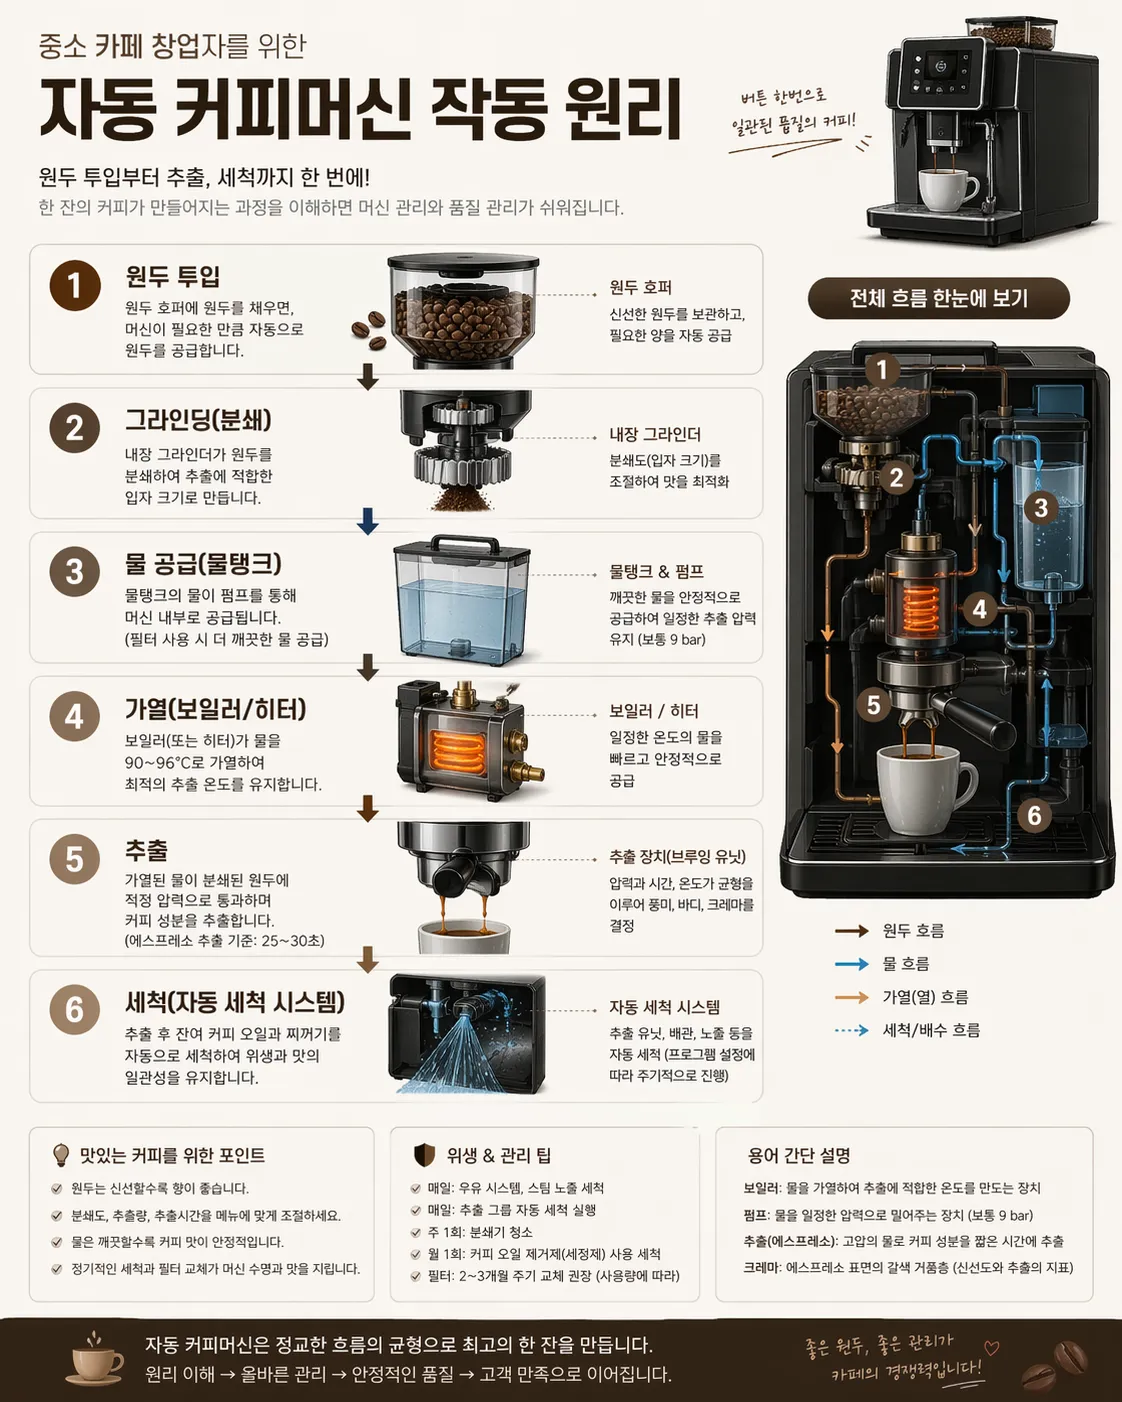
결론부터: 이 릴리스의 핵심은 세 가지다
편집 정밀도가 올라갔다. 포토리얼, 한국어 타이포, 브로슈어·인포그래픽·만화 같은 "실제 제작 결과물"을 뽑아내는 데 유리해졌다.
해상도 제약이 풀렸다. 기존의 고정 프리셋 3종이 아니라, 제약 조건 안에서 임의 해상도를 지정할 수 있다. 배너, 포스터, 브로슈어, 2K 실험 출력이 훨씬 자유롭다.
입력 이미지가 기본적으로 고충실도 처리된다.
input_fidelity파라미터가 사실상 꺼진 상태. 편집 품질은 좋아지지만, 참조 이미지를 많이 쓰는 워크플로는 토큰 비용이 커질 수 있다.
그리고 하나 더 중요한 포인트:
gpt-image-2는 이미지 출력 중심 모델이다."이미지를 한국어로 설명해줘", "이미지 속 글자 추출해줘" 같은 작업은
gpt-image-2단독이 아니라 Responses API의 비전 모델(gpt-5.4등)로 처리하는 게 문서상 정합적이다. 이걸 헷갈리면 과금도, 출력 포맷도 꼬인다.
이름부터 정리하자: 제품과 모델은 다르다
먼저 층위를 분리해야 혼동이 없다.
ChatGPT Images 2.0 = 소비자 제품 이름. 생각 모드, 만화 페이지, 인포그래픽, 한국어 브로슈어 같은 "완성된 제작 경험"을 보여준다.
gpt-image-2= 개발자용 모델 이름. 고품질 생성·편집 엔진.
실무적으로는 제품 경험 = 오케스트레이션 포함, API 모델 = 생성 엔진으로 이해하면 된다. 제품은 이미 여러 단계를 뒤에서 조합해 보여주는 것이고, API는 그 중 "그림 그리는 부분"이다.
버전 계보: 1 → 1.5 → 2, 무엇이 달라졌나
2025-04-23  GPT Image 1 API 공개
2025-12-16  ChatGPT 이미지 신버전 공개 / GPT Image 1.5 스냅샷
2026-04-21  ChatGPT Images 2.0 / GPT Image 2 스냅샷
OpenAI의 공식 프롬프팅 가이드는 이렇게 정리한다.
gpt-image-2: 신규 빌드의 기본 선택지gpt-image-1.5: 마이그레이션 중 기존 검증 워크플로 유지용gpt-image-1: 레거시 호환용
즉, 지금 새로 붙인다면 2를 쓰는 게 문서상 정답이다. 하지만 1.5로 운영 중이라면 즉시 폐기보다 점진 이전이 합리적이다. 이유는 뒤에서 비용 얘기할 때 다시 나온다.
GPT Image 2 vs 1.5 핵심 차이
| 항목 | GPT Image 2 | GPT Image 1.5 | 실무적 의미 |
|---|---|---|---|
| 공식 포지셔닝 | 최신(state-of-the-art) | 이전(previous) | 신규 구축 시 2가 기본값 |
| 출력 모달리티 | 이미지 | 이미지, 텍스트 | 이미지→텍스트 작업은 2 단독보다 비전 모델 분리가 안전 |
| 입력 이미지 처리 | 고충실도 기본, input_fidelity 사실상 비활성 | input_fidelity low/high 지원 | 편집 품질↑, 참조 이미지 토큰 비용↑ |
| 해상도 정책 | 제약 조건 내 임의 해상도 | 1024x1024, 1024x1536, 1536x1024, auto 중심 | 배너·포스터·브로슈어·2K 실험에 유리 |
| 품질-지연시간 | low가 특히 강함 | 저지연 옵션은 있으나 2만큼 강조 안 됨 | 대량 시안·실험엔 2의 low |
| 투명 배경 | 현재 미지원 | 지원 | PNG 투명 배경 워크플로는 별도 후처리 필요 |
포맷, 엔드포인트, 가격: 창업자가 놓치기 쉬운 것들
어떤 API로 써야 하는가
간단히 정리한다.
단일 생성/편집이면 → Images API (
v1/images/generations,v1/images/edits)대화형·반복 편집이면 → Responses API +
image_generationtool이미지 읽고 텍스트로 답하는 작업이면 → 비전 가능한 메인라인 모델(
gpt-5.4등)
여기서 중요한 건, Responses API에서 이미지를 만들 때도 gpt-image-2를 model에 직접 넣지 않는다는 점이다. gpt-5.4 같은 메인라인 모델에 image_generation tool을 붙이는 방식이 공식 패턴이다.
지원 스펙 요약
| 항목 | 상태 | 실무 해석 |
|---|---|---|
| 입력 종류 | 텍스트 프롬프트, 이미지 입력 | 텍스트→이미지, 이미지+텍스트→이미지 모두 가능 |
| Responses API 이미지 입력 | URL, base64 data URL, file ID | 서버 저장 파일과 대화 문맥 결합이 쉽다 |
| 출력 포맷 | 기본 PNG, 선택 JPEG/WEBP, base64 반환 | CDN URL이 아니라 바이너리 저장 파이프라인이 기본 |
| 품질 옵션 | low, medium, high, auto | 초안 low, 최종물 medium/high |
| 해상도 | 최대 변 3840px, 16의 배수, 비율 최대 3:1, 총 픽셀 655,360~8,294,400 | 배너·포스터·2K·4K 실험 가능 |
| 2K 초과 출력 | 실험적 | 2560×1440 초과는 QA 필수 |
| 투명 배경 | 미지원 | 로고·스티커 투명 PNG는 후처리 |
| 마스크 편집 | 가능 | PNG 마스크, 알파 채널, 동일 크기 |
| 다중 이미지 편집 | 가능 | 합성·구성·참조 샷 결합에 적합 |
| 생성 개수 | n 1~10 | 배리에이션 탐색 가능 |
가격: "2가 더 싸다"는 말은 반만 맞다
이게 창업자 입장에서 가장 조심해야 할 부분이다.
토큰 단가 표만 보면 gpt-image-2의 이미지 출력 단가가 1.5보다 약간 낮다. 그런데 대표 예시 단가에서는 low는 더 저렴하고, medium/high는 오히려 더 비싼 경우가 보인다.
| 구분 | 표준 가격 | 배치 가격 |
|---|---|---|
| 이미지 입력 | $8 / 1M tokens | $4 / 1M tokens |
| 캐시된 이미지 입력 | $2 / 1M tokens | $1 / 1M tokens |
| 이미지 출력 | $30 / 1M tokens | $15 / 1M tokens |
| 텍스트 입력 | $5 / 1M tokens | $2.5 / 1M tokens |
| 1024×1024 예시 | Low $0.006 / Medium $0.053 / High $0.211 | — |
| 스트리밍 partial image | +100 output tokens / partial image | 동일 |
결론: 운영 전 반드시 내 프롬프트 분포로 재측정해야 한다. "릴리스 노트에 더 싸다고 적혀 있다" → 이걸 믿고 예산 짜면 틀린다. 나는 스테이징 프로젝트에서 품질별·해상도별 샘플 50~100장을 돌려보고 실제 청구 로그를 확인한 다음 결정하라고 권한다.
문서 불일치, 구현 전에 한 번 체크
공식 문서들 사이에 작은 불일치가 있다. 이걸 모르면 구현 때 당황한다.
| 이슈 | 해석 |
|---|---|
한국어 가격 페이지에 gpt-image-2 텍스트 출력 $10 표기 vs 모델 카드는 이미지 출력 중심 | 모델 카드 기준이 정합적. 실제 청구는 스테이징 로그로 검증 |
모델 카드는 Streaming 미지원 vs 가이드는 stream=true, partial_images 예시 제공 | 텍스트 토큰 스트리밍 ≠ 이미지 partial streaming. 분리해 이해 |
일부 reference snippet은 구세대 모델로 images.edit 예시 | 최신 가이드 우선. gpt-image-2로 images.edit 가능 |
한계와 리스크: 창업자가 실제로 맞닥뜨릴 문제들
이 섹션이 사실 제일 중요하다. 모델이 좋아졌다고 말하는 건 쉽지만, 어디서 터지는가를 아는 게 운영 리스크 관리다.
1. 모델 자체의 한계
생성 시간: 복잡한 경우 최대 2분. UX 설계 시 로딩 처리 필수.
텍스트 정밀 배치: 많이 좋아졌지만, 작은 활자·정확한 좌표 배치·복잡한 UI 텍스트는 여전히 흔들린다.
반복 일관성: 캐릭터·브랜드 요소의 완전한 일관성은 어렵다. 웹툰 4컷, 브랜드 패밀리 자산에서 자주 깨진다.
레이아웃 정밀 제어: 포스터·패키지처럼 한 픽셀 단위 정렬이 중요한 자산은 "생성 + 수작업 마감"을 전제로 설계하는 게 실용적이다.
2. 한국어 이미지 분석의 진짜 한계
이건 별도로 강조해야 한다. OpenAI 비전 가이드는 비라틴 문자, 특히 한국어·일본어 이미지에서 최적 성능이 아닐 수 있다고 직접 경고한다. 작은 텍스트는 확대하거나 detail="original"을 써야 한다.
즉, 생성 쪽의 한글 렌더링이 좋아진 것과 분석 쪽의 한국어 OCR 한계는 별개 문제다. 한국어 영수증·카탈로그·간판 같은 걸 대량 처리하는 서비스라면 이건 그냥 "된다"로 전제하지 말고 실제 샘플로 검증해야 한다.
다른 취약점들:
회전된 글자
색·점선·파선이 섞인 차트
정교한 공간 추론
파노라마/어안 이미지
객체 정확 계수
CAPTCHAs는 안전상 차단
의료 영상 판독 부적합
3. 정책·법률: 초상권과 브랜드
여기서 실수하면 법적 리스크로 직결된다.
OpenAI 이용정책이 금지하는 것:
동의 없는 얼굴 인식 데이터베이스 구축
공공장소 실시간 원격 생체인식
동의 없이 사실적 초상을 사용해 진위 혼란을 일으키는 행위
민감 특성 추론
서비스 약관상 금지:
시각 자료 기능을 사람 식별용으로 사용
명시적 동의와 필요한 권리 없이 타인의 초상 재현
마케팅용 인물 이미지, 실존 인물 스타일 전이, 합성 광고, virtual try-on 같은 건 권리 확보와 동의 문서화가 선행되어야 한다. 이건 "혹시 걸리면"이 아니라 "걸릴 수밖에 없는" 영역이다.
브랜드/저작권 예방 패턴: OpenAI 공식 프롬프팅 예시는 상품 컨셉에 아예 Original design only / No trademarks / No watermarks / No logos를 제약으로 넣는다. 이건 취향이 아니라 권리 충돌을 줄이는 가장 실용적인 패턴이다. 유명 브랜드 룩앤필을 그대로 모사하는 대신, 브랜드 속성은 유지하되 결과물은 오리지널로 요구하는 편이 안전하다.
4. 데이터·투명성: API와 ChatGPT는 다르다
API: OpenAI는 기본적으로 고객 API 데이터를 훈련에 사용하지 않는다.
개인용 ChatGPT: "모두를 위해 모델 개선" 설정이 켜져 있으면 업로드한 파일·대화가 성능 개선에 활용될 수 있다.
Enterprise/Team/Education: 기본적으로 학습에 사용되지 않는다.
또 ChatGPT 이미지에 대해서는 C2PA 메타데이터 관련 도움말이 있다. 공개 배포 이미지의 출처 투명성이 중요한 도메인이라면 C2PA 보존 여부를 검수 항목에 넣자.
실전 프롬프트 라이브러리
바로 쓸 수 있게 정리했다. 생성·편집·인페인팅·스타일 전이는 gpt-image-2, 이미지→텍스트·Q&A·접근성은 비전 모델(gpt-5.4, gpt-4.1-mini 등) 기준이다.
이미지 생성
| ID | 프롬프트 | 설정 |
|---|---|---|
| G1 | 한국의 중소 카페 창업자를 위한 자동 커피머신 작동 원리 인포그래픽을 만들어줘. 원두 투입, 그라인딩, 물탱크, 보일러, 추출, 세척 흐름을 단계별 화살표와 레이블로 보여주고, 기술적이지만 이해하기 쉬운 톤으로 구성해줘. | gpt-image-2, quality=high, size=1024x1536, PNG |
| G2 | 다큐멘터리 사진처럼 자연스러운 해안가 인물 사진을 만들어줘. 거친 피부 질감, 실제 주름, 생활감 있는 의복, 과한 영화적 보정 없이 35mm 필름 느낌, 눈높이 시선, 50mm 렌즈, 부드러운 흐린 낮빛. | gpt-image-2, quality=high, size=1536x1024, JPEG |
| G3 | 서울 근교 한옥 스테이 브랜드 브로슈어 표지 이미지를 만들어줘. 고급스러운 한국어 타이포그래피, 잔잔한 자연광, 전통 목재 질감, 현대적 편집 디자인, 여행·호스피탈리티 광고처럼 완성도 높게. | gpt-image-2, quality=high, size=1024x1536, PNG |
| G4 | 한국어, 일본어, 아랍어, 영어를 함께 사용하는 타이포그래피 포스터를 만들어줘. 굵은 글자 조형, 단정한 여백, 현대 그래픽 디자인 톤, 각 스크립트가 충돌하지 않으면서도 같은 시스템 안에 보이게 해줘. | gpt-image-2, quality=high, size=1024x1536, PNG |
이미지 편집
| ID | 프롬프트 | 설정 |
|---|---|---|
| E1 | 이 인포그래픽의 텍스트만 자연스러운 한국어로 번역해줘. 타이포 스타일, 줄간격, 레이아웃, 아이콘, 색상, 구성은 바꾸지 마. | quality=high, 원본 크기 유지 |
| E2 | 이 사진을 겨울 저녁 분위기로 바꿔줘. 눈발이 약하게 날리고, 차가운 공기감과 노을 직전의 푸른빛만 추가해. 사람, 사물 배치, 카메라 각도는 그대로 유지해. | quality=medium, PNG |
| E3 | 손에 들린 꽃만 제거해줘. 그 외 인물의 얼굴, 손 위치, 옷주름, 배경, 조명은 절대 바꾸지 마. | quality=medium, 구도 유지 강조 |
| E4 | 이 실내 사진에서 흰색 의자만 밝은 원목 의자로 바꿔줘. 카메라 각도, 바닥 그림자, 주변 오브젝트, 실내 조명은 그대로 유지해. | quality=medium, size=1536x1024 |
인페인팅 (마스크 기반)
| ID | 프롬프트 | 설정 |
|---|---|---|
| I1 | 마스크된 수영장 영역 안에만 분홍색 플라밍고 튜브를 자연스럽게 추가해줘. 실내 라운지의 햇빛 방향과 반사광은 유지해. | PNG 마스크, 알파 채널, 동일 크기, quality=high |
| I2 | 마스크된 병 라벨 영역만 새 브랜드 라벨로 교체해줘. 병의 유리 질감, 손 위치, 반사광, 배경 심도는 그대로 유지해. | quality=high, PNG |
| I3 | 마스크된 광고판 부분에만 카페 런칭 포스터를 넣어줘. 거리의 원근감, 그림자, 주변 간판 노이즈는 유지하고, 새 포스터가 실제로 붙어 있는 것처럼 보여줘. | quality=high, 원근/광원 유지 명시 |
스타일 전이
| ID | 프롬프트 | 설정 |
|---|---|---|
| S1 | 입력 이미지의 색감, 질감, 붓자국, 노이즈 패턴은 그대로 유지하고, 새로운 피사체로 흰 배경 위를 달리는 오토바이 라이더를 만들어줘. 다른 요소는 추가하지 마. | quality=medium, size=1024x1536 |
| S2 | 입력 포스터의 그래픽 언어를 유지한 채, 같은 스타일의 북커버 시안을 새로 만들어줘. 팔레트, 타이포 인상, 종이 질감은 유지하고 제목만 새 작품으로 바꿔줘. | quality=high, 세로 비율 |
| S3 | 이 가족 사진을 수채화 동화책 스타일로 바꿔줘. 인물 배치와 표정은 유지하고, 배경만 부드러운 그림책 분위기로 정리해줘. | quality=medium, 구도 유지 제약 |
이미지→텍스트 (비전 모델 사용)
| ID | 프롬프트 | 설정 |
|---|---|---|
| T1 | 이 이미지를 한국어로 설명해줘. ① 한 줄 캡션 ② 주요 객체 5개 ③ 이미지 안 텍스트 OCR ④ 불확실한 부분 목록 으로 나눠서 답해. | gpt-5.4 / gpt-4.1-mini, detail=high 또는 original |
| T2 | 이 포스터/슬라이드 이미지에서 모든 제목, 소제목, 숫자, 날짜를 표로 추출해줘. 읽기 어려운 부분은 [추정] 태그를 붙여. | gpt-5.4, 작은 글자 많으면 detail=original |
| T3 | 이 영수증 이미지를 항목명, 수량, 단가, 세금, 총액 JSON으로 변환해줘. 회전되었거나 잘린 부분은 따로 경고해. | gpt-5.4, detail=original |
멀티모달 Q&A
| ID | 프롬프트 | 설정 |
|---|---|---|
| Q1 | 이 진열대 사진을 보고, 가장 먼저 시선을 끄는 제품 3개와 그 이유를 설명해줘. 가격표가 보이면 함께 정리해줘. | gpt-5.4 / gpt-4.1-mini, detail=high |
| Q2 | 이 차트/그래프에서 핵심 추세 3가지, 이상치 1가지, 발표용 한 줄 메시지를 알려줘. 선 스타일이나 색상 구분이 불확실하면 그렇게 말해. | gpt-5.4, detail=original |
| Q3 | 이 공간 사진을 보고 출입구 위치, 안내 표지판, 이동 동선, 장애물 가능성을 질문-답변 형식으로 정리해줘. | gpt-5.4, detail=original |
접근성
| ID | 프롬프트 | 설정 |
|---|---|---|
| A1 | 이 이미지를 시각장애 사용자용으로 설명해줘. ① alt text 1문장 ② 장문 설명 5문장 ③ 안전상 주의할 요소 ④ 이미지 속 글자 요약 으로 구분해. | gpt-5.4, detail=original |
| A2 | 이 배너 이미지를 기준으로 화면낭독기 보조용 설명을 작성해줘. 읽기 순서, 핵심 시각 요소, 텍스트 대비 문제를 알려줘. | gpt-5.4, detail=high |
| A3 | 이 제품 포장 사진에서 제품명, 용량, 사용법, 주의 문구를 접근성용 목록으로 정리해줘. 읽기 어려운 부분은 [추정]으로 표시해. | gpt-5.4, detail=original |
개발자 워크플로
| ID | 프롬프트 | 설정 |
|---|---|---|
| D1 | 같은 주인공 외형을 유지한 4컷 웹툰 1페이지를 만들어줘. 1컷은 지하철, 2컷은 카페, 3컷은 옥상, 4컷은 야경. 얼굴 비율, 헤어스타일, 옷 색상은 반복해서 동일하게 유지해. | Responses API + image_generation, quality=high, 세로 페이지 |
| D2 | 같은 브랜드 톤으로 가로 배너, 정사각형 소셜 포스트, 세로 포스터 3종 세트를 만들어줘. 색상 규칙, 타이포 인상, 제품 사진 스타일은 통일해. | Responses API 멀티턴, size만 바꿔 반복 |
| D3 | 원본 제품 사진의 병 모양과 손 위치, 그림자, 조명은 유지한 채 라벨의 문구만 한국어 출시판 버전으로 교체해줘. | 편집, 필요 시 마스크, quality=high |
출처 안내: 아래 프롬프트는 대부분 OpenAI 공식 프롬프팅 가이드, 이미지 생성 가이드, 비전 가이드, 그리고 제품 릴리스 페이지의 공개 예시를 한국어 실무 상황에 맞게 응용한 것이다. 일부(인페인팅 I2/I3, 스타일 전이 S3, OCR T3, 차트 해석 Q2, 접근성 A1/A2 등)는 공식 문서의 한계·규칙·입력 규격을 근거로 하되 프롬프트 문장 자체는 블로그에서 창작했다. 설정값(
quality,size,detail등)은 모두 공식 문서 권장 범위를 따른다.
개발자 구현 예시
핵심 선택은 단순하다. 한 번 생성/한 번 편집은 Images API, 대화형·반복은 Responses API, 이미지 설명·Q&A·접근성은 비전 모델.
1. 텍스트→이미지 생성 (최소 예시)
gpt-image-2는 기본적으로 base64 이미지를 반환한다. png/jpeg/webp 지원. JPEG는 지연시간에 민감할 때 유리하다.
from openai import OpenAI
import base64

client = OpenAI()

result = client.images.generate(
    model="gpt-image-2",
    prompt=(
        "서울 근교 한옥 스테이 런칭 포스터를 만들어줘. "
        "고급스러운 한국어 타이포그래피, 잔잔한 자연광, "
        "전통 목재 질감, 현대적 편집 디자인."
    ),
    size="1024x1536",
    quality="high",
    output_format="png"
)

image_bytes = base64.b64decode(result.data[0].b64_json)
with open("hanok_poster.png", "wb") as f:
    f.write(image_bytes)
2. 편집/인페인팅
마스크는 알파 채널이 있어야 하고, 원본과 같은 크기여야 한다. gpt-image-2는 투명 배경을 현재 지원하지 않으니 투명성을 기대하는 파이프라인은 분리하는 게 안전하다.
from openai import OpenAI
import base64

client = OpenAI()

result = client.images.edit(
    model="gpt-image-2",
    image=[open("room.png", "rb")],
    mask=open("mask.png", "rb"),
    prompt=(
        "마스크된 영역에만 작은 원목 테이블과 머그컵을 추가해줘. "
        "원래 방의 조명, 카메라 각도, 바닥 그림자, 주변 오브젝트는 유지해."
    ),
    size="1536x1024",
    quality="high",
    output_format="png"
)

image_bytes = base64.b64decode(result.data[0].b64_json)
with open("room_edit.png", "wb") as f:
    f.write(image_bytes)
3. Responses API 멀티턴 편집
이 경로의 장점은 "처음 만든 이미지의 시각 언어를 다음 출력으로 이어가는 것"이다. 품질이 기대와 다를 때는 자동 생성되는 revised_prompt를 로깅해 디버깅하자.
from openai import OpenAI
import base64

client = OpenAI()

# 1차 생성
r1 = client.responses.create(
    model="gpt-5.4",
    input="서울 근교 한옥 스테이용 세로 브로슈어 표지 이미지를 만들어줘.",
    tools=[{
        "type": "image_generation",
        "quality": "high",
        "size": "1024x1536"
    }]
)

call1 = next(o for o in r1.output if o.type == "image_generation_call")

img1 = base64.b64decode(call1.result)
with open("brochure_cover.png", "wb") as f:
    f.write(img1)

# 2차 후속: 같은 톤 유지, 정사각형 소셜 포스트로 전환
r2 = client.responses.create(
    model="gpt-5.4",
    input=[
        {
            "role": "user",
            "content": [{
                "type": "input_text",
                "text": "같은 브랜드 톤과 타이포 인상을 유지한 채, 인스타그램용 정사각형 버전으로 바꿔줘."
            }]
        },
        {
            "type": "image_generation_call",
            "id": call1.id
        }
    ],
    tools=[{
        "type": "image_generation",
        "quality": "high",
        "size": "1024x1024"
    }]
)

call2 = next(o for o in r2.output if o.type == "image_generation_call")
img2 = base64.b64decode(call2.result)
with open("brochure_square.png", "wb") as f:
    f.write(img2)
4. 이미지→텍스트 / 접근성 / Q&A
이건 gpt-image-2가 아니라 비전 가능한 메인라인 모델을 쓴다. 작은 글자·조밀한 UI·OCR 성격 작업에서는 detail="original"이 더 안전하다. 한국어 텍스트 분석은 여전히 완벽하지 않으니 출력 스키마에 "불확실성" 필드를 넣자.
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-5.4",
    input=[{
        "role": "user",
        "content": [
            {
                "type": "input_text",
                "text": (
                    "이 이미지를 한국어로 분석해줘. "
                    "1) alt text 1문장 "
                    "2) 장문 설명 5문장 "
                    "3) OCR 텍스트 목록 "
                    "4) 불확실한 부분 목록 "
                    "형식으로 답해."
                )
            },
            {
                "type": "input_image",
                "image_url": "data:image/jpeg;base64,BASE64_IMAGE_HERE",
                "detail": "original"
            }
        ]
    }]
)

print(response.output_text)
마무리: 창업자 체크리스트
이 릴리스를 보고 내 서비스에 뭘 바꿀지, 여섯 줄로 정리한다.
신규 구축이면
gpt-image-2를 기본값으로. 운영 중인 1.5는 점진 이전.이미지 생성과 이미지 분석을 분리 설계하자. 전자는
gpt-image-2, 후자는gpt-5.4비전 경로.비용은 반드시 내 프롬프트 분포로 재측정. "싸졌다"는 설명만 믿고 예산 짜면 틀린다.
레이아웃 민감 자산은 "생성 + 수작업 마감" 전제로. 포스터·패키지·UI는 아직 한 번에 안 끝난다.
초상·브랜드·저작권 프롬프트 방어선을 기본값으로.
Original design only / No trademarks패턴은 취향이 아니라 리스크 관리다.스테이징에서 기능·과금·출력 일관성을 함께 검증하고 배포. 문서 간 작은 불일치가 실제로 존재한다.
가장 안전한 운영 패턴은 이렇게 요약된다.
생성은
gpt-image-2, 분석은 비전 모델, 멀티턴은 Responses API, 레이아웃 민감 최종 자산은 사람 검수 고정.
이 정도 원칙만 지키면 이번 릴리스는 "재시도 비용이 줄어드는 모델"이 맞다. 그리고 1인 창업자에게 재시도 비용이 줄어든다는 건, 결국 다른 데 쓸 시간이 늘어난다는 뜻이다. 그게 이 릴리스의 진짜 가치다.
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.