

12. 내부 구조 맛보기와 확장 방향
12. 내부 구조 맛보기와 확장 방향
지금까지는 OpenCode를 잘 쓰는 방법에 집중했습니다. 이제 마지막 장에서는 한 걸음 더 들어가 보겠습니다. "왜 이렇게 동작하는가?"를 이해하는 단계입니다.
초보자에게 내부 구조는 처음엔 쓸모없어 보일 수 있습니다. 그냥 로그인 잘 되고, 모델 잘 고르고, 파일 잘 고쳐 주면 된 것 아닌가 싶기 때문입니다. 그런데 실전에서는 딱 그 반대입니다. 정말 도움이 되는 순간은, 문제가 생겼을 때 어디를 의심해야 하는지 아는 순간입니다.
예를 들어 이런 상황이 있습니다.
OpenCode에서는 분명히 대화가 이어지고 있는데, 서버는 상태를 저장하지 않는다고 합니다. 그럼 문맥은 어디서 유지될까요?
또 어떤 요청은 잘 되는데, 어떤 요청은 갑자기 item not found 같은 식으로 깨집니다. 그럼 누가 어떤 형식을 누구에게 맞춰 주는 걸까요?
로그인은 한 번만 했는데도 시간이 지나면 다시 잘 동작합니다. 그럼 토큰은 누가 언제 갈아끼우는 걸까요?
이 장의 핵심은 단순합니다. 플러그인은 "로그인 도우미"가 아니라, OpenCode와 Codex 백엔드 사이의 통역사이자 변환기라는 점입니다.12
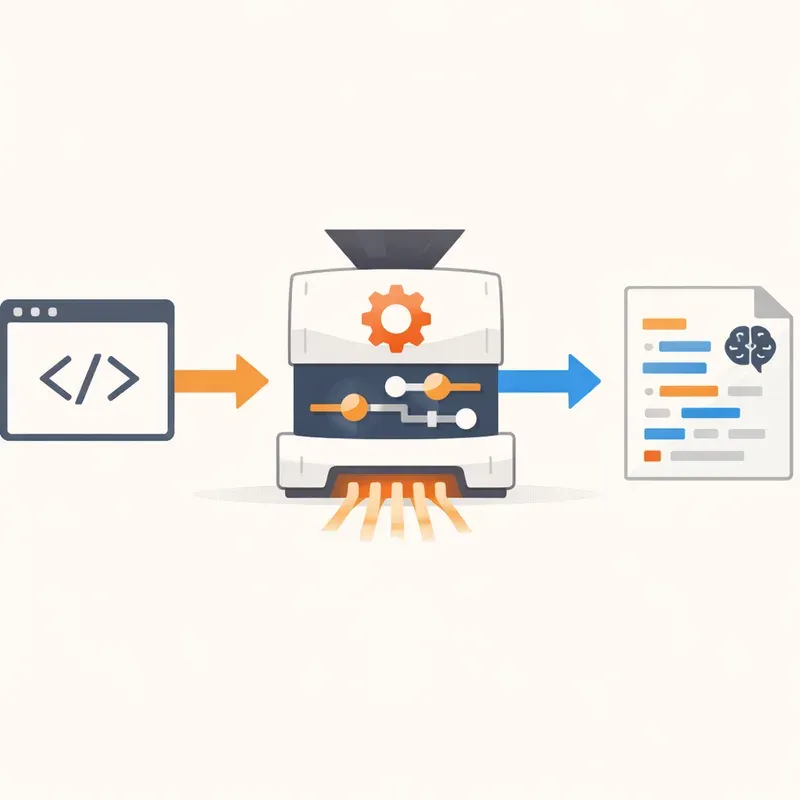
큰 그림부터: 플러그인은 중간 다리다
먼저 전체 구조를 아주 단순하게 그려 보겠습니다.
OpenCode 클라이언트
  → Provider 시스템
    → opencode-openai-codex-auth 플러그인
      → OpenAI Codex 백엔드
겉으로 보기에는 OpenCode가 OpenAI에 바로 요청을 보내는 것처럼 보이지만, 실제로는 중간에 플러그인이 끼어 있습니다. 이 플러그인은 크게 세 가지 일을 합니다.12
OAuth 인증 정보를 읽고, 필요하면 갱신한다.
OpenCode가 만든 요청을 Codex 백엔드가 이해하는 형태로 바꾼다.
스트리밍 응답을 다시 OpenCode가 다루기 쉬운 흐름으로 전달한다.
이걸 초보자 눈높이로 바꾸면 이렇습니다.
OpenCode는 "내가 이런 대화를 했고, 이런 도구를 쓰고 싶다"라고 말합니다.
플러그인은 그 말을 듣고 "좋아, 그런데 Codex 백엔드는 이 표현을 그대로 못 알아들을 수 있으니 내가 문장을 좀 정리해서 전달할게"라고 움직입니다.
그리고 응답이 돌아오면 다시 "이제 이 결과를 OpenCode가 이어서 쓸 수 있게 맞춰 줄게"라고 정리합니다.
즉, 플러그인은 단순 중계기가 아니라 형식 변환을 담당하는 미들웨어입니다. 미들웨어는 쉽게 말해 "중간에서 규칙을 맞춰 주는 층"입니다.2
왜 변환이 필요한가: OpenCode의 말과 Codex 백엔드의 말은 완전히 같지 않다
여기서 가장 중요한 질문이 나옵니다.
"둘 다 AI 요청 아닌가요? 그냥 보내면 안 되나요?"
아쉽게도 그렇지 않습니다. OpenCode 쪽 요청 형식과 Codex 백엔드가 기대하는 형식 사이에는 미묘하지만 치명적인 차이가 있습니다. 대표적으로 두 가지가 문제였습니다.13
첫째는 item_reference 같은 AI SDK 쪽 구성 요소입니다. 이것은 OpenCode/SDK 문맥에서는 의미가 있지만, Codex 백엔드 규격에서는 그대로 쓰기 어렵습니다.
둘째는 메시지 ID입니다. 원래는 각 메시지에 id가 붙어 있어도 자연스러워 보이지만, 이번 플러그인이 쓰는 방식은 stateless라서 서버가 이전 항목을 저장하지 않습니다. 그런데 ID를 그대로 들고 가면 서버는 "이 ID를 가진 예전 항목이 어딨지?" 하고 찾다가 실패할 수 있습니다.13
즉, 문제가 되는 건 "ID가 이상해서"가 아니라, 저장되지 않는 대화 방식에서 저장된 것처럼 참조하려 하기 때문입니다.
이 점을 이해하면 오류 메시지가 훨씬 덜 무섭습니다. 갑자기 이상한 에러가 난 게 아니라, 서로 다른 대화 규칙이 충돌한 것입니다.
핵심 구조 1: 요청은 들어오자마자 바로 정리된다
플러그인 내부에서 요청은 대략 이런 순서로 정리됩니다.12
1) 현재 모델 이름 확인
2) 전역 옵션 + 모델별 옵션 병합
3) input 배열 정리
4) OpenCode 전용 흔적 제거
5) Codex용 instructions와 body 구성
6) OAuth 헤더 붙이기
7) 스트리밍 요청 전송
이 흐름을 초보자 관점에서 다시 풀면 이렇습니다.
먼저 "지금 어떤 모델을 쓰려는지"를 확인합니다. 그리고 전역 설정과 특정 모델 설정을 합칩니다. 그다음 대화 입력 배열을 훑으면서, Codex 백엔드에 맞지 않는 조각을 걷어 냅니다. 마지막으로 Codex 쪽이 기대하는 본문 구조와 헤더를 만든 뒤 전송합니다.12
여기서 중요한 포인트는 하나입니다. OpenCode 요청이 그대로 백엔드에 가지 않는다는 점입니다.
그래서 디버깅할 때도 "내가 프롬프트를 잘못 썼나?"만 보지 말고, "중간 변환에서 어떤 항목이 제거되거나 바뀌었을까?"를 함께 생각해야 합니다.
코드 실습 1: 요청 변환을 눈으로 확인해 보기
직접 원리를 느끼는 가장 쉬운 방법은, 아주 작은 모의 입력을 만들어 변환 전후를 비교해 보는 것입니다. 아래 예시는 학습용으로 단순화한 코드입니다.
const originalInput = [
  { type: "message", role: "developer", content: "You are helpful." },
  { type: "message", role: "user", id: "msg_101", content: "test.txt를 만들어 줘" },
  { type: "item_reference", id: "rs_555" },
  { type: "function_call", id: "fc_1", name: "write", arguments: "{\"path\":\"test.txt\"}" }
]

function transformForCodex(input) {
  return input
    .filter((item) => item.type !== "item_reference")
    .map((item) => {
      const { id, ...rest } = item
      return rest
    })
}

const transformed = transformForCodex(originalInput)

console.log("=== 원본 ===")
console.dir(originalInput, { depth: null })

console.log("=== 변환 후 ===")
console.dir(transformed, { depth: null })
이 파일을 transform-demo.js로 저장하고 실행해 보세요.
node transform-demo.js실행 결과를 보면 감이 옵니다. item_reference는 사라지고, 각 항목의 id도 제거됩니다. 즉, 대화의 내용은 남기되, 상태 저장을 전제로 한 흔적은 지우는 것입니다.
이 한 줄 요약이 정말 중요합니다. 이 플러그인은 문맥을 버리는 것이 아니라, 문맥은 살리고 서버 의존 참조만 지우는 방향으로 움직입니다.13
핵심 구조 2: stateless인데도 대화가 이어지는 이유
이제 가장 헷갈리는 부분으로 들어가 보겠습니다.
서버에 저장하지 않는다면, 어떻게 멀티턴 대화가 성립할까요?
정답은 의외로 단순합니다. 매 요청마다 이전 대화 전체를 다시 보냅니다.13
즉, 세 번째 질문을 보낼 때는 세 번째 질문만 보내는 것이 아니라, 그 전의 사용자 메시지, 어시스턴트 응답, 도구 호출, 도구 결과까지 함께 보냅니다.
턴 1 사용자 질문
턴 1 도구 호출
턴 1 도구 결과
턴 1 응답
턴 2 사용자 질문
턴 2 도구 호출
턴 2 도구 결과
턴 2 응답
턴 3 사용자 질문
이런 식으로 전체 흐름이 다시 전송됩니다.
그래서 stateless를 "기억력이 없다"라고 이해하면 틀립니다. 더 정확히는 서버가 장기 저장소 역할을 하지 않는다에 가깝습니다. 기억은 요청 본문과 로컬 상태를 통해 이어집니다.1
초보자에게는 이렇게 비유하면 쉽습니다.
stateful 대화는 식당 단골처럼 "지난번 주문 기억하시죠?"가 되는 구조입니다.
stateless 대화는 매번 메모장을 들고 가서 "지난번엔 이걸 주문했고, 그다음엔 이걸 추가했고, 오늘은 여기서 이어갈게요"라고 설명하는 구조입니다.
둘 다 대화는 이어질 수 있습니다. 다만 기억의 위치가 다릅니다.
reasoning.encrypted_content는 왜 필요한가
그렇다면 이런 의문이 생깁니다.
"전체 대화를 다 보내면 충분하지 않나요? 왜 또 reasoning.encrypted_content 같은 옵션이 있죠?"
이 값은 단순 채팅 본문만으로는 이어지지 않는 reasoning 관련 맥락을 보존하기 위한 장치입니다. 서버가 세션을 저장하지 않는 환경에서도, 필요한 추론 컨텍스트를 암호화된 형태로 주고받아 다음 턴에서 이어 붙일 수 있게 해 줍니다.13
여기서 핵심은 세 가지입니다.
사람이 읽는 평문 메모가 아니라, 암호화된 형태로 오간다.
클라이언트가 그것을 다음 요청에 다시 포함한다.
덕분에 stateless 구조에서도 reasoning 연결성이 좋아진다.
이걸 너무 어렵게 볼 필요는 없습니다. 그냥 "대화 본문 외에, 모델이 이어서 생각하는 데 필요한 바통 하나를 더 들고 뛴다" 정도로 이해하면 충분합니다.
핵심 구조 3: store:false는 선택이 아니라 사실상 전제다
이 책 앞부분에서도 store: false를 여러 번 봤습니다. 하지만 이제는 이유를 내부 구조 관점에서 이해할 수 있습니다.
이 플러그인이 연결하는 ChatGPT/Codex 백엔드에서는 이 경로에서 store: true가 아니라 store: false가 요구됩니다. 즉, 서버에 대화를 저장하는 방식으로는 맞지 않고, 요청마다 필요한 내용을 다시 보내는 방식이 기본 전제입니다.13
그래서 내부 구조도 여기에 맞춰 설계되어 있습니다.
메시지 ID를 벗겨 내고, item_reference를 필터링하고, 전체 대화 히스토리를 매 요청에 포함시키고, reasoning.encrypted_content를 챙깁니다. 이 모든 동작이 사실은 한 문장으로 연결됩니다.
"서버 저장 없이도 대화가 이어지게 만들기 위한 설계"라는 한 문장입니다.
이 관점이 생기면 설정 파일의 store: false가 더 이상 암기용 값이 아닙니다. 구조 전체를 지탱하는 중심축처럼 보이기 시작합니다.
토큰 갱신은 언제 일어나는가: 조용히, 요청 전에
이제 인증 쪽 내부를 보겠습니다.
많은 초보자가 토큰 갱신을 "로그인 창이 다시 뜨는 것"으로만 생각합니다. 하지만 보통의 자동 갱신은 훨씬 조용하게 일어납니다. 플러그인은 요청을 보내기 전에 현재 OAuth 인증 정보를 확인하고, 만료되었거나 곧 만료될 상태라면 refresh token으로 access token을 새로 받아옵니다.4
즉 흐름은 대략 이렇습니다.
요청 시작
→ 현재 access token 확인
→ 아직 유효하면 그대로 사용
→ 만료되었으면 refresh token으로 재발급 시도
→ 새 access token 저장
→ 실제 API 요청 전송
이 과정이 중요한 이유는, 사용자가 매번 다시 로그인하지 않아도 되기 때문입니다. 그리고 더 중요한 이유는, 문제가 생겼을 때 원인을 나눠 볼 수 있기 때문입니다.
예를 들어 로그인 자체는 정상인데 갑자기 인증 오류가 난다면, 의심할 수 있는 가지가 생깁니다.
access token이 만료되었는데 refresh가 실패했는가
refresh token 자체가 무효가 되었는가
저장된 인증 정보가 깨졌는가
현재 세션이 예전 상태를 잡고 있는가
내부 원리를 모르면 이런 오류가 전부 "로그인이 이상함"으로 보입니다. 하지만 원리를 알면 훨씬 세밀하게 진단할 수 있습니다.45
코드 실습 2: 아주 단순한 토큰 갱신 흐름 만들어 보기
아래 코드는 실제 플러그인 구현이 아니라, 원리를 익히기 위한 작은 예제입니다.
async function ensureValidAccessToken(auth) {
  const now = Date.now()

  if (auth.expires > now) {
    return auth.access
  }

  console.log("access token 만료 → refresh 시도")

  const refreshed = await fakeRefresh(auth.refresh)

  auth.access = refreshed.access
  auth.expires = refreshed.expires

  return auth.access
}

async function fakeRefresh(refreshToken) {
  if (!refreshToken) {
    throw new Error("refresh token이 없습니다")
  }

  return {
    access: "new_access_token_value",
    expires: Date.now() + 60 * 60 * 1000
  }
}

const auth = {
  access: "old_access_token",
  refresh: "refresh_token_value",
  expires: Date.now() - 1000
}

ensureValidAccessToken(auth)
  .then((token) => {
    console.log("사용할 access token:", token)
    console.log("갱신 후 auth:", auth)
  })
  .catch(console.error)
이 예제를 실행하면 "요청 전에 토큰 상태를 확인하고, 필요하면 조용히 갱신한다"는 구조가 머리에 남습니다.
실제 플러그인은 물론 훨씬 더 꼼꼼합니다. 인증 정보 저장, 만료 시각 판단, 갱신 실패 처리, 계정 식별 정보 추출 같은 부분이 더 붙습니다. 하지만 큰 그림은 같습니다.4
응답은 그냥 텍스트 덩어리가 아니라 스트림이다
OpenCode에서 답이 타이핑되듯이 조금씩 나타나는 이유는, 플러그인이 스트리밍 응답을 다루기 때문입니다. 백엔드가 Server-Sent Events, 즉 SSE 형태로 결과를 흘려 보내면 플러그인은 그것을 처리해 OpenCode가 실시간으로 표시할 수 있게 연결합니다.2
초보자에게 SSE는 어려운 용어처럼 보일 수 있습니다. 그냥 "서버가 답을 한 번에 통으로 주지 않고, 조금씩 밀어 보내는 방식"이라고 이해하면 됩니다.
이게 왜 중요하냐면, 디버깅할 때도 차이가 나기 때문입니다.
한 번에 실패하는 요청은 본문 형식 문제일 수 있습니다.
중간까지 나오다가 끊기는 요청은 네트워크, 인증, 응답 처리 쪽 문제일 수 있습니다.
즉, 스트리밍 구조를 이해하면 "어디서 깨졌는지"도 조금 더 잘 보입니다.
실전 디버깅 관점: 어디를 보면 되나
이제 내부 구조를 알았으니, 실전에서 보는 순서도 정리해 봅시다.
문제가 생기면 다음 질문을 순서대로 던져 보세요.
첫째, 인증 전 단계가 깨졌는가입니다. 로그인 자체, 저장된 auth, refresh 가능 여부를 봅니다.45
둘째, 요청 변환 단계가 깨졌는가입니다. 메시지 ID가 남았는지, item_reference가 섞였는지, 모델 옵션이 이상하게 병합됐는지 봅니다.12
셋째, 응답 처리 단계가 깨졌는가입니다. 스트림이 오다가 끊기는지, 아예 시작도 안 되는지 봅니다.2
넷째, OpenCode 바깥 환경이 문제인가입니다. 캐시, 로그, 플러그인 충돌, 로컬 저장 데이터 문제를 확인합니다.5
이 순서가 좋은 이유는, 막연한 불안을 구조화해 주기 때문입니다. 그냥 "안 된다"가 아니라 "어느 층이 안 되는가"로 바뀝니다.
코드 실습 3: 로그를 켜고 실제 요청 흐름 관찰하기
실전 사용자로 넘어가는 가장 좋은 방법은 로그를 보는 습관을 들이는 것입니다. OpenCode 자체 로그와 플러그인 디버깅 로그를 함께 보면, 어디서 문제가 생기는지 훨씬 빨리 알 수 있습니다.15
터미널에서 OpenCode 로그 레벨을 올려 실행해 보세요.
opencode --log-level DEBUG리눅스나 macOS에서는 기본 로그 디렉터리도 확인할 수 있습니다.
ls ~/.local/share/opencode/log/플러그인 쪽에서 요청 변환을 더 자세히 보고 싶다면, 문서에서 안내하는 요청 로깅 환경 변수를 사용해 볼 수 있습니다.1
ENABLE_PLUGIN_REQUEST_LOGGING=1 opencode이 상태에서 간단한 명령을 하나 실행해 보세요.
opencode run "hello.txt 파일을 만들고 Hello OpenCode를 써 줘" --model=openai/gpt-5.2-codex --variant=medium이후 로그에서 확인할 포인트는 이런 것들입니다.
입력 항목에서 ID 제거 로그가 보이는가
item_reference가 필터링되었는가최종 body에
store: false가 들어가는가include에reasoning.encrypted_content가 포함되는가
이걸 한 번만 직접 보면, 책에서 읽은 내용이 갑자기 손에 잡히는 구조로 바뀝니다.
향후 확장 포인트 1: 새 모델 패밀리 대응
플러그인의 첫 번째 확장 포인트는 모델 대응입니다.
이미 앞 장에서 봤듯이 OpenCode는 모델과 variant를 유연하게 다룹니다. 플러그인도 이 구조 위에서 모델 이름을 정규화하고, 각 모델에 맞는 reasoning/text 옵션을 병합합니다.12
그래서 앞으로 새 Codex 계열이나 GPT 계열이 등장하면, 확장의 중심은 보통 이런 지점이 됩니다.
새 모델 이름을 어떤 내부 ID로 연결할지
어떤 variant를 기본 제공할지
reasoning 범위를 어디까지 허용할지
verbosity 기본값을 어떻게 잡을지
즉, 모델 추가는 단순 문자열 추가가 아니라 요청 변환 규칙과 기본 옵션 설계까지 포함하는 작업입니다.
향후 확장 포인트 2: 프롬프트 브리지 개선
이 플러그인은 OpenCode와 Codex 사이의 프롬프트 차이를 메우는 브리지 역할도 합니다. OpenCode 쪽 시스템 프롬프트를 그대로 넘기지 않고, 필요한 부분만 보존하거나 Codex용 bridge prompt를 붙여서 두 세계의 규칙을 맞춥니다.12
이 부분은 앞으로도 계속 확장될 가능성이 큽니다.
왜냐하면 OpenCode 쪽 도구 호출 방식, 에이전트 구조, AGENTS 문맥은 진화하고, Codex 쪽 기대 형식도 변할 수 있기 때문입니다. 둘 사이의 "의미 번역기"가 더 똑똑해질 여지가 많습니다.
쉽게 말하면, 앞으로 플러그인은 단순 포맷 변환기를 넘어 행동 규칙 번역기에 가까워질 수 있습니다.
향후 확장 포인트 3: 도구 호출 정리와 보존 전략
내부 문서에서 특히 흥미로운 부분 중 하나가 orphan tool output 처리입니다. 원래는 짝이 맞지 않는 도구 결과가 들어오면 요청이 깨질 수 있는데, 이 플러그인은 그런 출력을 그냥 버리지 않고 가능한 한 문맥을 살리는 방향으로 처리합니다.13
이건 앞으로도 중요한 확장 지점입니다.
OpenCode 생태계는 플러그인, 커스텀 툴, skills, 다양한 에이전트 구조로 점점 넓어지고 있습니다. 즉, "정형화된 도구 호출만 온다"라고 가정하기 어려워집니다.6
그래서 앞으로 더 좋아질 수 있는 부분은 이런 것들입니다.
도구 출력 타입이 더 다양해질 때의 호환성
custom tool 결과를 더 안정적으로 Codex 형식에 매핑하는 방법
문맥 보존과 오류 회피 사이의 균형 조정
이런 지점이 강해질수록, 플러그인은 "간단한 개인 설정 패키지"가 아니라 진짜 호환성 레이어로 성장합니다.
향후 확장 포인트 4: 더 똑똑한 인증 관리
현재 구조에서 토큰 갱신은 요청 전에 유효성을 확인하고 필요할 때 refresh하는 흐름이 핵심입니다.4
그런데 생태계 전체를 보면, 앞으로는 더 정교한 인증 관리도 생각해 볼 수 있습니다. 예를 들어 다음과 같은 방향입니다.
만료 직전 미리 선제 갱신
동시에 여러 요청이 들어올 때 refresh 중복 방지
계정 상태 이상 감지 후 재인증 유도
더 친절한 사용량/제한 안내 메시지
실제로 다른 OpenCode OAuth 플러그인들에서는 중복 refresh 방지나 선제 갱신 같은 패턴도 적극적으로 보입니다.7
물론 지금 당장 초보자가 구현할 일은 아닙니다. 하지만 이런 구조를 알고 있으면, 나중에 "왜 어떤 플러그인은 더 안정적인가?"를 비교해 볼 수 있습니다.
향후 확장 포인트 5: OpenCode 플러그인 생태계와의 결합
OpenCode는 플러그인 훅, 커스텀 툴, shell 환경 주입, 세션 이벤트 처리 같은 확장 지점을 이미 제공합니다.6
즉, opencode-openai-codex-auth는 혼자만 존재하는 섬이 아니라 더 큰 생태계 안의 한 조각입니다.
앞으로 실전 사용자가 시도해 볼 만한 방향은 충분합니다.
인증 플러그인 + 알림 플러그인 조합
인증 플러그인 + 토큰 사용량 분석 플러그인 조합
특정 프로젝트에서 shell.env 훅으로 환경 정리
세션 이벤트 기반 로깅/추적 자동화
중요한 점은, 인증 플러그인이 끝이 아니라 시작점이라는 것입니다. 연결이 성공한 뒤부터는 운영 도구, 메모리, 알림, 보안 가드, 서브에이전트 같은 주변 장치를 붙여 자기만의 작업 환경을 만들 수 있습니다.6
단순 사용자에서 실전 사용자로 넘어가는 기준
이제 마지막으로, 이 장의 핵심 감각을 한 문장씩 정리해 보겠습니다.
OpenCode 요청은 그대로 Codex 백엔드에 가지 않습니다. 중간에서 플러그인이 형식을 바꿉니다.12
이 구조는 store: false라는 stateless 전제를 중심으로 돌아갑니다. 그래서 전체 대화 히스토리를 매번 보내고, ID와 item_reference 같은 상태 의존 흔적은 정리합니다.13
reasoning.encrypted_content는 저장 없는 대화에서도 reasoning 맥락을 이어 주는 바통 역할을 합니다.13
OAuth 토큰은 요청 직전에 확인되고, 필요하면 refresh token으로 자동 갱신될 수 있습니다.4
그리고 앞으로의 확장 방향은 모델 추가, 브리지 프롬프트 개선, 도구 호환성 강화, 더 똑똑한 인증 관리, OpenCode 플러그인 생태계와의 결합으로 이어질 수 있습니다.26
결국 내부 원리를 안다는 것은 개발자 흉내를 내는 것이 아닙니다. 문제를 구조적으로 볼 수 있게 되는 것입니다.
이제 여러분은 "OpenCode에 OpenAI OAuth를 붙였다"에서 멈추지 않습니다.
어떤 요청이 왜 성공하는지, 왜 가끔 실패하는지, 어디를 보면 힌트를 찾을 수 있는지 아는 단계로 넘어왔습니다.
바로 그 지점에서, 단순 사용자는 실전 사용자가 됩니다.
참고
1Plugin Architecture & Technical Decisions
2Core Architecture numman-ali/opencode-openai-codex-auth DeepWiki
3opencode-openai-codex-auth/docs/development/ARCHITECTURE.md at main · GitHub
4Token Management & Refresh numman-ali/opencode-openai-codex-auth DeepWiki
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.