


18. 다음 단계로 가는 길: 템플릿, 테스트, CMake, 동시성
18. 다음 단계로 가는 길: 템플릿, 테스트, CMake, 동시성
지금까지 왔다면, 이제 여러분은 C++의 입구를 지나 본격적인 복도로 들어선 셈이다. 변수와 함수, 클래스와 STL, 스마트 포인터와 현대 문법까지 한 번 훑었다면 이제 이런 질문이 생긴다.
"그래서 다음엔 뭘 배우면 되죠?"
이 질문은 아주 중요하다. 초보 단계를 마친 뒤에 길을 잃는 사람이 의외로 많기 때문이다. 문법은 어느 정도 익혔는데, 그다음부터는 갑자기 세상이 넓어진다. 템플릿도 있고, 테스트도 있고, CMake도 있고, 멀티스레딩도 있다. 이름만 들어도 살짝 어려워 보이지만, 사실 이 주제들은 서로 따로 노는 것이 아니라 한 프로젝트 안에서 자연스럽게 만난다.
예를 들어 보자. 재사용 가능한 자료구조를 만들다 보면 템플릿이 필요해진다. 기능이 많아지면 테스트가 필요해진다. 파일이 늘어나면 빌드 과정을 정리할 CMake가 필요해진다. 프로그램이 더 빠르게 반응해야 하거나 여러 일을 동시에 처리해야 하면 동시성이 등장한다. 즉, 이 장의 네 가지 주제는 "다음 단계"이면서 동시에 "실전으로 가는 문"이다.
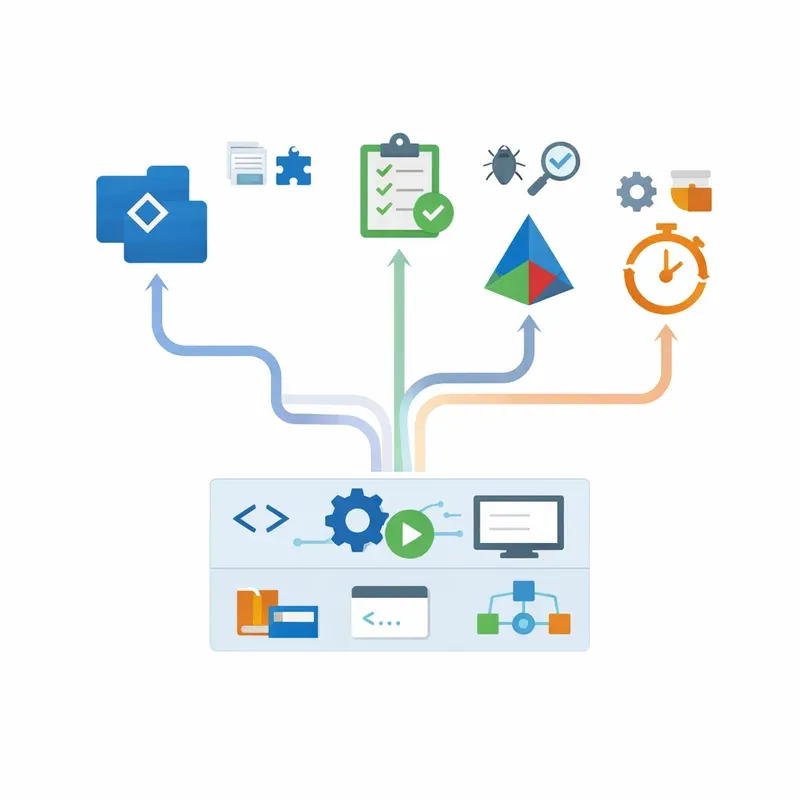
초급 이후의 지도부터 보자
초보 이후의 학습은 보통 다음 네 방향으로 뻗어 나간다.
템플릿: 타입에 묶이지 않는 재사용 가능한 코드를 만드는 법
테스트: 코드가 계속 올바르게 동작하는지 자동으로 확인하는 법
CMake: 프로젝트를 빌드하고 연결하고 테스트하는 과정을 정리하는 법
동시성: 여러 작업을 동시에 다루는 프로그램을 만드는 법
이 순서를 미리 알고 있으면 학습이 끊기지 않는다. 마치 등산로의 다음 이정표를 보는 것과 비슷하다. 지금 오르막이 조금 힘들어도, 어디로 가는지는 알고 걷게 된다.
템플릿: 타입이 바뀌어도 로직은 같을 때
C++에서 템플릿은 제네릭 프로그래밍, 즉 "타입에 독립적인 코드"를 만들기 위한 핵심 장치다. 같은 로직을 int용, double용, string용으로 매번 다시 쓰는 대신, 하나의 설계도를 만들고 컴파일러가 필요한 타입 버전을 만들어 주게 하는 방식이다. STL의 vector, map, sort 같은 도구들도 이런 템플릿 위에 세워져 있다.1
가장 간단한 예는 최대값 함수다.
template <typename T>
T myMax(T a, T b) {
    return (a > b) ? a : b;
}
이 함수는 int에도, double에도, char에도 사용할 수 있다.
#include <iostream>
#include <string>

int main() {
    std::cout << myMax(3, 7) << 'n';
    std::cout << myMax(2.5, 1.8) << 'n';
    std::cout << myMax(std::string("cat"), std::string("dog")) << 'n';
}
여기서 중요한 감각은 이것이다. 템플릿은 "실행 중에 타입을 바꾸는 마법"이 아니라, "컴파일 시점에 타입별 코드를 만들어 내는 설계도"라는 점이다.1
이 개념을 이해하면 왜 템플릿이 빠른지도 납득할 수 있다. 런타임에 타입을 검사하며 우회하는 것이 아니라, 컴파일러가 미리 필요한 코드를 만들어 두기 때문이다.
템플릿은 함수에만 쓰지 않는다. 클래스에도 아주 많이 쓴다.
template <typename T>
class Box {
private:
    T value;

public:
    Box(T v) : value(v) {}

    T getValue() const {
        return value;
    }
};
이제 Box<int>도 만들 수 있고, Box<std::string>도 만들 수 있다.
Box<int> intBox(10);
Box<std::string> strBox("hello");
이쯤에서 초보자가 꼭 알아야 할 함정도 하나 있다. 템플릿은 만능처럼 보이지만, 실제로는 "그 타입이 필요한 연산을 지원할 때만" 잘 동작한다. myMax()는 내부에서 >를 쓰므로, 비교 연산이 가능한 타입이어야 한다. 그러니 템플릿은 무조건 아무 타입에나 되는 것이 아니라, "이 정도는 할 수 있는 타입"을 전제로 한다.
또 하나 자주 만나는 실수는 템플릿 정의를 .cpp 파일로 분리했다가 링크 에러를 만나는 경우다. 템플릿은 컴파일 시점에 인스턴스화되기 때문에, 보통 정의까지 헤더에서 볼 수 있어야 한다.2
// MyMax.h
#pragma once

template <typename T>
T myMax(T a, T b) {
    return (a > b) ? a : b;
}
그리고 문자열 리터럴도 조심하자.
myMax("cat", "dog");이 코드는 사람이 기대하는 "사전 순 비교"가 아니라, 문자열 내용이 아닌 포인터 주소 비교로 이어질 수 있다. 이런 경우에는 std::string으로 감싸는 습관이 안전하다.
템플릿을 처음 공부할 때는 욕심내지 않는 것이 좋다. 메타프로그래밍, SFINAE, 복잡한 타입 특성까지 한 번에 가면 머리가 하얘질 수 있다. 먼저 함수 템플릿, 클래스 템플릿, 여러 타입 매개변수, 기본 템플릿 인자, 간단한 특수화 정도까지 익히면 아주 좋다. 그다음에야 "아, STL이 왜 이런 모양이었는지"가 보이기 시작한다.
테스트: 돌아가는 코드보다 믿을 수 있는 코드로
초보 때는 프로그램이 한 번 잘 실행되면 뿌듯하다. 물론 그것도 훌륭하다. 하지만 프로젝트가 조금만 커지면 문제가 생긴다. 어제 고친 부분이 오늘 다른 기능을 망가뜨릴 수 있다. 이럴 때 필요한 것이 테스트다.
테스트는 "내 코드가 맞는지 자동으로 확인하는 작은 프로그램"이라고 생각하면 된다. 테스트를 갖추면 리팩터링이 덜 무섭고, 기능을 추가해도 기존 동작이 깨졌는지 빨리 확인할 수 있다. 자동화된 테스트는 회귀 버그, 즉 예전에 되던 것이 다시 안 되는 문제를 잡는 데 특히 강하다.3
처음부터 거대한 테스트 프레임워크를 들고 올 필요는 없다. 가장 단순한 테스트는 그냥 실행해서 성공이면 0, 실패면 0이 아닌 값을 반환하는 작은 프로그램이다. CTest는 바로 이런 방식의 테스트를 돌려 준다.3
예를 들어 이런 테스트 프로그램을 만들 수 있다.
#include <iostream>
#include <cstdlib>

int add(int a, int b) {
    return a + b;
}

int main() {
    if (add(2, 3) != 5) {
        std::cerr << "Test failed: add(2, 3) should be 5n";
        return EXIT_FAILURE;
    }

    std::cout << "Test passedn";
    return EXIT_SUCCESS;
}
이제 CMake에서 테스트를 등록하면 된다.
enable_testing()

add_executable(add_test add_test.cpp)
add_test(NAME AddFunctionTest COMMAND add_test)
CMake의 enable_testing()과 add_test()를 사용하면 CTest가 테스트를 수집하고 실행할 수 있다. 기본적으로 테스트 프로그램이 정상 실행되고 예외 없이 끝나며 종료 코드가 0이면 성공으로 본다.3
여기서 한 단계 더 나아가면 GoogleTest 같은 테스트 프레임워크를 쓰게 된다. GoogleTest는 EXPECT_EQ, EXPECT_TRUE 같은 읽기 쉬운 문법을 제공하고, 실패했을 때 어떤 값이 달랐는지도 보기 좋게 보여 준다. CMake와 함께 쓸 때는 FetchContent로 가져오고, gtest_discover_tests()로 테스트를 자동 등록하는 방식이 널리 쓰인다.4
아주 간단한 예는 이런 모습이다.
#include <gtest/gtest.h>

int add(int a, int b) {
    return a + b;
}

TEST(AddTest, BasicCase) {
    EXPECT_EQ(add(2, 3), 5);
}
CMake 쪽은 이런 식이다.
include(FetchContent)
FetchContent_Declare(
  googletest
  URL https://github.com/google/googletest/archive/03597a01ee50ed33e9dfd640b249b4be3799d395.zip
)
FetchContent_MakeAvailable(googletest)

enable_testing()

add_executable(add_gtest add_gtest.cpp)
target_link_libraries(add_gtest GTest::gtest_main)

include(GoogleTest)
gtest_discover_tests(add_gtest)
처음에는 테스트가 느리게 느껴질 수도 있다. "아니, 기능 하나 만들기도 바쁜데 테스트까지요?"라는 마음이 든다. 그런데 이상하게도, 조금 지나면 테스트가 시간을 아껴 준다. 디버깅에 쓰던 시간이 줄어들기 때문이다. 코드는 사람의 기억보다 오래 버티고, 테스트는 사람의 자신감보다 더 정확하다.
CMake: 프로젝트를 사람 손 대신 정리해 주는 관리자
초보 시절에는 보통 파일 하나를 컴파일하는 것으로 충분하다.
g++ main.cpp -o app하지만 파일이 늘어나고, 라이브러리가 생기고, 테스트가 추가되면 이 방식은 금방 버거워진다. 컴파일 옵션, include 경로, 링크 대상, 빌드 순서를 사람이 매번 직접 관리하기 어렵기 때문이다. 그래서 등장하는 것이 빌드 시스템이고, C++ 세계에서 가장 널리 만나는 도구 중 하나가 CMake다.
CMake를 처음 보면 주문서처럼 보일 수 있다. 하지만 핵심은 의외로 단순하다. "무엇을 만들고, 무엇과 연결할지"를 적는 것이다.
가장 기본적인 형태는 이런 식이다.
cmake_minimum_required(VERSION 3.14)
project(MyApp)

set(CMAKE_CXX_STANDARD 17)
set(CMAKE_CXX_STANDARD_REQUIRED ON)

add_executable(MyApp main.cpp)
라이브러리를 분리하면 더 C++ 프로젝트답게 보인다.
add_library(mathlib math.cpp)
add_executable(MyApp main.cpp)
target_link_libraries(MyApp PRIVATE mathlib)
여기서 중요한 습관은 "타깃 중심으로 생각하기"다. 예전에는 전역 옵션을 잔뜩 뿌리는 방식이 많았지만, 현대 CMake에서는 target_link_libraries, target_include_directories, target_compile_features처럼 각 타깃에 필요한 정보를 붙이는 방식이 더 깔끔하다.
그리고 CMake의 진짜 힘은 테스트와도 잘 연결된다는 점이다. 빌드 시스템은 어떤 실행 파일이 어디 생기는지 알고 있으므로, 테스트를 등록하고 돌리는 과정도 자연스럽게 붙는다. 그래서 실전 C++ 프로젝트에서는 "코드 작성 → CMake로 빌드 → CTest로 테스트"가 한 흐름으로 이어진다.3
초보 이후에 CMake를 공부할 때는 다음 정도를 목표로 잡으면 충분하다.
add_executable,add_library,target_link_libraries를 이해하기헤더와 소스 파일을 여러 폴더로 나누어 관리하기
enable_testing,add_test로 테스트 실행하기외부 라이브러리를
FetchContent나 패키지 방식으로 연결해 보기
CMake를 배우면 단순히 "빌드가 된다"를 넘어 "프로젝트 구조를 설명할 수 있다"는 단계로 올라간다. 이 차이는 꽤 크다.
동시성: 한 번에 하나만 하던 프로그램을 넘어서
이제 마지막으로, 이름만 들어도 조금 긴장되는 주제인 동시성을 보자. 동시성은 여러 작업이 겹쳐 진행되도록 프로그램을 구성하는 개념이고, 병렬성은 실제로 여러 코어나 프로세서에서 동시에 실행되어 속도를 높이는 쪽에 더 가깝다. 둘은 겹치지만 완전히 같은 말은 아니다.5
C++는 C++11부터 표준 차원에서 스레드, 뮤텍스, 조건 변수, 메모리 모델 같은 동시성 도구를 제공하기 시작했다.5 이 말은 곧, 운영체제별 세부 구현을 너무 깊게 파지 않아도 표준 라이브러리만으로 기본적인 멀티스레드 프로그램을 작성할 수 있다는 뜻이다.
가장 단순한 예는 std::thread다.
#include <iostream>
#include <thread>

void hello() {
    std::cout << "Hello from threadn";
}

int main() {
    std::thread t(hello);
    t.join();
}
여기서 join()은 아주 중요하다. 스레드가 끝날 때까지 기다려 주는 동작이다. 이걸 빼먹으면 메인 함수가 먼저 끝나 버리거나, 관리되지 않은 스레드 때문에 문제가 생길 수 있다.
하지만 진짜 어려움은 스레드를 만드는 데 있지 않다. 여러 스레드가 같은 데이터를 함께 만질 때 문제가 시작된다. 두 개 이상의 스레드가 같은 메모리에 동시에 접근하고, 그중 하나라도 쓰기를 한다면 데이터 레이스가 발생할 수 있다. 이런 상황은 정의되지 않은 동작으로 이어질 수 있다.5
예를 들어 이런 코드는 위험하다.
#include <iostream>
#include <thread>

int counter = 0;

void work() {
    for (int i = 0; i < 100000; ++i) {
        ++counter;
    }
}

int main() {
    std::thread t1(work);
    std::thread t2(work);

    t1.join();
    t2.join();

    std::cout << counter << 'n';
}
겉보기에는 결과가 200000이어야 할 것 같지만, 실제로는 아닐 수 있다. 이유는 ++counter가 한 번에 완전히 끝나는 마법의 연산이 아니기 때문이다. 읽고, 더하고, 쓰는 과정 사이에 다른 스레드가 끼어들 수 있다.
이럴 때 std::mutex와 std::lock_guard를 사용한다.
#include <iostream>
#include <thread>
#include <mutex>

int counter = 0;
std::mutex m;

void work() {
    for (int i = 0; i < 100000; ++i) {
        std::lock_guard<std::mutex> lock(m);
        ++counter;
    }
}

int main() {
    std::thread t1(work);
    std::thread t2(work);

    t1.join();
    t2.join();

    std::cout << counter << 'n';
}lock_guard는 스코프를 벗어날 때 자동으로 잠금을 해제해 주므로, lock()과 unlock()을 직접 짝 맞추는 것보다 훨씬 안전하다.
또 어떤 경우에는 뮤텍스 대신 std::atomic이 더 적합할 수 있다. 단순한 카운터 증가처럼 작은 공유 상태를 다룰 때는 원자적 연산이 편리하다. 반대로 여러 값의 관계를 함께 지켜야 하거나 복잡한 불변 조건이 있다면 뮤텍스가 더 자연스럽다.
그리고 동시성 학습의 다음 단계에서는 std::condition_variable, std::future, std::promise, std::async도 만나게 된다. 특히 future와 async는 "나중에 결과를 받을 작업"을 표현할 때 유용하다.6
중요한 것은, 동시성은 무조건 빨라지는 마법이 아니라는 점이다. 잘못 쓰면 오히려 더 느려지고, 더 어렵고, 더 불안정해진다. 그래서 초보 이후 단계에서는 다음 원칙을 꼭 기억하는 것이 좋다.
먼저 단일 스레드로 올바르게 만들기
병목이 실제로 있는지 확인한 뒤 동시성을 도입하기
공유 데이터를 최소화하기
잠금 범위를 짧게 유지하기
가장 단순한 도구부터 사용하기
락프리 프로그래밍 같은 고급 주제는 분명 흥미롭지만, 그것은 나중 문제다. 먼저 thread, mutex, lock_guard, atomic, future 정도를 단단히 익히는 것이 훨씬 중요하다.
무엇부터 공부하면 좋을까
이제 실제 학습 순서를 추천해 보자. 욕심을 조금만 줄이면 길이 꽤 또렷해진다.
첫째, 템플릿 기초를 익혀 보자. 함수 템플릿과 클래스 템플릿을 이해하고, vector<int>와 vector<string>이 왜 같은 틀에서 나오는지 감을 잡는 것이 목표다. 직접 myMax, Box, Pair, 간단한 Stack<T> 정도를 구현해 보면 좋다.
둘째, 작은 프로젝트에 테스트를 붙여 보자. 계산 함수, 문자열 처리 함수, 간단한 클래스 하나를 골라 테스트 프로그램을 만들고, CTest로 등록해서 ctest 한 번에 확인되는 흐름을 만들어 보자. 이 단계에서 이미 "코드 품질을 다루는 개발자" 느낌이 난다.
셋째, CMake로 프로젝트 구조를 정리해 보자. src, include, tests 폴더를 나누고, 실행 파일과 라이브러리 타깃을 분리해 보자. GoogleTest도 한 번 붙여 보면 더 좋다. 여기까지 오면 깃허브에 올려도 제법 그럴듯한 프로젝트가 된다.
넷째, 동시성은 작은 예제로 시작하자. 스레드 생성, join, 공유 카운터, 뮤텍스, 원자 변수, 생산자-소비자 같은 아주 작은 문제를 다뤄 보자. 처음부터 대규모 서버를 흉내 낼 필요는 없다. 작은 실험이 오히려 더 잘 배운다.
추천 미니 프로젝트
배운 내용을 한 번에 묶고 싶다면, 다음 같은 작은 프로젝트가 좋다.
템플릿 기반
Stack<T>또는Queue<T>라이브러리 만들기문자열 유틸리티 라이브러리를 만들고 GoogleTest로 테스트 붙이기
CMake로 라이브러리, 앱, 테스트를 분리한 프로젝트 구성하기
여러 파일을 읽어 단어 수를 세는 프로그램을 만들고, 파일별 처리를 스레드로 나누어 보기
이런 프로젝트는 크지 않지만, 템플릿·테스트·CMake·동시성을 한 번씩 모두 만져 볼 수 있다. 바로 이 연결 경험이 초보를 넘는 데 큰 도움이 된다.
이 장을 마치며
C++를 초보 수준에서 한 단계 더 끌어올리는 비밀은 "더 어려운 문법을 더 많이 외우는 것"에 있지 않다. 오히려 반대다. 코드를 더 일반적으로 만들고, 더 안전하게 검증하고, 더 체계적으로 빌드하고, 필요할 때만 더 똑똑하게 동시에 실행하는 법을 배우는 데 있다.
템플릿은 재사용을 넓혀 준다. 테스트는 신뢰를 쌓아 준다. CMake는 프로젝트를 정리해 준다. 동시성은 프로그램의 가능성을 넓혀 준다.
그러니 이제부터의 목표는 단순하다. "문법을 아는 사람"에서 "프로젝트를 만들어 끝까지 관리할 수 있는 사람"으로 넘어가는 것이다. 그리고 바로 그 지점에서, 여러분의 C++ 학습은 다시 재미있어지기 시작한다.
참고
1Templates in C++ - GeeksforGeeks
22026 C++ Templates: Beginner's Complete Guide to Generic Programming
4Quickstart: Building with CMake | GoogleTest
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.