


숫자를 다루는 프로그램도 중요하지만, 현실의 프로그램은 생각보다 훨씬 많은 글자를 다룹니다. 이름, 주소, 전화번호, 이메일, 상품 코드, 날짜, 검색어, 채팅 내용까지 대부분 텍스트입니다. 그래서 문자열을 잘 다루는 사람은 "코드를 짤 줄 아는 사람"에서 한 걸음 더 나아가, 실생활 데이터를 다룰 줄 아는 사람이 됩니다.
이번 장에서는 문자열을 잘라 보고, 다듬어 보고, 필요한 조각만 뽑아 보는 연습을 합니다. 말하자면 텍스트를 칼질하고 손질하는 법을 배우는 시간입니다. 처음엔 단순해 보여도, 여기서 배운 기술은 나중에 파일 처리, 웹 데이터 정리, 자동화, 심지어 데이터 분석에서도 계속 등장합니다.
문자열은 왜 이렇게 자주 나올까
우리는 이미 문자열이 글자의 묶음이라는 것을 배웠습니다. 그런데 문자열은 단순히 "문장 저장용"이 아닙니다. 때로는 숫자처럼 생긴 정보도 문자열로 들어옵니다. 예를 들어 "010-1234-5678", "2026-03-30", "A102-B" 같은 값은 겉보기에 규칙이 있는 데이터지만, 파이썬 입장에서는 우선 문자열입니다.
문자열을 잘 다루면 이런 일을 할 수 있습니다.
전화번호에서 가운데 번호만 뽑기
이메일 주소에서 아이디와 도메인 나누기
사용자 입력의 앞뒤 공백 지우기
대소문자를 통일해서 비교하기
한 문장을 단어 목록으로 나누기
즉, 문자열 처리는 단순한 꾸미기가 아니라 데이터를 쓸 만한 상태로 만드는 작업입니다.
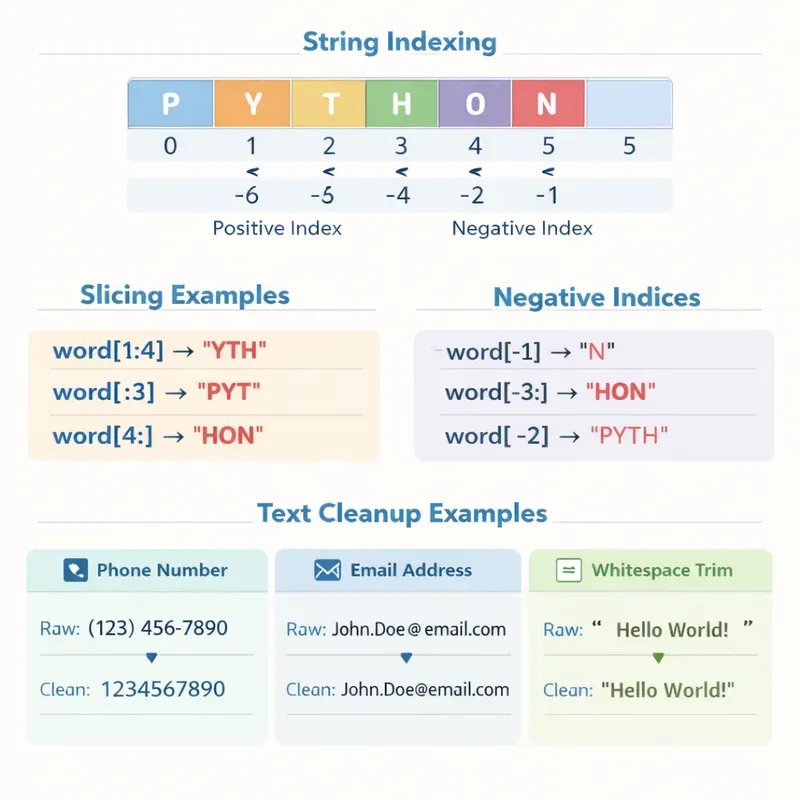
슬라이싱: 필요한 부분만 똑 떼어 오기
문자열에서 한 글자만 꺼내는 것은 인덱싱이고, 여러 글자를 한 번에 잘라 오는 것은 슬라이싱입니다. 슬라이싱의 기본 모양은 다음과 같습니다.1
문자열[start:end:step]여기서 기억할 핵심은 아주 간단합니다.
start는 시작 위치입니다. 포함됩니다.end는 끝 위치입니다. 포함되지 않습니다.step은 몇 칸씩 건너뛸지 정합니다.
이제 직접 보겠습니다.
text = "Python"

print(text[0:2])
print(text[2:6])
결과는 다음과 같습니다.
Py
thontext[0:2]는 0번부터 시작해서 2번 직전까지 가져오므로 P, y가 나옵니다. 처음에는 끝번호가 왜 포함되지 않는지 낯설 수 있지만, 익숙해지면 오히려 훨씬 계산하기 편합니다.1
처음이나 끝은 생략할 수 있다
시작이나 끝이 뻔할 때는 생략할 수 있습니다.1
text = "Python"

print(text[:2])   # 처음부터 2번 직전까지
print(text[2:])   # 2번부터 끝까지
print(text[:])    # 전체 복사
결과:
Py
thon
Python
이 문법은 정말 자주 씁니다. 특히 앞부분만 검사하거나, 뒷부분만 잘라낼 때 편리합니다.
음수 인덱스로 뒤에서부터 세기
문자열은 뒤에서부터도 셀 수 있습니다. -1은 마지막 글자, -2는 뒤에서 두 번째 글자입니다. 슬라이싱에서도 똑같이 쓸 수 있습니다.12
text = "Python"

print(text[-1])
print(text[-3:])
print(text[:-2])
결과:
n
hon
Pyth
이 방식은 문자열 길이를 몰라도 마지막 부분을 뽑을 수 있어서 편합니다. 예를 들어 파일 확장자, 상품 코드의 마지막 세 글자, 전화번호 뒷자리 같은 것을 다룰 때 특히 유용합니다.
filename = "report.pdf"
print(filename[-4:])
결과:
.pdfstep으로 건너뛰기
세 번째 값 step은 몇 칸 간격으로 가져올지 정합니다.2
text = "PythonProgramming"

print(text[::2])
print(text[1::2])
이 코드는 한 글자씩 건너뛰며 가져옵니다. step=2라고 생각하면 이해하기 쉽습니다.
가장 유명한 활용은 문자열 뒤집기입니다.
text = "Python"
print(text[::-1])
결과:
nohtyP[::-1]은 "처음과 끝은 알아서, 한 칸씩 뒤로 가며 가져와라"라는 뜻입니다.2
슬라이싱은 실전에서 이렇게 쓴다
문법만 보면 조금 딱딱하지만, 실제로는 아주 생활밀착형입니다.
phone = "010-1234-5678"

first = phone[:3]
middle = phone[4:8]
last = phone[9:]

print(first)
print(middle)
print(last)
결과:
010
1234
5678
날짜도 쉽게 나눌 수 있습니다.
date = "2026-03-30"

year = date[:4]
month = date[5:7]
day = date[8:]

print(year, month, day)
이제 슬라이싱은 더 이상 문법이 아니라 작은 가위처럼 느껴질 것입니다.
문자열은 바뀌지 않는다
문자열을 다룰 때 꼭 기억해야 할 성질이 하나 있습니다. 문자열은 변경 불가능한 값입니다. 즉, 메서드를 써도 원본 문자열이 직접 바뀌지 않고, 새로운 문자열이 만들어집니다.3
text = "python"
text.upper()
print(text)
결과는 이렇게 나옵니다.
python처음 보는 사람은 종종 놀랍니다. upper()를 썼는데 왜 그대로일까요? 이유는 간단합니다. 결과를 다시 저장하지 않았기 때문입니다.
text = "python"
text = text.upper()
print(text)
이제 결과는 PYTHON입니다.
문자열 메서드를 쓸 때는 항상 마음속으로 이렇게 생각하면 좋습니다.
"원본을 고치는 것이 아니라, 고친 결과를 새로 받는 것이다."
자주 쓰는 문자열 메서드
문자열 메서드는 텍스트를 다듬는 작은 공구 상자 같습니다. 망치 하나만 있어도 못은 박을 수 있지만, 공구가 많을수록 일이 빨라지듯 문자열 메서드도 그렇습니다.
공백 없애기: strip
사용자 입력에는 앞뒤 공백이 자주 섞입니다. 눈에는 잘 안 보이지만 비교를 망치는 주범입니다.
name = "  민지  "
print(name.strip())
결과:
민지왼쪽만 지우는 lstrip(), 오른쪽만 지우는 rstrip()도 있습니다.3
text = "   hello   "
print(text.lstrip())
print(text.rstrip())
대소문자 바꾸기: lower, upper, title
영문 데이터는 대소문자가 섞여 들어오는 일이 많습니다. 이럴 때는 한쪽으로 통일해 두면 비교가 쉬워집니다.3
email = "[email protected]"
print(email.lower())
print(email.upper())
print("python programming".title())
결과:
admin@example.com
ADMIN@EXAMPLE.COM
Python Programming
대소문자를 무시하고 비교하고 싶다면 보통 둘 다 lower()로 맞춘 뒤 비교합니다.
answer = "YES"
print(answer.lower() == "yes")
글자 바꾸기: replace
특정 부분을 다른 글자로 바꾸고 싶을 때는 replace()를 씁니다.3
text = "I like Java"
new_text = text.replace("Java", "Python")
print(new_text)
결과:
I like Python하이픈을 없애거나, 쉼표를 공백으로 바꾸는 일도 쉽습니다.
phone = "010-1234-5678"
clean_phone = phone.replace("-", "")
print(clean_phone)
결과:
01012345678나누기와 다시 합치기: split, join
split()은 문자열을 잘라 리스트로 바꾸고, join()은 리스트를 다시 문자열로 이어 붙입니다.4
text = "사과,바나나,포도"
fruits = text.split(",")
print(fruits)
결과:
['사과', '바나나', '포도']반대로 다시 합칠 수도 있습니다.
fruits = ["사과", "바나나", "포도"]
result = " / ".join(fruits)
print(result)
결과:
사과 / 바나나 / 포도이 조합은 데이터 가공에서 정말 자주 등장합니다. 한 줄 텍스트를 나눠서 손질한 뒤, 다시 보기 좋게 합치는 식입니다.
찾기와 검사하기: find, startswith, endswith, isdigit
문자열에 특정 글자가 있는지 찾거나, 특정 규칙을 만족하는지 검사할 때도 메서드가 유용합니다.4
text = "[email protected]"

print(text.find("@"))
print(text.startswith("python"))
print(text.endswith(".com"))
print("12345".isdigit())
print("12a45".isdigit())find()는 찾은 위치를 숫자로 알려 주고, 없으면 -1을 돌려줍니다. startswith()와 endswith()는 시작과 끝을 검사할 때 읽기 쉬워서 많이 씁니다. isdigit()은 문자열이 숫자로만 되어 있는지 확인할 때 유용합니다.
문자열과 리스트를 함께 쓰면 훨씬 강해진다
문자열 처리는 혼자보다 리스트와 함께 있을 때 더 강해집니다. 예를 들어 이름 목록이 한 줄 문자열로 들어왔다고 해 봅시다.
names = "철수, 영희, 민수, 지우"
parts = names.split(",")

print(parts)
결과:
['철수', ' 영희', ' 민수', ' 지우']문제는 공백입니다. 이런 데이터는 보기엔 괜찮아 보여도 실제로는 공백이 섞여 있습니다. 그래서 하나씩 strip()을 적용해 주면 훨씬 깔끔해집니다.
names = "철수, 영희, 민수, 지우"
parts = names.split(",")

name1 = parts[0].strip()
name2 = parts[1].strip()
name3 = parts[2].strip()
name4 = parts[3].strip()

print(name1)
print(name2)
print(name3)
print(name4)
이 예제는 조금 수작업 같아 보이지만, 문자열 정리의 핵심 사고를 잘 보여 줍니다.
먼저 나눈다.
필요한 부분을 다듬는다.
필요하면 다시 합친다.
이 흐름은 앞으로도 계속 등장합니다.
간단한 데이터 정리 패턴 익히기
이제부터는 "문자열을 조작한다"는 느낌보다 "지저분한 데이터를 정리한다"는 느낌으로 보겠습니다. 실제 텍스트 데이터는 대개 공백이 들쭉날쭉하고, 대소문자가 섞여 있고, 불필요한 문자가 들어 있습니다. 그래서 정리의 첫걸음은 공백 제거, 표기 통일, 불필요한 문자 치환입니다.5
패턴 1: 사용자 입력 정리하기
raw_name = "   pYtHon learner   "
clean_name = raw_name.strip().lower()
print(clean_name)
결과:
python learner메서드를 연달아 붙여 쓰는 것을 메서드 체이닝이라고 생각하면 됩니다. 앞의 결과를 바로 뒤에서 이어 받아 처리하는 방식입니다.
패턴 2: 들쭉날쭉한 공백 정리하기
앞뒤 공백만 지우는 것으로는 부족할 때가 있습니다. 문장 중간 공백이 여러 개일 수도 있기 때문입니다.
text = "파이썬    은   재미있다"
clean_text = " ".join(text.split())
print(clean_text)
결과:
파이썬 은 재미있다split()을 아무 인수 없이 쓰면 공백 기준으로 나누면서 여러 개의 공백도 알아서 정리해 줍니다. 그리고 join()으로 다시 한 칸 공백으로 합치면 깔끔한 문장이 됩니다.5
패턴 3: 전화번호 숫자만 남기기
phone = "010-1234-5678"
phone = phone.replace("-", "")
print(phone)
print(phone.isdigit())
결과:
01012345678
True
이렇게 하면 숫자로만 이루어진 전화번호인지 검사하기 쉬워집니다.
패턴 4: 이메일에서 아이디와 도메인 나누기
email = "[email protected]"
at = email.find("@")

user_id = email[:at]
domain = email[at + 1:]

print(user_id)
print(domain)
결과:
student
example.com
여기에는 슬라이싱과 find()가 함께 쓰였습니다. 바로 이런 순간이 문자열 공부의 재미가 살아나는 부분입니다. 작은 도구 두 개만 합쳐도 꽤 똑똑한 처리가 가능합니다.
자주 하는 실수
문자열 파트에서 초보자가 자주 헷갈리는 부분도 미리 짚고 가겠습니다.
슬라이싱의 끝 위치가 포함된다고 착각하는 실수
strip()을 썼는데 변수에 다시 저장하지 않는 실수split()의 결과가 문자열이 아니라 리스트라는 사실을 놓치는 실수숫자처럼 보이는 문자열과 진짜 숫자를 혼동하는 실수
영문 비교를 하면서 대소문자를 통일하지 않는 실수
예를 들어 이런 코드는 의도와 다르게 동작합니다.
text = " python "
text.strip()
print(text)
출력은 여전히 공백이 남은 문자열입니다. 왜냐하면 strip()의 결과를 다시 저장하지 않았기 때문입니다.
text = " python "
text = text.strip()
print(text)
이렇게 해야 원하는 결과가 나옵니다.
작은 실전: 한 줄 회원 정보 정리하기
이제 배운 내용을 모아 간단한 데이터 정리를 해 보겠습니다. 다음 문자열에는 이름, 나이, 이메일이 쉼표로 묶여 있지만 공백도 들쭉날쭉하고 대소문자도 제각각입니다.
raw = " 김파이썬 , 17 , [email protected] "우리가 하고 싶은 일은 다음과 같습니다.
이름 앞뒤 공백 제거
나이를 숫자로 바꾸기
이메일을 소문자로 통일하기
코드는 이렇게 쓸 수 있습니다.
raw = "  김파이썬 , 17 , [email protected]  "

parts = raw.split(",")

name = parts[0].strip()
age = int(parts[1].strip())
email = parts[2].strip().lower()

print("이름:", name)
print("나이:", age)
print("이메일:", email)
결과:
이름: 김파이썬
나이: 17
이메일: python@example.com
이 예제는 아주 작지만, 실제 데이터 정리의 핵심을 거의 다 담고 있습니다. 데이터를 나누고, 공백을 지우고, 형식을 통일하고, 필요하면 자료형까지 바꿉니다. 실전의 많은 작업이 사실 이 흐름의 반복입니다.
연습해 보면 더 빨리 익는다
아래 문제는 직접 손으로 쳐 보면 좋습니다.
"2026-03-30"에서 연, 월, 일을 각각 잘라 출력해 보기" Hello Python "을hello python으로 바꿔 보기"apple,banana,grape"를 리스트로 나눈 뒤" | "로 다시 합쳐 보기"abc123","123456"에isdigit()을 적용해 결과 비교해 보기"[email protected]"에서 아이디와 도메인을 나눠 보기
문자열은 눈으로 읽을 때보다 손으로 직접 자르고 바꿔 볼 때 훨씬 빨리 익습니다. 특히 슬라이싱은 인덱스를 한 칸씩 바꿔 가며 실험해 보면 감이 금방 잡힙니다.
마무리
이번 장에서는 문자열을 단순한 글자 묶음이 아니라, 가공할 수 있는 데이터로 바라보는 연습을 했습니다.
핵심만 다시 정리해 보면 이렇습니다.
슬라이싱은
문자열[start:end:step]형태로 사용한다.슬라이싱에서 끝 위치는 포함되지 않는다.
음수 인덱스를 쓰면 뒤에서부터 셀 수 있다.
문자열 메서드는 원본을 직접 바꾸지 않고 새 결과를 돌려준다.
strip(),lower(),replace(),split(),join()은 정말 자주 쓴다.문자열을 잘 다루면 지저분한 입력값도 깔끔한 데이터로 바꿀 수 있다.
이제 여러분은 텍스트를 그냥 읽는 단계를 넘어서, 원하는 모양으로 손질하는 단계에 들어섰습니다. 다음 장에서 함수를 배우면, 이런 문자열 정리 코드를 필요한 만큼 묶어서 재사용할 수 있게 됩니다. 그때부터 코드는 더 짧아지고, 더 똑똑해집니다.
참고
2Mastering Python String Slicing: A Comprehensive Guide for Beginners
4Mastering Python String Methods: A Comprehensive Guide for Beginners
이 노트는 보도·비평·교육·연구 목적으로 작성되었습니다. 저작권 문의가 있으시면 에서 알려주세요.